인코딩을 선택하여 보스-허바드 동역학 시뮬레이션하기
이 가이드는 해밀토니안을 작성하는 것부터 시간 발전된 사이트 밀도를 정확한 기준값과 비교하는 것까지, 1차원 보스-허바드 모델의 시간 동역학을 위한 회로를 구성합니다. 이 방식이 흥미로운 이유는 하나의 아이디어 때문입니다.
회로를 구성할 때 보손-큐비트 인코딩을 선택하지 마세요. 회로는 보손 모드로 구성하고, 그 모드가 큐비트가 되는 방식은 transpiler가 결정하도록 하세요.
보손의 경우 인코딩을 거의 항상 뒤로 미뤄야 합니다. 보손 모드는 임의의 많은 입자를 가질 수 있으므로 그 포크(Fock) 공간은 무한 차원이며, 먼저 절단(truncation) (유지할 점유 준위의 수)를 정하기 전에는 어떤 인코딩도 존재하지 않습니다. 코드에서 절단은 모드가 가질 수 있는 최대 점유수 max_occupation 로 주어지므로, 준위 를 유지하는 모드는 max_occupation = 2이고 입니다.
따라서 절단은 물리가 아니라 인코딩의 매개변수이며, 바꿔 가며 살펴보고 싶은 매개변수입니다. 너무 작으면 답이 틀리고, 너무 크면 회로가 불필요하게 넓어집니다. 인코딩을 transpile 시점으로 미루면 회로, 해밀토니안, 그룹화를 바꾸지 않고도 절단을 바꿔 가며 스윕할 수 있습니다.
연산자 데이터 구조는 연산자 가이드, 인코딩과 사용자 정의 매퍼 작성 방법은 매퍼 가이드, 전체에서 언급되는 transpiler 단계는 transpilation 가이드를 참고하세요.
절단과 그 비용
모드를 개 준위로 절단하면 유지된 가장 높은 준위에서 정준 교환 관계가 깨집니다 [1]. 따라서 어떤 인코딩도 대수의 동형 사상이 아니며, 보손 인코딩은 상태와 절단된 부분공간 안에서 작용하는 연산자를 사상합니다. 이후의 모든 내용에서 두 가지 결과가 중요합니다.
-
는 초기 상태뿐 아니라 동역학이 도달할 수 있는 점유수의 상한이어야 합니다.
-
사상은 정규 순서와 교환되지 않으므로, 해밀토니안을 정규 순서 형태로 정의할지 한 번 정하고 일관되게 유지하세요.
매퍼 가이드에서 이 결함을 유도하고 두 가지 결과를 실행 가능한 코드로 보여 줍니다.
1. 해밀토니안
결합(bond) 이 있는 격자 위의 보스-허바드 모델은 다음과 같습니다.
여기서 입니다. 상호작용은 한 사이트에 있는 보손의 쌍을 세므로, 사이트가 입자를 동시에 두 개 가질 수 있어야 합니다. 정규 순서로 쓰면 이며, 이후에는 이 형태를 사용합니다.
기하 구조는 에지 리스트로만 들어가므로 체인에만 국한된 것은 없습니다.
>>> from qiskit_bosons.operators import BosonOperator, ann, cre
>>>
>>> def bose_hubbard(edges, num_sites, tunneling, interaction):
...     """Build the normal-ordered Bose-Hubbard Hamiltonian on an arbitrary lattice."""
...     terms = {}
...     for i, j in edges:
...         terms[(cre(i), ann(j))] = -tunneling
...         terms[(cre(j), ann(i))] = -tunneling
...     for i in range(num_sites):
...         # U/2 * n_i (n_i - 1), already normal-ordered
...         terms[(cre(i), cre(i), ann(i), ann(i))] = 0.5 * interaction
...     return BosonOperator.from_dict(terms)
>>>
>>> num_sites = 4
>>> edges = [(i, i + 1) for i in range(num_sites - 1)]
>>> hamiltonian = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 10
먼저 확인할 만한 성질이 두 가지 있습니다. 가 유니터리가 되려면 해밀토니안이 에르미트여야 하고, 해밀토니안은 전체 보손 수를 보존합니다.
>>> hamiltonian.is_hermitian()
True
>>> hamiltonian.conserves_particle_number()
True
이제 보손에 관한 질문입니다. 이 연산자는 몇 개의 준위를 요구할까요?
>>> hamiltonian.max_occupation()
2
상호작용 항은 한 모드에 생성 연산자를 두 번 적용하므로, 이 항이 작용하려면 모드가 보손을 두 개 가질 수 있어야 합니다. 즉 최대 점유수가 2이며, 이것이 LevelSpec이 max_occupation으로 받는 값입니다. 점유수 를 유지하는 모드는 개의 준위를 가지므로, max_occupation >= 2는 과 같은 요구 조건입니다.
이것은 하한일 뿐입니다. 연산자를 한 번 적용한 결과에서 나온 값이며, 시간 발전에서 반복 적용하면 더 멀리 도달할 수 있습니다. 확실히 너무 작은 컷오프는 배제하지만, 이 모델과 상태에서 컷오프가 얼마나 커야 하는지는 6단계에서 확정합니다. mode_occupations()는 모드별 하한을 각각 알려 주며, 모드별 컷오프는 이 값과 비교합니다.
2. 사상 전에 그룹화
시간 발전은 트로터 분해로 근사하며, 해밀토니안을 어떻게 분할하느냐에 따라 합성에 전달되는 내용이 달라집니다. 두 가지 고려 사항이 같은 방향을 가리킵니다.
첫째는 물리적인 이유입니다. 개별 호핑 항 는 에르미트가 아닙니다. 쌍 만 에르미트입니다. 에르미트가 아닌 단일 항으로 발전시키면 연산이 유니터리가 아니며, 사상된 연산자는 PauliEvolutionGate가 거부하는 복소 계수를 갖게 됩니다. 따라서 각 결합의 두 호핑 항은 함께 있어야 합니다.
둘째는 효율성입니다. 모든 온사이트 상호작용 항은 점유수 기저에서 대각이고 서로 교환하므로 하나의 그룹을 공유하여 함께 합성할 수 있습니다. 공통 사이트를 건드리지 않는 결합들도 마찬가지입니다. 체인에서는 한 칸 건너뛴 결합들이 그런 집합입니다. 결합 0과 2는 서로 떨어진 모드 쌍에 작용하므로 호핑 항이 교환하여 한 그룹을 공유할 수 있고, 결합 1은 자체 그룹을 이룹니다. 따라서 짝수 결합과 홀수 결합을 묶으면 그룹이 세 개 필요하고, 결합마다 그룹을 하나씩 두면 네 개가 필요합니다. 그룹이 적으면 인자도 적어지고 회로도 더 얕아집니다. max_occupation = 2에서 그레이 코드를 쓰면 2큐비트 깊이가 139 대신 95입니다. 어떤 결합이 그룹을 공유할 수 있는지는 격자가 결정하므로, 분할을 여기에서 선택하는 것입니다.
groups 속성이 그 결정을 회로로 전달합니다. 그룹화된 연산자에 대한 Evolution 게이트는 그룹당 하나의 하위 시간 발전으로 분해됩니다. 분할은 격자 구조가 아직 보이는 보손 수준에서 선택되며, 사상 과정에서도 그대로 유지됩니다. 그룹화가 통과해야 하는 검사는 그룹화 가이드에서 다룹니다.
>>> def group_of(actions, edges):
...     """Assign each term to the even bonds, the odd bonds, or the on-site group."""
...     creations = sorted(mode for action, mode in actions if action)
...     annihilations = sorted(mode for action, mode in actions if not action)
...     if creations == annihilations:
...         return 2  # diagonal: the on-site interaction group
...     bond = tuple(sorted(set(creations) | set(annihilations)))
...     return edges.index(bond) % 2  # bonds 0 and 2 share a group, bond 1 has its own
>>>
>>> hamiltonian.groups = [group_of(actions, edges) for actions, _ in hamiltonian.iter_terms()]
>>> hamiltonian.num_groups()
3
모든 그룹은 그 자체로 에르미트여야 하며, 앞의 짝 짓기가 이를 보장합니다. groups_are_hermitian()은 한 번의 호출로 모든 그룹을 검사합니다.
>>> from qiskit_bosons.operators.terms import groups_are_hermitian
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
각 그룹에 무엇이 들어 있는지 보려면 그룹을 분리하세요.
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(f"group {index}: {len(group)} terms, hermitian={group.is_hermitian()}")
group 0: 4 terms, hermitian=True
group 1: 2 terms, hermitian=True
group 2: 4 terms, hermitian=True
짝수-홀수 그룹화는 하나의 선택이며, 대안은 쉽게 측정할 수 있습니다. 모든 결합에 그룹을 하나씩 주면 그룹이 네 개 필요하고, 같은 회로의 2큐비트 깊이가 더 늘어납니다. 깊이는 max_occupation = 2에서 그레이 코드로 회로를 낮춘 뒤에 센 값이며, 이는 4단계에서 설명합니다.
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution
>>> from qiskit_bosons.mappers import LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> def two_qubit_depth(operator):
...     """The two-qubit depth of one evolution under ``operator``, lowered with the Gray code."""
...     probe = BosonicCircuit(num_sites)
...     probe.append(Evolution(num_sites, operator, time=0.4), probe.modes)
...     pass_manager = generate_preset_occupation_pass_manager(LevelSpec(2, "gray"))
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(probe.decompose())
...     return lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
>>>
>>> per_bond = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> per_bond.groups = [
...     len(edges) if sorted(m for a, m in actions if a) == sorted(m for a, m in actions if not a)
...     else edges.index(tuple(sorted({m for _, m in actions})))
...     for actions, _ in per_bond.iter_terms()
... ]
>>> per_bond.num_groups(), two_qubit_depth(per_bond)
(4, 139)
>>> hamiltonian.num_groups(), two_qubit_depth(hamiltonian)
(3, 95)
3. 보손 회로
회로에 없는 것에 주목하세요. 절단도, 인코딩도, 큐비트 수도 없습니다. 이 회로는 네 개의 보손 모드에 작용합니다.
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution, InitializeModes
>>>
>>> total_time = 0.4
>>> occupation = [1, 1, 0, 0]  # one boson on each of the first two sites
>>>
>>> circuit = BosonicCircuit(num_sites)
>>> circuit.append(InitializeModes(occupation), circuit.modes)
>>> circuit.append(Evolution(num_sites, hamiltonian, time=total_time), circuit.modes)
>>> dict(circuit.count_ops())
{'InitializeModes': 1, 'Evolution': 1}

와이어는 큐비트가 아니라 보손 모드입니다. InitializeModes는 플래그가 아니라 정수를 받는다는 점에 유의하세요. 모드는 임의의 수의 보손을 가질 수 있으므로 포크 상태는 점유수의 리스트입니다.
한 번의 decompose()로 2단계의 그룹화가 그룹당 하나의 게이트로 바뀝니다.
>>> decomposed = circuit.decompose()
>>> dict(decomposed.count_ops())
{'Evolution': 3, 'InitializeModes': 1}
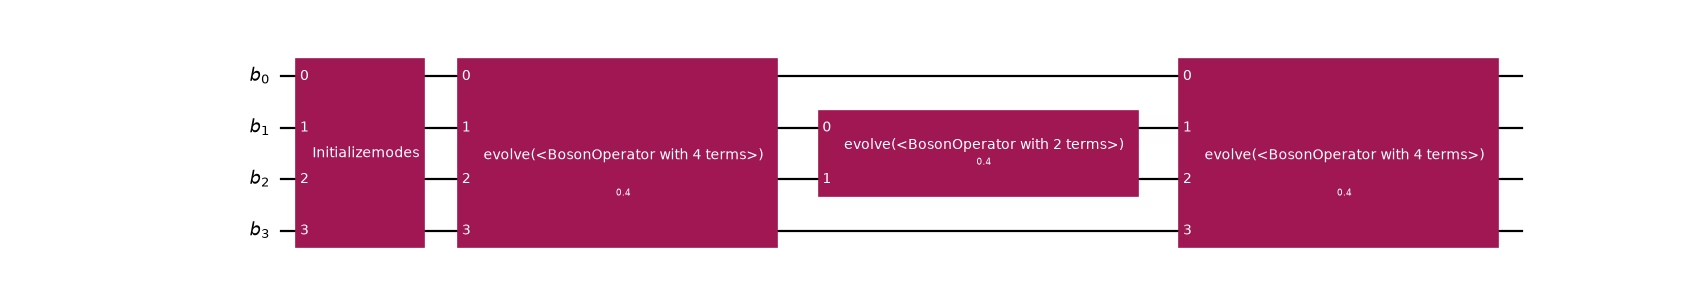
첫 번째 그룹은 모드 0과 1, 모드 2와 3의 결합을 포함하므로 해당 게이트는 네 모드 전체에 걸쳐 있으며, 온사이트 그룹도 마찬가지입니다. 가운데 결합은 모드 1과 2에 대한 자체 게이트를 가집니다.
이 분해를 건너뛰면 그룹화는 그냥 무시됩니다. 분할을 수행하는 방법은 게이트의 synthesis이며 기본값은 BosonicLieTrotter입니다. 다른 방법은 보손 공간에서 Evolution 게이트 합성하기에서 볼 수 있습니다.
4. transpile 시점에 인코딩 선택
여기가 이점이 드러나는 부분입니다. 같은 회로를 인자 하나만 바꿔서 네 가지 서로 다른 LevelEncoding 값으로 네 번 낮춥니다. LevelSpec은 인코딩을 모든 모드의 절단과 짝지으며, 다음 프리셋은 그 하나의 사양에서 레이아웃, 상태 준비, 연산자 사상을 도출합니다(LevelSpec으로 절단 기술하기 참조). "gray" 같은 문자열은 LevelEncoding이 들어갈 수 있는 곳이면 어디서나 허용됩니다.
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.mappers import LevelEncoding, LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> max_occupation = 2  # the largest occupation per mode, so d = max_occupation + 1 = 3 levels
>>>
>>> encodings = (
...     LevelEncoding.UNARY_PROJECTED,
...     LevelEncoding.UNARY_UNPROJECTED,
...     LevelEncoding.STANDARD_BINARY,
...     LevelEncoding.GRAY,
... )
>>> for encoding in encodings:
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     pass_manager.qubit = PassManager()  # keep the circuit as the pipeline synthesized it
...     qubit_circuit = pass_manager.run(decomposed)
...     basis = qubit_circuit.decompose(reps=6)
...     two_qubit = basis.depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"{encoding!s:18s} qubits={qubit_circuit.num_qubits:2d}  2q-depth={two_qubit:4d}")
unary_projected    qubits=12  2q-depth= 645
unary_unprojected  qubits=12  2q-depth= 383
standard_binary    qubits= 8  2q-depth= 218
gray               qubits= 8  2q-depth=  95
이 수치는 자연스러운 추측과 어긋납니다. 유너리 인코딩은 모드당 개의 큐비트를 쓰고 압축 코드는 개를 쓰는데, 에서는 압축 코드가 두 측면 모두에서 앞섭니다. 큐비트가 더 적고 얽힘 게이트도 훨씬 적습니다. 두 유너리 변형은 레이아웃이 아니라 내보내는 연산자가 다릅니다. LevelEncoding.UNARY_PROJECTED는 모드의 큐비트 하나 건너 하나마다 사영 연산자를 가지므로 네 가지 중 시간 발전 비용이 가장 크고, LevelEncoding.UNARY_UNPROJECTED는 사영 연산자를 빼고 원-핫 부분공간에서 그것과 일치합니다. 매퍼 가이드에서 두 연산자를 나란히 보여 주고, 호핑 항에서 그레이 코드가 표준 이진(SB)보다 나은 이유를 설명합니다.
Sawaya 등도 같은 순서를 보고합니다 [2].
유너리 코드는 더 많은 큐비트가 필요하지만 연산은 더 적은 경향이 있음에도, 큐비트 수와 연산 수 모두에서 SB 또는 그레이 코드가 더 효율적인 경우가 많다
이들의 결론은 최적의 코드가 해밀토니안과 에 따라 달라진다는 것이며, 이는 선택을 회로에 고정하지 않아야 한다는 가장 강력한 근거입니다.
레벨 인코딩에서는 모드 하나가 여러 큐비트에 걸치므로 큐비트 레지스터가 모드 레지스터보다 넓습니다. 프리셋은 LevelSpec에서 레지스터 너비를 도출하는 OccupationB2QLayout을 사용합니다. 프리셋이 실행하는 단계는 transpilation 가이드에서 차례로 설명합니다.
5. 정확한 동역학과 비교하여 검증
앞의 단계들만으로는 회로가 올바르다는 것이 입증되지 않습니다. 이를 위해 시간 발전 후의 사이트 밀도 을, 인코딩된 해밀토니안에서 계산한 정확한 기준값과 비교하세요.
기준값은 회로가 작동하는 것과 같은 절단된 공간에서 계산해야 합니다. 절단되지 않은 계산과 비교하면 트로터 오차와 절단 오차가 뒤섞이는데, 이 둘은 서로 다르며 구분해서 볼 가치가 있기 때문입니다(포크 공간 절단하기 참조).
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp, Statevector
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_bosons.mappers.library import occupation_encoding
>>>
>>> def sparse_matrix(operator, encoding):
...     """Map a bosonic operator and hand back a sparse qubit matrix."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     observable = occupation_encoding(operator, spec)
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def fock_index(occupation, encoding):
...     """The computational basis index encoding a product Fock state."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     return sum(
...         encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets)
...     )
>>>
>>> def densities(state, encoding):
...     """The per-site boson number <n_m> of an encoded state vector."""
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         matrix = sparse_matrix(number, encoding)
...         out.append(float((state.conj() @ (matrix @ state)).real))
...     return out
이것들이 준비되었으니, 절단된 공간에서의 정확한 시간 발전은 다음과 같습니다.
>>> encoding = LevelEncoding.GRAY
>>> num_qubits = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
>>>
>>> initial = np.zeros(2**num_qubits, dtype=complex)
>>> initial[fock_index(occupation, encoding)] = 1.0
>>>
>>> evolved_exact = expm_multiply(
...     -1j * total_time * sparse_matrix(hamiltonian, encoding), initial
... )
>>> reference = densities(evolved_exact, encoding)
>>> for site, value in enumerate(reference):
...     print(f"site {site}: {value:.6f}")
site 0: 0.993834
site 1: 0.858853
site 2: 0.141309
site 3: 0.006004
보손은 점유된 체인의 끝에서 빈 끝 쪽으로 퍼지며, 두 보손은 보존됩니다.
>>> bool(np.isclose(sum(reference), 2.0))
True
이제 회로입니다. 앞의 기준값은 initial에서 직접 만들었으므로, 이와 비교하는 회로에는 시간 발전만 있어야 합니다. InitializeModes 게이트는 이미 준비된 상태를 다시 준비하기 때문입니다.
>>> from qiskit_bosons.circuit.library.synthesis import BosonicLieTrotter
>>>
>>> def trotter_densities(steps, encoding):
...     """Site densities after `steps` first-order Trotter steps of the grouped evolution."""
...     circuit = BosonicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, hamiltonian, time=total_time, synthesis=BosonicLieTrotter(reps=steps)
...         ),
...         circuit.modes,
...     )
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     qubit_circuit = pass_manager.run(circuit.decompose())
...     # decompose BEFORE evolving: see the warning that follows
...     basis = qubit_circuit.decompose(reps=6)
...     state = np.asarray(Statevector(initial).evolve(basis).data)
...     return densities(state, encoding)
>>>
>>> for steps in (1, 2, 4, 8, 16):
...     error = max(
...         abs(a - b) for a, b in zip(trotter_densities(steps, encoding), reference)
...     )
...     print(f"steps={steps:2d}  max density error = {error:.4f}")
steps= 1  max density error = 0.0843
steps= 2  max density error = 0.0389
steps= 4  max density error = 0.0183
steps= 8  max density error = 0.0088
steps=16  max density error = 0.0043
스텝 수가 두 배가 되면 오차가 절반이 되며, 이는 1차 곱 공식의 특징입니다. 이는 차이가 트로터 오차이며 인코딩이 충실하다는 증거입니다.
반복은 게이트의 synthesis에서 나오며, 그룹화가 아직 남아 있는 보손 공간에서 트로터 분해를 수행합니다. 각 스텝은 모든 그룹을 한 번씩 적용하고, 스텝들이 차례로 이어집니다. 이는 reps > 1인 LieTrotter를 큐비트 수준의 합성 플러그인에 넘기는 것과 다릅니다. 그 경우 각 그룹이 이미 자체 PauliEvolutionGate이므로, 공식은 그룹 안의 항만 세분하고 그룹들을 교차 배치하지 않습니다. 그룹들은 서로 교환하지 않으므로 바깥쪽 트로터 스텝이 하나만 남고, reps가 아무리 커도 그 오차는 줄어들지 않습니다. 보손 공간에서 Evolution 게이트 합성하기에서 두 방식을 비교하고 더 높은 차수도 다룹니다.
앞의 decompose() 호출은 필수입니다. evolve()는 PauliEvolutionGate의 정확한 정의를 사용하며 곱 공식을 완전히 건너뜁니다. 분해되지 않은 회로로 검증하면 일부러 잘못 만든 합성에서도 거의 완벽한 일치를 보게 됩니다. 또한 분해되지 않은 회로는 밀집 연산자를 구성해야 하는 반면, 분해된 회로는 게이트를 하나씩 적용합니다. 다른 시뮬레이터는 게이트를 다르게 처리할 수 있으므로 이 검사는 시뮬레이터에 따라 다르지만, 하드웨어에서는 항상 분해된 형태가 필요합니다.
마지막으로 핵심 검사입니다. 물리는 어떤 인코딩을 선택했는지에 의존하면 안 됩니다.
>>> def exact_densities(encoding):
...     """Exact truncated-space densities, computed under a given encoding."""
...     width = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
...     start = np.zeros(2**width, dtype=complex)
...     start[fock_index(occupation, encoding)] = 1.0
...     evolved = expm_multiply(
...         -1j * total_time * sparse_matrix(hamiltonian, encoding), start
...     )
...     return densities(evolved, encoding)
>>>
>>> all(
...     bool(np.allclose(exact_densities(name), reference, atol=1e-10))
...     for name in encodings
... )
True
큐비트 수, 파울리 구조, 회로 깊이는 모두 다르지만 물리 결과는 소수점 열 자리까지 일치합니다. 인코딩은 구현상의 선택이며, 그래서 transpiler의 몫입니다. 두 유너리 변형은 시뮬레이션된 상태가 원-핫 부분공간에 머무르기 때문에 여기서 일치하며, 그 바깥에서는 달라질 것입니다.
6. 절단은 수렴 매개변수
마지막 단계는 보손에만 해당합니다. 지금까지는 max_occupation = 2, 즉 으로 고정했습니다. 그러나 절단은 자유로운 선택이 아니라 수렴 매개변수이며, 답이 더 이상 변하지 않을 때에만 신뢰할 수 있습니다(포크 공간 절단하기 참조).
회로에는 절단이 없으므로 컷오프가 바뀌어도 회로 자체는 바뀌지 않고, transpilation만 반복됩니다. 달라지는 것은 결과물의 크기이며, 스윕이 여기서처럼 저렴한 것은 시스템이 아주 작기 때문입니다. 다음 기준값은 절단된 동역학의 정확한 고전 시뮬레이션인데, 사이트 네 개에서는 가능하지만 큐비트 수에 따라 지수적으로 커집니다. 그 범위를 넘는 문제에는 비교할 정확한 기준값이 없으므로 수렴을 다른 수단으로 판단해야 합니다.
>>> def densities_at_cutoff(max_occ, encoding=LevelEncoding.GRAY):
...     """Exact truncated-space densities at a given cutoff."""
...     spec = LevelSpec(max_occ, encoding).resolve(num_sites)
...
...     start = np.zeros(2**spec.total_width, dtype=complex)
...     start[
...         sum(encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets))
...     ] = 1.0
...
...     def matrix(operator):
...         observable = occupation_encoding(operator, spec)
...         return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
...
...     evolved = expm_multiply(-1j * total_time * matrix(hamiltonian), start)
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         out.append(float((evolved.conj() @ (matrix(number) @ evolved)).real))
...     return out
>>>
>>> previous = None
>>> for max_occ in (1, 2, 3, 4):
...     current = densities_at_cutoff(max_occ)
...     # Report the drift bucketed rather than to full precision: after it reaches machine
...     # epsilon, the exact digits are arithmetic noise and vary between BLAS builds.
...     if previous is None:
...         drift = "--"
...     else:
...         gap = max(abs(a - b) for a, b in zip(current, previous))
...         drift = f"{gap:.0e}" if gap > 1e-12 else "< 1e-12"
...     print(f"d={max_occ + 1}  "
...           + " ".join(f"{x:.6f}" for x in current)
...           + f"   drift={drift}")
...     previous = current
d=2  0.993986 0.858173 0.141827 0.006014   drift=--
d=3  0.993834 0.858853 0.141309 0.006004   drift=7e-04
d=4  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
d=5  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
max_occupation = 1()에서는 각 사이트가 보손을 최대 하나만 가지므로 사이트에 두 개가 필요한 상호작용 항은 전혀 작용하지 못하며, 밀도는 약 만큼 어긋납니다. 세 번째 준위를 추가하면 결과가 상호작용을 포착하고, max_occupation = 3부터는 결과가 기계 정밀도까지 정지해 있습니다. 수렴한 것입니다.
max_occupation = 2에서 멈추는 이유는 입자 수입니다. 해밀토니안은 보손 수를 보존하고 이 상태는 보손을 두 개 가지므로, 발전 시간이나 상호작용이 척력인지 인력인지와 관계없이 어떤 사이트도 두 개보다 많이 가질 수 없습니다. 대신 까지 발전시키거나 의 부호를 바꿔도, max_occupation = 2 이상에서 밀도는 까지 변하지 않습니다.
요구 사항을 실제로 높이는 것은 보손의 수입니다. 같은 체인에서 보손이 세 개이면 같은 짧은 시간 발전 후 max_occupation = 2와 3 사이에서 약 만큼, 후에는 약 만큼 변합니다. 이는 이 모델과 보존량에 대한 진술이며, 입자 수를 보존하는 연산자에 대해서만 상한이 됩니다. 일반 규칙이 아니므로 컷오프는 추측하지 말고 스윕해야 합니다.
스윕에는 회로 쪽 비용도 있으며, 정확한 기준값은 이를 보여 주지 않습니다. 같은 보손 회로를 각 컷오프에서 그레이 코드로 낮추면 다음과 같습니다.
>>> for max_occ in (1, 2, 3, 4):
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occ, LevelEncoding.GRAY)
...     )
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(decomposed)
...     depth = lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"d={max_occ + 1}  qubits={lowered.num_qubits:2d}  2q-depth={depth:4d}")
d=2  qubits= 4  2q-depth=   8
d=3  qubits= 8  2q-depth=  95
d=4  qubits= 8  2q-depth= 217
d=5  qubits=12  2q-depth=1176
준위가 하나 늘 때마다 깊이가 늘고, 가 2의 거듭제곱을 넘을 때마다 큐비트 수가 뛰어오릅니다. 따라서 에서 수렴시킬 때는 정확도와 회로 크기를 맞바꾸게 되므로, 스윕은 단순한 수치 검사 이상입니다.
가 거의 맞는 것은 관측량에 의한 우연이라는 점도 유의하세요. 사이트 밀도는 거의 움직이지 않지만, 근본적인 상태는 질적으로 틀립니다(이중 점유 성분이 없습니다). 한 관측량이 수렴했다고 해서 다른 관측량도 수렴했다는 뜻은 아닙니다.
핵심 정리
-
인코딩은 트랜스파일러의 관심사입니다. 3단계의 보손 회로에는 절단도, 인코딩도, 큐비트 수도 언급되어 있지 않습니다. 네 가지 인코딩이 이를 서로 다른 네 개의 회로로 낮추었고, 모두 같은 물리를 재현했습니다. 트랜스파일러 앞단에서는 아무것도 바꿀 필요가 없었습니다.
-
보손의 경우 이것은 단순한 편의 이상입니다. 절단은 반드시 훑어봐야 하는 수렴 매개변수이며 인코딩 안에 존재합니다. 고정된 인코딩에 맞춰 만든 회로는 의 값이 바뀔 때마다 다시 만들어야 합니다.
-
매핑 전에 묶고, 에르미트성을 위해 묶으세요. 단일 호핑 항은 에르미트가 아니어서 지수화할 수 없습니다. 반면 손 위의 결합 쌍은 에르미트이므로 지수화할 수 있습니다. 격자가 아직 보이는 보손 수준에서 분할을 결정하세요. 이것은 물리적으로 필요하며,
groups속성은 그 결정을 뒤로 전달하기 위해 존재합니다. -
낮은 가중치 인코딩이 저렴하다고 가정하지 마세요. 에서는 컴팩트 코드가 큐비트와 게이트 모두에서 두 가지 유니터리 변형보다 우수하며, 투영 변형이 가장 비쌉니다. 직접 측정하세요. 교차점은 에 따라 달라집니다.
-
절단은 대수를 정량화할 수 있는 방식으로 깨뜨립니다. 유지된 가장 높은 준위에서만, 만큼 깨집니다. 이것이 매핑이 정규 순서와 교환되지 않는 이유이기도 합니다.
다음 단계
이 예제를 확장하는 두 가지 방향이 있습니다. 체인의 간선 목록을 정사각 격자의 결합으로 바꾸면 다른 변경은 필요 없습니다. 앞에서 정의한 bose_hubbard 함수가 이미 기하 구조에 구애받지 않기 때문입니다. 직접 만든 사용자 정의 인코딩(예를 들어 단항과 컴팩트 사이를 보간하는 블록 단항 코드)도 프리셋이 사용하는 동일한 MapperFnEvolutionSynthesis 접점을 통해 연결됩니다.
-
연산자 표현의 설계 원칙은 해밀토니안의 기반이 되는 연산자 데이터 구조를 설명합니다.
-
연산자 표현 매핑은 인코딩과 직접 매퍼를 작성하는 방법을 다룹니다.
-
보손 회로 트랜스파일은 프리셋이 실행하는 단계들을 차례로 안내합니다.
-
보손 공간에서 Evolution 게이트 합성은 보손 공간에서 트로터 오차를 줄이는 방법을 보여줍니다.
보고된 모든 깊이는 추상적이고 완전히 연결된 레지스터를 기준으로 합니다. 실제 하드웨어 연결성으로의 매핑은 별도의 단계이며, 점유 인코딩의 모드별 큐비트 블록은 모드당 큐비트 하나일 때보다 라우터에 상당히 다른 구조를 제공합니다.
[1]
R. Somma, G. Ortiz, E. Knill, and J. Gubernatis, Quantum Simulations of Physics Problems (2003), arXiv:quant-ph/0304063, Sec. 4, Eq. 22.
[2]
N. P. D. Sawaya, T. Menke, T. H. Kyaw, S. Johri, A. Aspuru-Guzik, and G. G. Guerreschi, Resource-efficient digital quantum simulation of d-level systems for photonic, vibrational, and spin-s Hamiltonians, npj Quantum Information 6, 49 (2020), arXiv:1909.12847.