오류 억제 및 조정
오류 억제란 특정 유형의 노이즈와 오류를 예측하고 피하려는 모든 기법을 가리킬 수 있습니다. 이는 구체적인 예시를 통해 가장 쉽게 설명할 수 있지만, 이러한 방법이 여기에서 소개하는 예시에 국한되지 않으며 새로운 방법이 계속해서 연구되고 있다는 점을 유념하시기 바랍니다. 때로는 오류를 억제하는 것이 불가능하지만, 오류가 누적되는 방식에는 영향을 줄 수 있습니다. 오류가 더 느리게 누적되도록 만들 수 있다면 이를 전체 오류의 억제라고 표현할 수도 있지만, 더 정확하게는 노이즈 조정(tailoring)으로 볼 수 있습니다. 이번 강의에서는 오류 억제의 대표적인 예시인 동적 분리(dynamical decoupling)와 노이즈 조정/형성의 대표적인 예시인 파울리 트윌링(Pauli twirling)을 다룹니다.
이 강의에 곁들일 영상이 며칠 내로 공개될 예정이며, 여기에 삽입될 것입니다.
동적 분리
단일 큐비트의 아주 간단한 상태로 시작하여 간단한 노이즈 모델을 소개하겠습니다. 이것만으로 동적 분리를 완전히 설명하기에는 부족하지만, 명확한 예시를 제공해줍니다. 아다마르 게이트를 사용해 중첩 상태로 준비된 큐비트가 있다고 가정해 봅시다:
이 상태는 아래 왼쪽에 나타난 것처럼 블로흐 구(Bloch sphere) 위에 시각화됩니다. 노이즈가 전혀 없는 이상적인 경우라면 이 큐비트는 다음 연산이 수행될 때까지 이 상태를 유지할 것입니다. 하지만 이전 강의를 통해 우리가 실제로 관찰하는 것은 그렇지 않다는 것을 알고 있습니다. 노이즈로 인해 양자 정보가 저하됩니다.
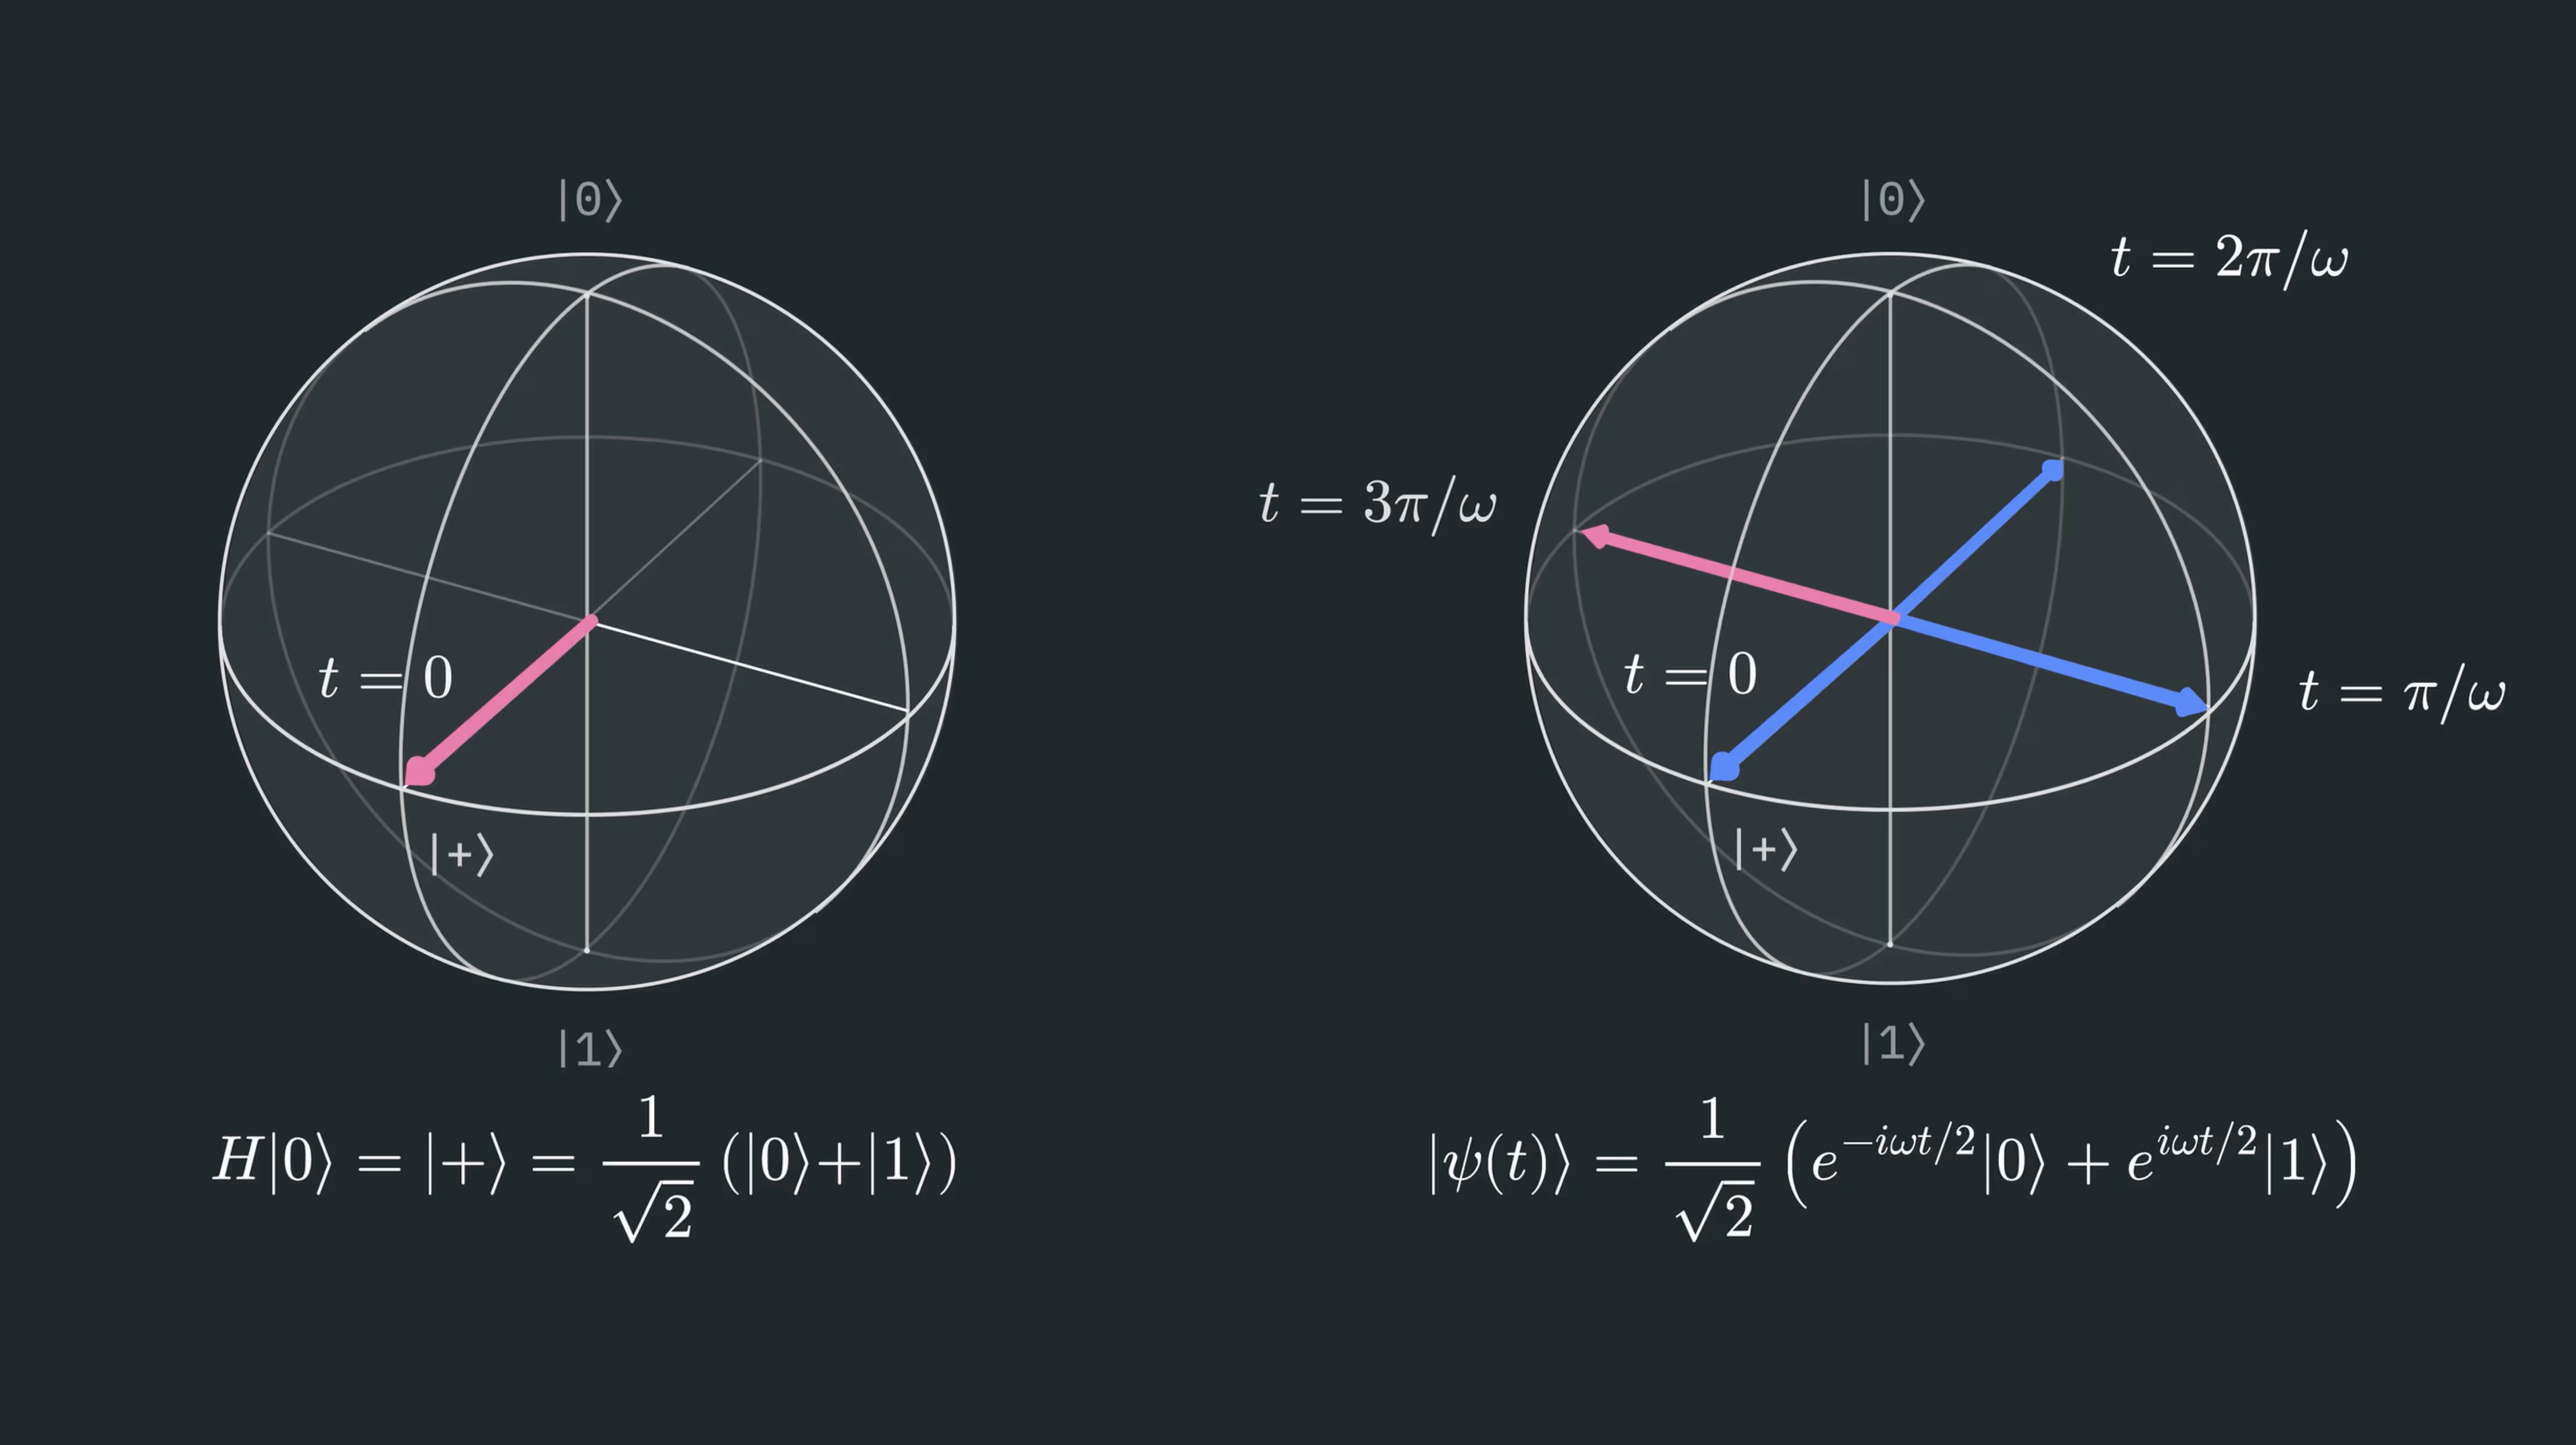
노이즈 또는 환경과의 결합은 기저 상태 사이의 상대 위상을 변화시킬 수 있습니다. 즉, 계수의 절댓값은 변하지 않으므로 과 의 확률은 변하지 않습니다. 대신 진폭의 위상이 변하여 실수부와 허수부가 달라집니다. 이 논의를 더 구체적으로 만들기 위해, 이를 일으킬 수 있는 한 가지 상호작용 유형인 Z 방향으로 향한 자기장과의 결합을 살펴보겠습니다: .
시간이 지남에 따라 상태 에 어떤 일이 일어나는지 살펴봅시다:
여기서는 Z 방향의 자기장이 유효 자기 모멘트와 자기장 세기에 따라 결정되는 주파수 로 Z축 주위의 세차운동(precession)을 일으킨다는 사실을 이용했습니다. 세부 사항보다 중요한 것은 이 상호작용이 Z축 주위의 시간 발전을 일으켜 두 계산 기저 상태에 대해 반대 방향의 위상 누적을 초래한다는 사실입니다. 이 연산자를 의 각 항에 적용하면 다음을 얻습니다:
이 시간에 의존하는 위상은 블로흐 구 그림에서 Z축 주위의 세차운동에 해당합니다. 이는 위 그림의 오른쪽 절반에 나타나 있습니다.
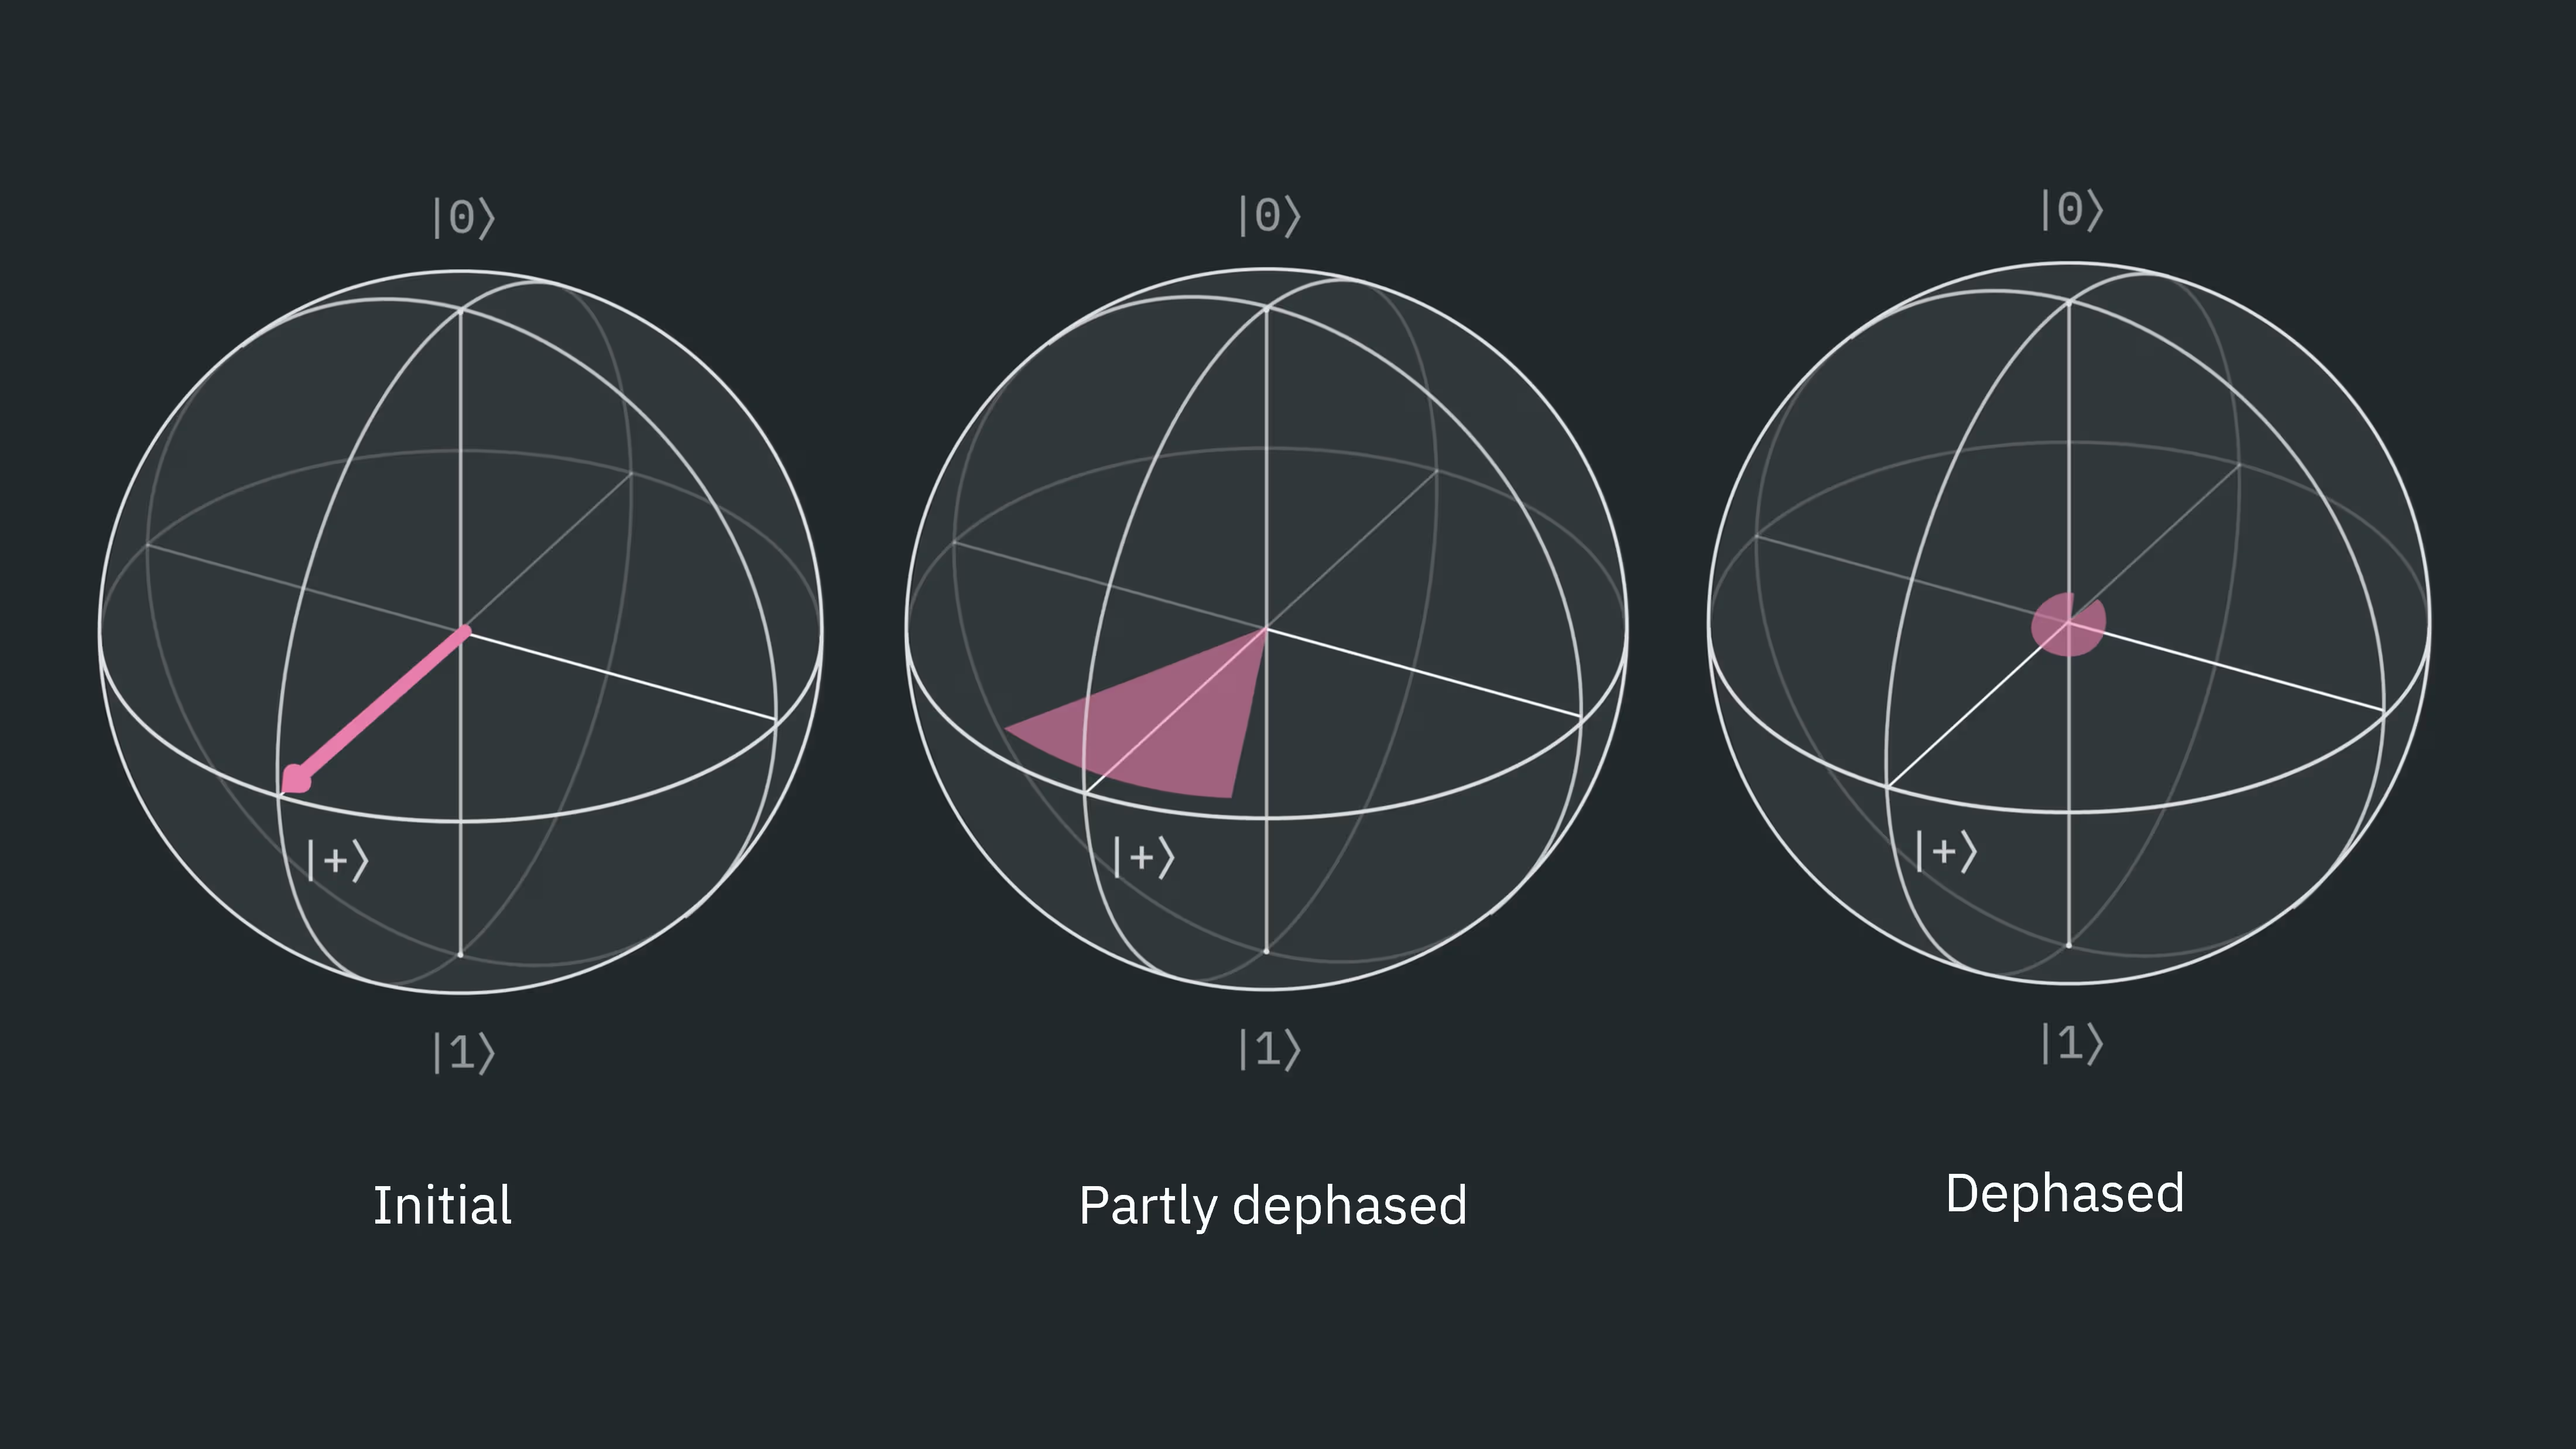
이 상호작용이 제어된 방식으로 일어난다는 것을 안다면 이를 예측할 수 있을 것입니다. 이러한 유형의 노이즈를 모델링하기 위해, 우리는 대신 각각이 어떤 고전적 확률로 발생하는 가능한 자기장 세기의 분포를 고려합니다(다른 노이즈원은 다르게 모델링해야 할 것입니다). 상태가 전혀 회전하지 않았을 0이 아닌 고전적 확률이 존재하고, 또한 조금 회전했을 확률, 심지어 크게 회전했을 확률도 존재하는 경우를 고려해야 합니다. 이러한 가능한 회전들의 분포가 아래 블로흐 구 그림에서 상태가 퍼지는 이유입니다. 이러한 위상 이완(dephasing) 노이즈가 더 많을수록 위상은 덜 명확하게 정의됩니다. 강한 위상 이완의 극한에서는 큐비트가 완전히 위상 이완되어, 상태에 저장된 양자 결맞음(coherence)을 잃게 됩니다.
물론 실험에서는 어떤 무작위 결합이 일어날지 전혀 알 수 없습니다. 이에 대해 우리가 할 수 있는 일은 무엇일까요?
환경과의 결합이 시간 간격 동안 대략 일정하게 유지된다고 가정해 봅시다. 다음과 같은 처방을 따른다면 어떤 일이 일어날지 살펴봅시다:
-
시간 동안 위상이 변하도록 둡니다
-
큐비트에 X 게이트를 적용합니다
-
동일한 환경 결합이 추가로 시간 동안 일어나도록 둡니다
-
두 번째 X 게이트를 적용합니다
초기 시간 발전 이후, 우리는 정확히 위의 상태를 갖게 됩니다. 첫 번째 X 게이트를 적용하면 다음을 얻습니다:
이제 두 번째 구간이 지나면 동일한 상호작용이 일어납니다. 하지만 이제 진폭이 반대의 Z 고유상태와 연관되어 있으므로, Z축 주위 회전의 부호가 바뀌었음을 의미합니다. 시스템이 다시 동안 시간 발전하도록 두면 다음 상태를 얻습니다:
를 대입하면:
마지막 X 게이트를 적용해도 이 경우에는 아무 변화가 없지만, 일반적으로는 필요합니다:
우리는 상대 위상을 포함한 원래의 양자 상태를 회복했습니다. 이 과정은 동적 분리의 특히 간단한 예시입니다.
더 일반적으로, 동적 분리(DD)는 큐비트 외부 시스템과의 상호작용 영향을 줄이기 위해(환경으로부터 큐비트를 분리하기 위해) 일부 단일 큐비트 게이트를 삽입하는 것을 포함합니다. 위에서 보여준 것처럼 가능한 모든 위상 이력이 원래 상태로 완전히 재집속(refocusing)되는 것은 다소 이상화된 경우이지만, 여전히 가능한 시나리오입니다. DD가 언제 유용한지, 그리고 어떤 유의점이 있는지 논의해 봅시다.
이해도 확인
위 본문에서 우리는 XX DD 시퀀스가 초기 상태 에 미치는 영향을 단계별로 살펴보았습니다. 같은 z 방향의 천천히 변하는 자기장이라는 가정 하에서, 위와 동일한 단계가 상태 도 초기 상태로 되돌리는지 확인해 보십시오.
답
초기 시간 발전 이후, 우리는 정확히 위의 상태를 갖게 됩니다. 첫 번째 X 게이트를 적용하면 다음을 얻습니다:
이제 두 번째 구간이 지나면 동일한 상호작용이 일어납니다. 하지만 이제 진폭이 반대의 Z 고유상태와 연관되어 있으므로, Z축 주위 회전의 부호가 바뀌었음을 의미합니다. 시스템이 다시 동안 시간 발전하도록 두면 다음 상태를 얻습니다:
를 대입하면
마지막 X 게이트를 적용하면 다음을 얻습니다:
DD를 사용해야 할 때
첫 번째이자 가장 명백한 유의점은 우리가 다룬 내용에서 순수한 위상 이완 채널을 가정했다는 것입니다. 실제 상호작용은 대개 위상 이완과 다른 오류 메커니즘이 혼합되어 발생합니다. 위에서 다룬 내용에서 우리는 특별히 X 게이트를 적용하기로 선택했습니다. 이는 동적 분리에서 XX 시퀀스라고 불립니다. 이 특정 시퀀스는 순수한 위상 이완 오류에 적합합니다. 하지만 아래 회로도에 나타난 XY4나 더 복잡한 XY8처럼 더 폭넓게 적용될 수 있는 다른 시퀀스들도 있습니다.

또 다른 유의점은 동적 분리가 단일 큐비트 게이트를 추가한다는 것이며, 이는 게이트의 불완전함이나 크로스토크로 인해 단일 큐비트 오류를 추가할 수 있습니다. 이러한 단일 큐비트 오류율은 일반적으로 다중 큐비트 게이트 오류보다 훨씬 낮으므로 보통 큰 문제는 아니지만, 많은 큐비트가 회로 전체에서 여러 번 DD를 사용하는 경우에는 유념해야 할 사항입니다.
DD는 외부 결합이 큐비트의 상태에 영향을 미칠 시간이 있을 때 유용합니다. 큐비트는 공들여 잘 격리되어 있고 외부 결합은 약해야 하므로, 이러한 유형의 노이즈는 큐비트가 오랫동안 유휴 상태로 있을 때 가장 두드러집니다. 유휴 시간이 짧을 경우, DD의 효과는 노이즈를 거의 억제하지 못하면서 단일 큐비트 게이트 오류만 추가하는 것일 수 있으며, 오히려 회로의 충실도(fidelity)가 감소할 수도 있습니다.
핵심 요점: 큐비트가 충분히 오랫동안 유휴 상태로 남아 있을 때 동적 분리를 사용하고, 사용하는 DD 시퀀스의 유형에 주의를 기울이십시오.
Qiskit을 사용한 동적 분리
상태로 준비된 뒤 오랫동안 유휴 상태로 남아 있는 여러 큐비트의 경우를 살펴보며 DD의 사용을 탐구해 봅시다. 오류가 없다면, 다중 큐비트 상태 를 준비한 후 측정 전에 아다마르 게이트를 적용하면(즉 X 기저에서 측정하면) 항상 0을 얻어야 합니다. 노이즈가 있으면 측정 결과는 100% 확률이 아니라 일부 경우에만 0이 됩니다. 우리는 여러 큐비트에 걸친 X 기댓값의 평균을 계산합니다. 즉, 우리는 다음에 관심이 있습니다:
여기서 이며 X 연산자는 오른쪽에서 번째 위치에 있고, 는 전체 시스템의 상태입니다.
이 회로는 의도적인 지연을 포함하고 있으며, 이는 벤치마크로서는 다소 인위적입니다. 하지만 실제 회로에서 실행 도중 일부 큐비트가 유휴 상태로 있는 것은 매우 흔한 일입니다. 이는 계산의 일부 동안 일부 큐비트가 유휴 상태로 남아 있는 더 복잡한 회로의 단순화된 모델이라고 생각할 수 있습니다. 상태의 시간 발전에 기반한 이러한 유형의 벤치마킹은 흔히 _램지 벤치마킹(Ramsey benchmarking)_이라고 불립니다.
필요한 패키지를 불러오고 서비스를 구성하는 것으로 시작합니다.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime
# Load key packages

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit
import numpy as np

# --------- Configuration ----------

service = QiskitRuntimeService()  # assumes credentials are saved
backend = service.backend("ibm_fez")  # adjust if needed
이제 몇 가지 헬퍼 함수를 정의합니다. 먼저 긴 유휴 시간에 대한 부분을 다루고자 합니다. 이 맥락에서 "길다"는 정확히 무엇을 의미할까요? 유휴 시간을 그냥 마이크로초 단위로 보고할 수도 있습니다. 하지만 같은 시간 간격 동안 몇 개의 이중 큐비트 게이트가 실행될 수 있는지 아는 것이 유용합니다. 이렇게 하면 유휴 시간이 같은 기간 동안 실행될 수 있었던 회로 깊이를 더 직접적으로 나타내게 됩니다. 첫 번째 헬퍼 함수는 백엔드에 고유한 이중 큐비트 게이트를 가져오고 해당 게이트의 지속 시간을 결정합니다.
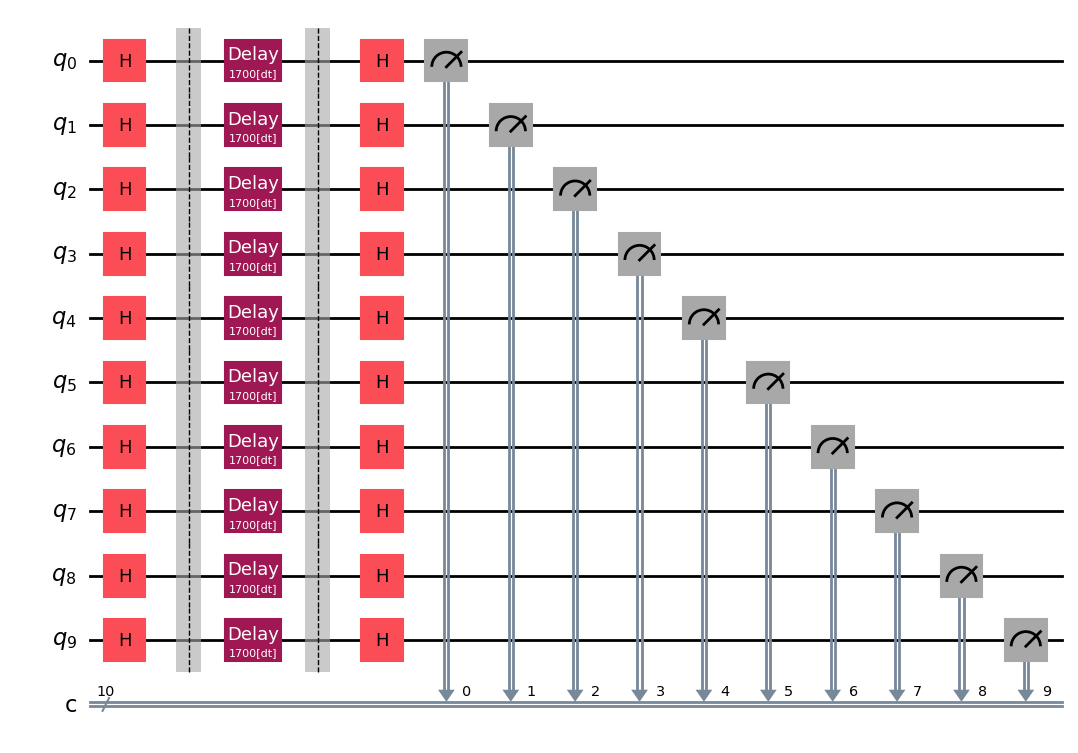
두 번째 함수는 단순히 램지 회로( 상태의 큐비트를 가진 회로)를 생성하고, 지연을 구현하며, H 게이트를 사용해 회전시킨 다음 측정합니다. 아다마르 게이트(H)는 를 로 매핑한다는 점을 떠올려 보면, 아다마르 게이트 이후 Z 기저에서 을 측정하는 것은 아다마르 게이트 직전에 큐비트가 상태였음을 나타냅니다.
마지막 함수는 0과 1 측정 결과의 원시 카운트(raw counts)를 X의 기댓값으로 변환합니다.
from typing import Tuple
from qiskit.providers import Backend
from numpy.typing import NDArray

# --------- Utilities ----------
def detect_twoq_gate_and_duration(
    backend: Backend, pair: tuple[int, int] = (0, 1)
) -> Tuple[str, float]:
    props = backend.properties()
    candidates = ["cx", "ecr", "cz"]
    for name in candidates:
        try:
            dur = props.gate_length(name, list(pair))
            if dur is not None:
                return name, dur
        except Exception:
            pass
    raise RuntimeError(
        "Could not find a two-qubit gate duration among cx/ecr/cz on this backend."
    )

def make_multiqubit_ramsey_circuit(n: int, delay_dt_ticks: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q)
    qc.barrier()

    for i in range(n):
        qc.delay(delay_dt_ticks, q[i], unit="dt")
    qc.barrier()

    qc.h(q)
    qc.measure(q, c)
    return qc

def counts_to_x_expectations(counts: dict[str, int], n: int) -> NDArray[np.float64]:
    total = sum(counts.values())
    if total == 0:
        return np.zeros(n)

    p0 = np.zeros(n, dtype=float)
    for bitstring, cnt in counts.items():
        bits_rev = bitstring[::-1]
        for i in range(n):
            if bits_rev[i] == "0":
                p0[i] += cnt
    p0 /= total
    return 2.0 * p0 - 1.0
이제 큐비트 수와 DD에 사용할 게이트 시퀀스(이 경우 XX)를 포함하여 테스트의 세부 사항을 지정합니다. 특히 최적화 수준을 0으로 설정한다는 점에 주목하십시오. 실제로는 더 높은 최적화 수준을 선택하는 경우가 많지만, 여기서는 DD가 대상으로 하는 오류의 효과가 계속 보이도록 하기 위해 수준 0을 사용합니다. 마지막으로 이 백엔드에서 이중 큐비트 게이트의 특성 시간을 결정하고 관련 시간을 몇 가지 출력합니다.
n_qubits = 10  # number of qubits to test in parallel
shots = 4096
opt_level = 0  # we want to ignore optimization for now
num_steps = 6  # number of delay points
gates_per_step = 20  # "equivalent 2q gates" per step
dd_sequence = "XX"  # "XX" for your request; you might try "XY4" too

# --------- Derive timing: dt and 2q gate time ----------
dt = backend.dt  # seconds per dt
twoq_name, t2q = detect_twoq_gate_and_duration(backend, (0, 1))  # seconds
delay_unit_dt = int(round(t2q / dt))  # dt ticks equivalent to one 2q gate

print(f"Backend: {backend.name}")
print(f"dt = {dt*1e9:.3f} ns per tick")
print(f"Using 2q gate '{twoq_name}' with duration ~ {t2q*1e9:.1f} ns")
print(f"One 2q gate ≈ {delay_unit_dt} dt ticks")
Backend: ibm_fez
dt = 4.000 ns per tick
Using 2q gate 'cz' with duration ~ 68.0 ns
One 2q gate ≈ 17 dt ticks
이제 회로를 구성하고 선택한 백엔드에 맞게 트랜스파일합니다.
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

equiv_gates_list = [
    j * gates_per_step for j in range(num_steps)
]  # e.g., 0, 100, 200, ...
delay_dt_list = [int(round(delay_unit_dt * m)) for m in equiv_gates_list]
delay_us_list = [(dt * d) * 1e6 for d in delay_dt_list]  # for printing/plotting

circuits = []
for delay_dt in delay_dt_list:
    qc = make_multiqubit_ramsey_circuit(n_qubits, delay_dt)
    qc_isa = pm.run(qc)  # ISA-level scheduling/placement; DD is handled at runtime
    circuits.append(qc_isa)

print("Delay sweep (approx microseconds):", [f"{t:.2f}" for t in delay_us_list])
Delay sweep (approx microseconds): ['0.00', '1.36', '2.72', '4.08', '5.44', '6.80']
원하는 상태와 지연으로 회로를 올바르게 작성했는지 확인하기 위해 적어도 하나의 회로를 시각화해야 합니다. 트랜스파일 이전 회로인 qc를 시각화하는 것이 더 쉬울 수도 있고, 트랜스파일된 회로인 qc_isa를 확인할 수도 있습니다.
qc.draw("mpl")
실행
드디어 하드웨어에서 실행할 준비가 되었습니다. 각 큐비트의 여러 측정값을 얻기 위해 Sampler를 사용하며, 이를 두 번 사용할 것입니다. 한 번은 DD를 명시적으로 끈 상태로, 다른 한 번은 DD를 켜고 XX 게이트 시퀀스를 사용한 상태로 실행합니다.
# --------- Run: NO DD ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = False

job = sampler.run(circuits)
res_nodd = job.result()
job_id = job.job_id()  # job id for dd off/false
print("job number for no dd is ", job_id)

# --------- Run: WITH DD (XX) ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = (
    dd_sequence  # "XX" first; you can try "XY4" too
)
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_dd = job.result()
job_id = job.job_id()  # job id for dd on/XX
print("job number for dd using XX is ", job_id)
다양한 회로에서 카운트를 추출할 수 있습니다.
# --------- Extract counts per circuit ----------

from typing import Iterable, Any

def extract_counts_list(res: Iterable[Any]) -> list[dict[str, int]]:
    counts_list: list[dict[str, int]] = []

    for r in res:  # each r corresponds to one circuit
        counts: dict[str, int] = r.data.c.get_counts()
        counts_list.append(counts)

    return counts_list

counts_list_nodd = extract_counts_list(res_nodd)
counts_list_dd = extract_counts_list(res_dd)
후처리
이제 측정으로부터 얻은 카운트가 있지만, 위상 정보의 보존에 대해 알아보기 위해 이를 X의 기댓값으로 바꾸고 우리가 사용한 모든 큐비트에 걸쳐 그 기댓값들의 평균을 구하고자 합니다. 이를 위해 앞서 정의한 counts_to_x_expectations 함수를 사용합니다.
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.

xexp_nodd = []
xexp_dd = []
contrast_nodd = []
contrast_dd = []

for counts in counts_list_nodd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_nodd.append(x_vec)
    contrast_nodd.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

for counts in counts_list_dd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_dd.append(x_vec)
    contrast_dd.append(float(np.mean(np.abs(x_vec))))

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1 in zip(equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD  :", np.round(np.abs(xexp_dd[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.954,  DD(XX)= 0.961
Delay ~   20 * cz  (~   1.36 µs):  NoDD= 0.827,  DD(XX)= 0.927
Delay ~   40 * cz  (~   2.72 µs):  NoDD= 0.793,  DD(XX)= 0.900
Delay ~   60 * cz  (~   4.08 µs):  NoDD= 0.729,  DD(XX)= 0.876
Delay ~   80 * cz  (~   5.44 µs):  NoDD= 0.661,  DD(XX)= 0.854
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.586,  DD(XX)= 0.826

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.05  0.744 0.712 0.867 0.844 0.234 0.473 0.755 0.59  0.587]
DD  : [0.583 0.89  0.921 0.88  0.908 0.832 0.893 0.773 0.807 0.773]
마지막으로 결과를 그래프로 그려봅시다.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With DD", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
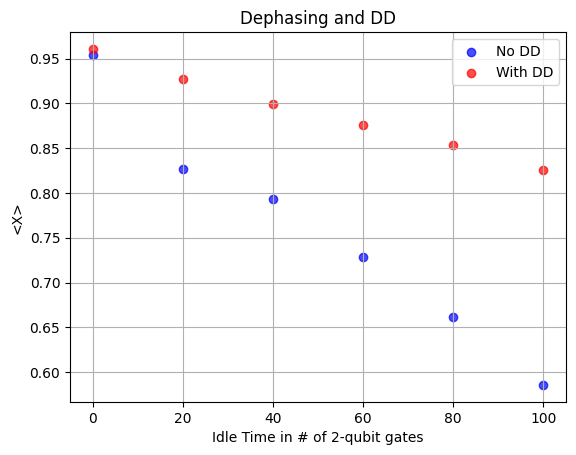
보시다시피 명시적인 지연이 없을 때 기댓값은 실제로 1에 가까우며, 이는 모든 위상 정보가 보존되었다면 예상할 수 있는 결과입니다. 모든 위상 정보가 손실되었다면 마지막 회전이 보다 을 만들어낼 선호가 전혀 없을 것이고, 평균 기댓값은 0에 가까워질 것입니다. 데이터를 보면 지연 시간이 증가함에 따라 X의 평균 기댓값이 감소하여 0에 가까워지기 시작하는 것을 볼 수 있습니다. 여기서 DD가 매우 효과적이었다는 점에 주목하십시오. DD를 사용한 기댓값은 대체로 DD가 없는 경우보다 20% 이상 더 나은(1에 더 가까운) 값을 보입니다. 하지만 첫 번째 지연된 데이터 포인트가 대략 100번의 이중 큐비트 게이트 연산에 해당하는 지연이라는 점도 주목해야 합니다. 이는 DD가 큐비트가 비교적 오랫동안 유휴 상태로 남아 있을 때 가장 유용하다는 점을 다시 한번 보여줍니다.
이해도 확인
이전과 동일한 회로에 XY4를 사용해 DD를 적용한다면, XX를 사용한 DD보다 훨씬 더 나은 결과, 훨씬 더 나쁜 결과, 아니면 거의 비슷한 결과를 낼 것으로 예상하십니까? 설명해 보십시오.
답
거의 비슷하며, 어쩌면 약간 더 나쁠 수 있습니다. 우리가 사용한 회로는 XY 평면으로 회전된 상태를 가지고 있었습니다. 이 상태는 주로 위상에 정보를 저장하므로 T1 이완보다는 위상 이완 오류에 특히 민감합니다. XY4는 더 다양한 종류의 오류에 도움이 될 수 있지만, XX는 이미 우리가 사용하는 회로에 도움이 되도록 최적화되어 있습니다. XY4도 그만큼 좋을 수 있지만 실질적으로 추가되는 이점은 없을 것이며, XY4가 더 많은 게이트를 포함한다는 사실로 인해 추가적인 게이트 오류가 발생하여 결과가 약간 더 나빠질 수도 있습니다.
마지막 결과는 가장 단순한 DD 게이트 시퀀스인 XX를 사용했습니다. 더 복잡한 시퀀스인 XY4를 구현하는 방법을 살펴봅시다. 다음 섹션에서 Sampler를 정의합니다.
# --------- Run: WITH DD (XY4) ----------
dd_sequence = "XY4"

sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = dd_sequence
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_xy4 = job.result()
job_id = job.job_id()  # job id for dd on/XY4
print("job number for dd using Xy4 is ", job_id)
job number for dd using Xy4 is d6k6ti860irc7395d3hg
# --------- Extract counts per circuit ----------

counts_list_xy4 = extract_counts_list(res_xy4)
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.
xexp_xy4 = []
contrast_xy4 = []

for counts in counts_list_xy4:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_xy4.append(x_vec)
    contrast_xy4.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1, c2 in zip(
    equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd, contrast_xy4
):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD XX :", np.round(np.abs(xexp_dd[-1]), 3))
print("DD XY4 :", np.round(np.abs(xexp_xy4[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.968,  DD(XY4)= 0.968
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.612,  DD(XY4)= 0.839
Delay ~  200 * cz  (~  13.60 µs):  NoDD= 0.462,  DD(XY4)= 0.705
Delay ~  300 * cz  (~  20.40 µs):  NoDD= 0.339,  DD(XY4)= 0.580
Delay ~  400 * cz  (~  27.20 µs):  NoDD= 0.225,  DD(XY4)= 0.481
Delay ~  500 * cz  (~  34.00 µs):  NoDD= 0.204,  DD(XY4)= 0.393

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.002 0.208 0.447 0.034 0.286 0.306 0.322 0.044 0.163 0.232]
DD XX : [0.433 0.669 0.526 0.516 0.572 0.284 0.303 0.055 0.365 0.208]
DD XY4 : [0.38  0.662 0.521 0.538 0.621 0.252 0.353 0.038 0.239 0.073]
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD using XX sequence
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With XX", alpha=0.7
)

## Add values with DD using XY4 sequence
ax.scatter(
    equiv_gates_list,
    contrast_xy4,
    c="black",
    linestyle="-",
    label="With XY4",
    alpha=0.7,
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>_av")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
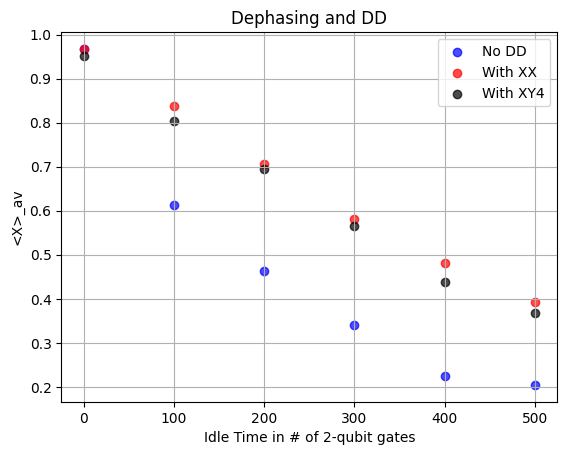
여기서 XY4가 XX와 눈에 띄게 다르지 않음을 알 수 있습니다. XY4 시퀀스에 추가된 게이트로 인해 아주 약간 더 나쁠 수도 있지만, 더 중요한 것은 XX가 과 같은 상태에 대해 특히 위상을 보존하는 데 원하는 효과를 내는 이유를 이미 설명했다는 점입니다. 그러한 초기 상태에 대해서는 다른 시퀀스가 결과를 개선할 것이라고 생각할 이유가 없습니다.
이해도 확인
XY4 시퀀스가 전역 위상(global phase)을 제외하고 상태를 변하지 않게 유지함을 확인하십시오.
답
파울리 트윌링
먼저 파울리 트윌링이 흔히 오류 억제 기법이 아니라 오류 형성(error-shaping) 기법으로 사용된다는 점에 주목해야 합니다. 즉, 다른 방법을 가능하게 하기 위해 노이즈/오류가 다르게, 때로는 더 예측 가능하게 동작하도록 만듭니다. 파울리 트윌링이 오류를 방지하지는 않지만, 오류의 결맞음 누적을 방지할 수는 있습니다.
양자 회로에서는 여러 가지 서로 다른 오류원이 함께 더해집니다. 오류는 여러 방식으로 더해질 수 있으며, 특히 결맞게(coherently) 또는 결맞지 않게(incoherently) 더해질 수 있습니다. 오류의 결맞은 누적이란 노이즈나 불완전한 구현이 여러 레이어와 게이트에 걸쳐 오류를 모두 같은 방향으로 몰아가는 경향을 의미합니다. 예를 들어 회전 게이트를 적용할 때의 결맞은 과회전(over-rotation)이 있습니다.
X축 주위로 정확히 만큼 회전시키는 와 같은 이상적인 회전 게이트를 생각해 봅시다. 물론 게이트 구현은 완벽하지 않으며, 실제 회전은 한 번의 구현에서 일 수 있고, 가 항상 같은 부호이며 의 여러 적용에 걸쳐 크기도 비슷한 경우조차 있을 수 있습니다. 따라서 회전 게이트를 반복해서 적용하면 이러한 여러 과회전(또는 저회전) 가 결맞게 누적될 수 있습니다.
결맞지 않은 오류 누적은 정반대입니다. 오류가 무작위 방향과 무작위 부호를 가지므로, 서로 다른 레이어의 오류가 항상 가산적으로 간섭하는 것이 아니라 때로는 상쇄되거나 제곱합(quadrature) 형태로 더해집니다. 큐비트 상태에 대한 전체적인 영향이라는 측면에서 결맞지 않은 오류는 분명 더 느리게 누적됩니다. 이에 대한 간단한 모식도가 아래 그림에 나타나 있습니다. 이는 단순화된 그림입니다. 실제 양자 오류는 이차원 데카르트 공간에 국한되지 않으며, 모든 오류 기여가 같은 크기를 갖는 것도 아니고, 더 복잡한 요소들이 있습니다. 하지만 이러한 그림이 주는 직관은 유용합니다. 결맞은 오류는 결맞지 않은 오류보다 더 빠르게 누적되는 경향이 있습니다.
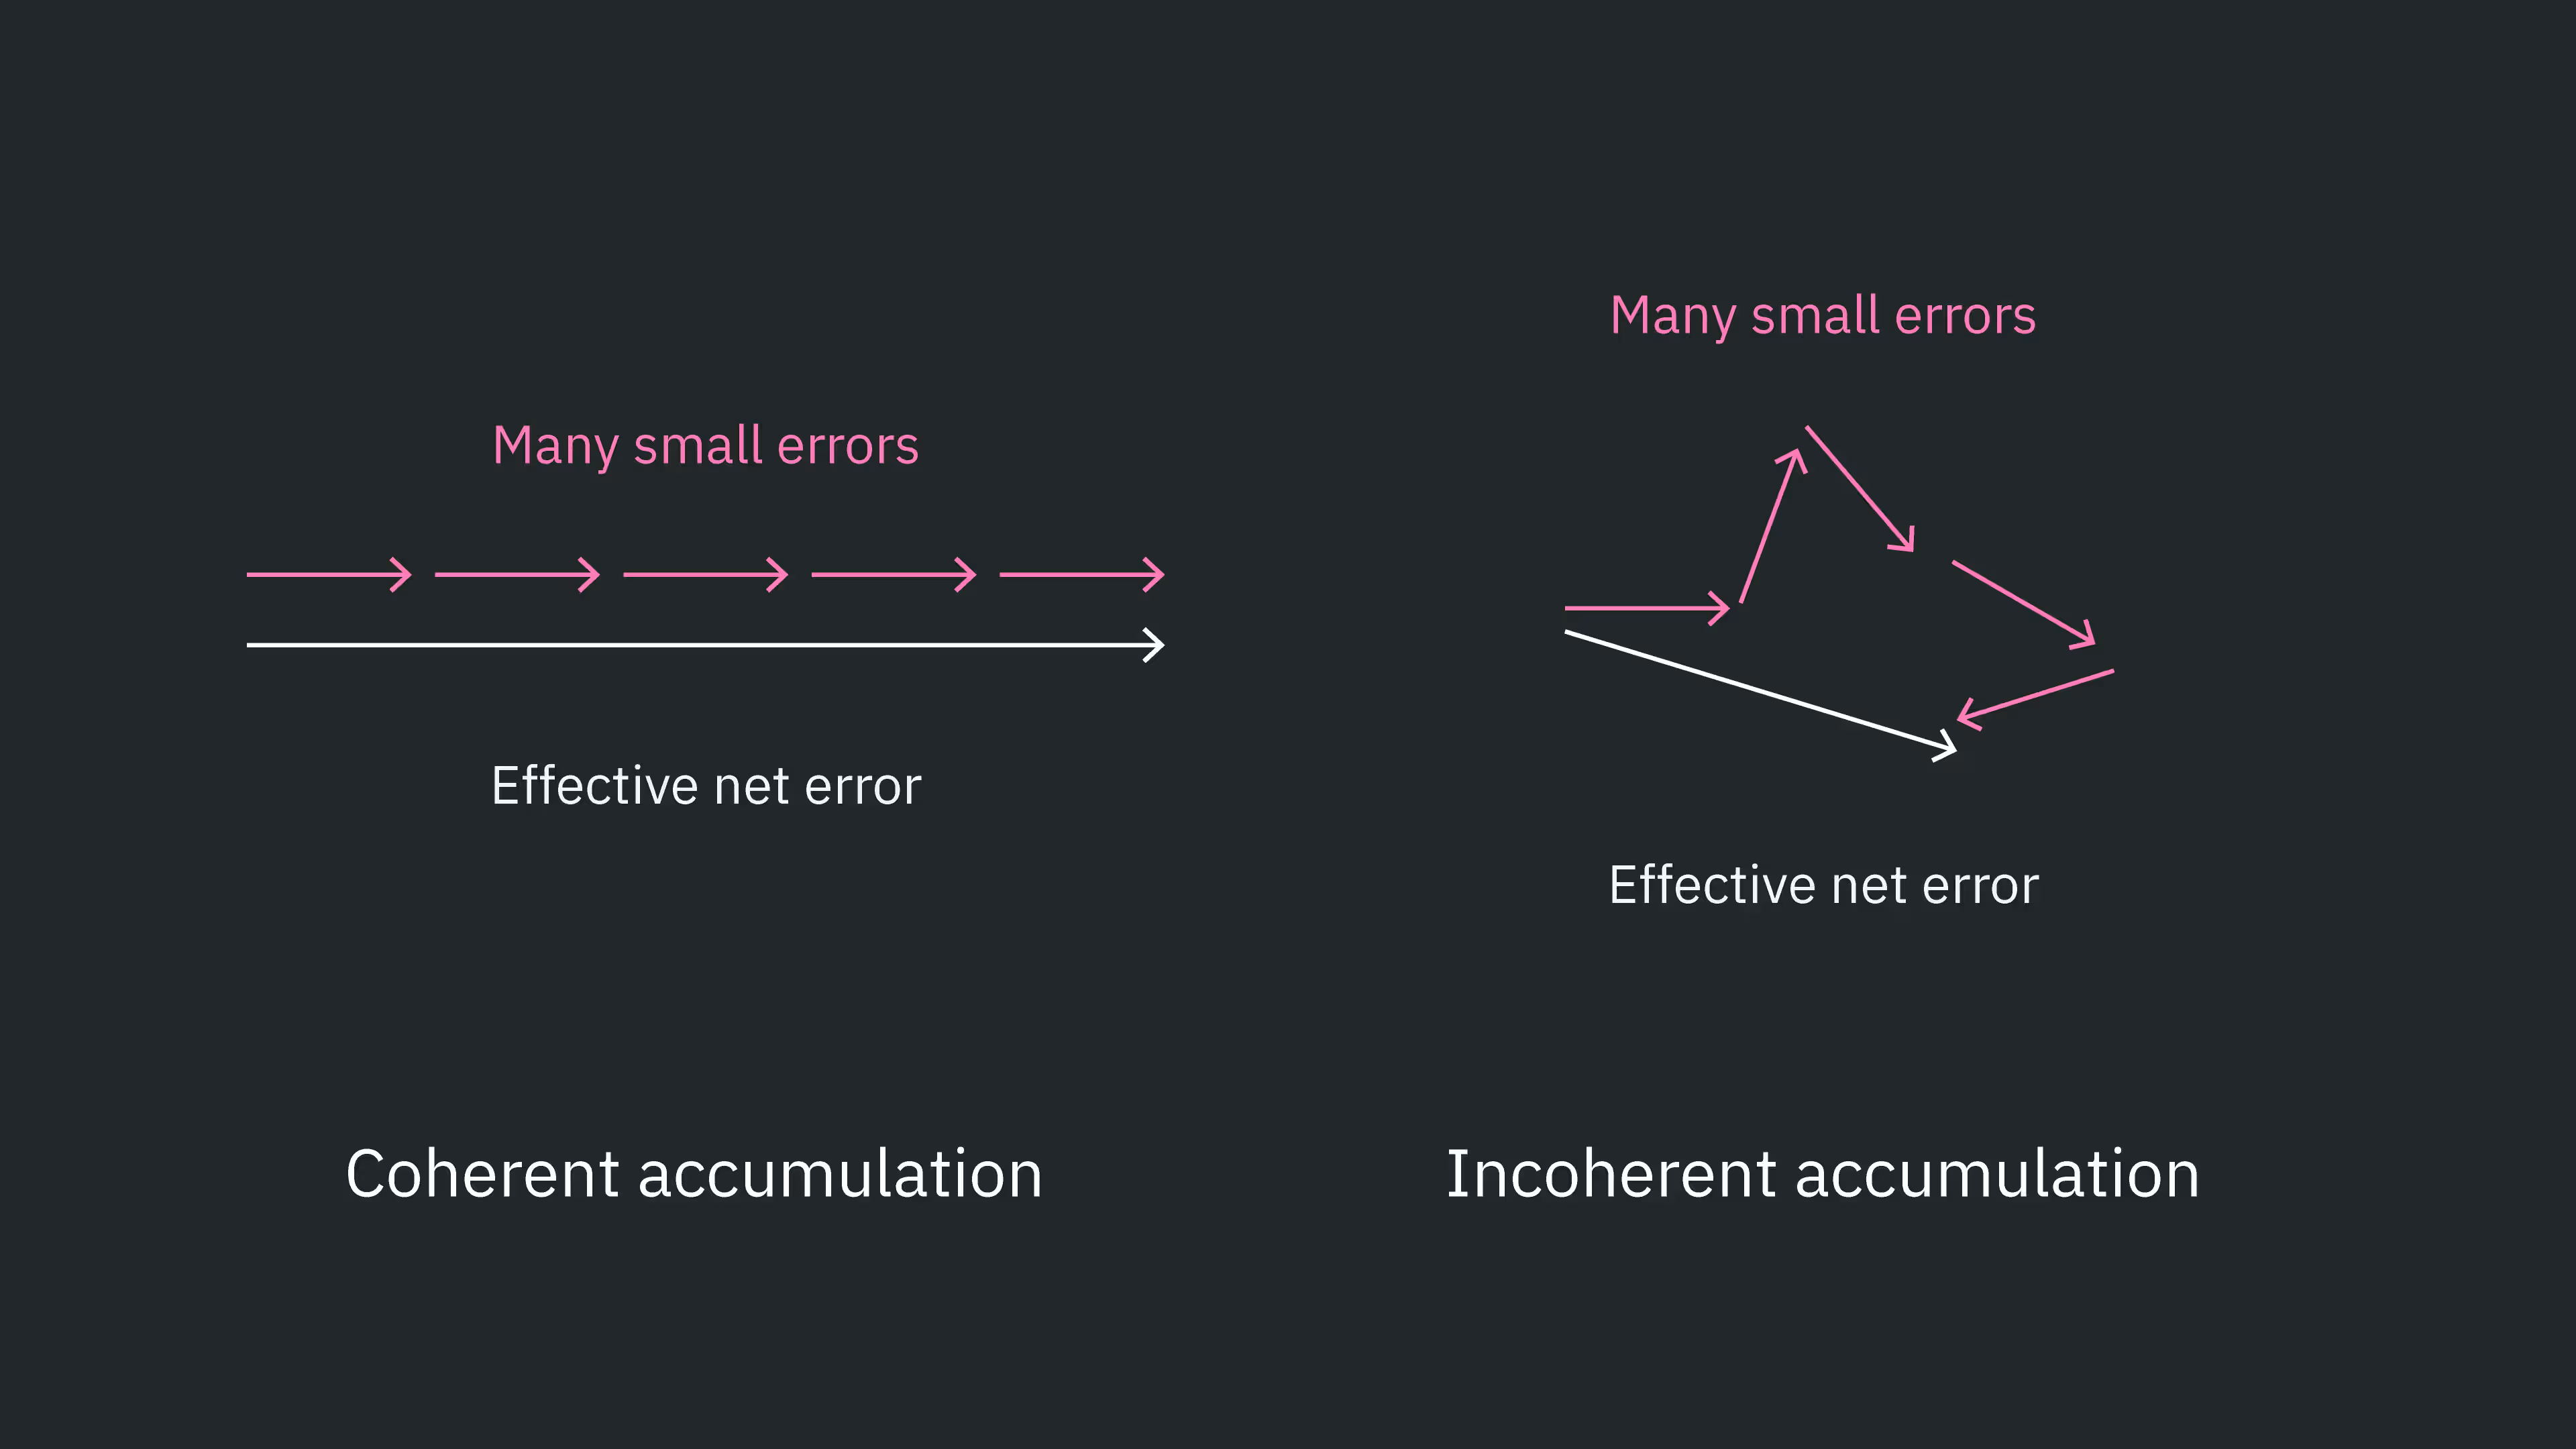
결맞은 오류 누적을 결맞지 않은 오류 누적으로 바꾸면 흔히 더 높은 충실도의 결과를 얻을 수 있습니다. 이를 달성하는 주요한 방법을 __파울리 트윌링__이라고 합니다.
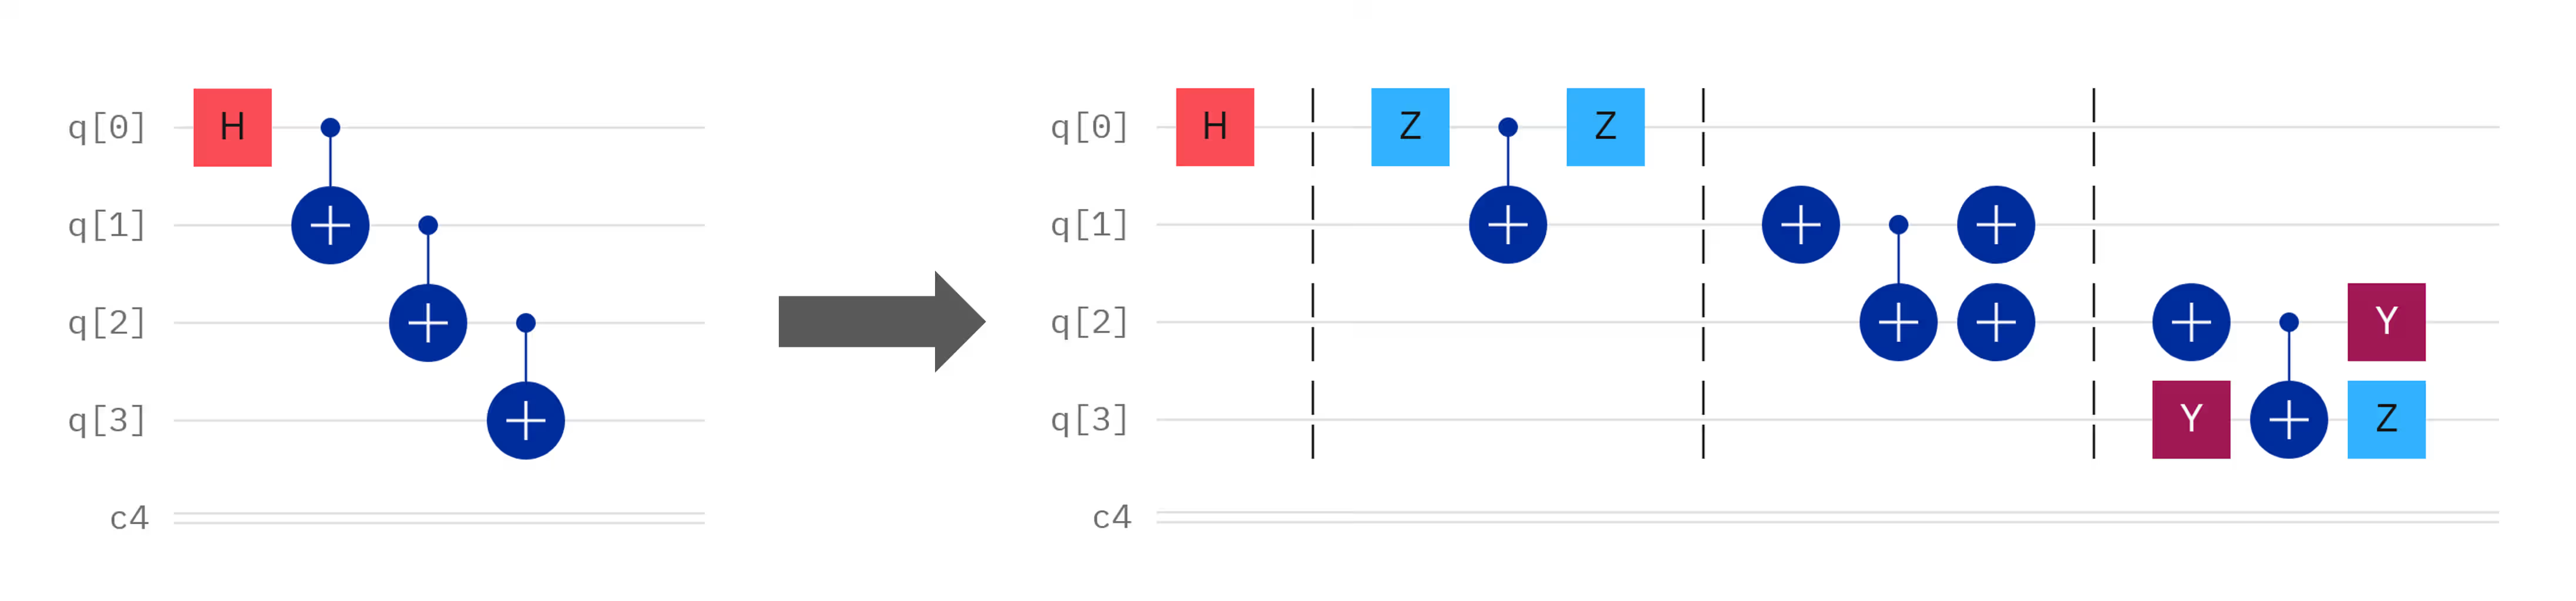
파울리 트윌링이란 원하는 게이트 연산 의 앞뒤에 가 성립하도록 파울리 게이트 의 조합을 추가하는 것을 말합니다. 여기서 과 는 단일 파울리가 아니라 흔히 여러 큐비트에 작용하는 파울리 연산자들의 집합입니다. 추가된 파울리 게이트의 작용이 "항등 연산과 동등하다"고 표현되는 것을 종종 볼 수 있습니다. 하지만 이는 부정확하며 혼란을 줄 수 있습니다. 파울리 게이트는 에 의해 분리되어 있으며, 목표는 모든 게이트의 논리적 작용을 와 동일하게 유지하는 것입니다. 때로는 이 의도된 연산을 억제를 위해 추가된 게이트와 구별하기 위해 를 "페이로드(payload)"라고 부릅니다. CNOT 게이트에 대한 파울리 트윌링의 몇 가지 예시가 아래에 나타나 있습니다.

트윌링이 페이로드의 논리적 효과를 변하지 않게 유지한다는 것을 확인하기 위해 한 가지 예시만 살펴보겠습니다. 일반성을 잃지 않고, 와 을 포함하는 이중 큐비트 상태를 다음과 같다고 합시다:
항상 그렇듯이 우리는 큐비트 순서 규약 을 사용하고 있습니다. 을 타깃으로 하는 CX 게이트를 적용하면 다음을 얻습니다
이제 파울리 트윌링에 X 게이트를 사용하는, 나타낸 세 번째 회로를 살펴봅시다. 행렬들을 단순히 곱하여 CNOT 행렬이 되는지 확인할 수도 있습니다. 또는 아래에서처럼 임의의 양자 상태에 대한 연산을 회로를 통해 추적할 수도 있습니다. 회로의 서로 다른 지점의 상태에는 a-d로 표시가 되어 있습니다.

이는 트윌링을 전혀 사용하지 않고 이전에 얻었던 것과 정확히 같은 입니다. 실제로 이 트윌링된 게이트 시퀀스는 페이로드의 논리적 작용을 변하지 않게 유지합니다. 하지만 레이어마다 서로 다른 유효한 트윌링 시퀀스를 무작위로 선택하면, 결맞은 오류 누적을 사실상 확률적인(결맞지 않은) 오류 누적으로 바꿀 수 있습니다. 명확히 말하면, 하나의 트윌링 패턴을 선택해 회로 전체에서 사용하는 것이 아닙니다. 대신 레이어마다 서로 다른 유효한 트윌링 시퀀스가 선택됩니다. 얽힘 레이어가 많은 예시는 다음과 같이 보일 수 있습니다.
이해도 확인
위 그림의 네 번째 패널에 있는 파울리 트윌링 역시 CNOT의 논리적 효과를 변하지 않게 유지함을 확인하십시오.
답
위 예시를 따라 임의의 이중 큐비트 상태에 대한 작용이 CNOT 연산과 동등함을 보이겠습니다. 이 다이어그램에 표시된 지점을 참조하겠습니다.

이는 큐비트 0을 제어로, 큐비트 1을 타깃으로 하는 CNOT의 작용과 동등합니다.
위에 나와 있지 않은 CNOT 게이트에 대한 파울리 트윌링 시퀀스를 생각해 낼 수 있습니까?
답
네, 다른 예시가 많이 있습니다. 한 가지 예는 CNOT 이전에 를, CNOT 이후에 와 를 두는 것입니다.
파울리 트윌링을 사용해야 할 때
여기서 소개한 대로 파울리 트윌링은 다중 큐비트 게이트에만 적용됩니다. 단일 큐비트 게이트에 유사한 프로토콜을 적용하려면 다른 논리가 필요하며 실제로는 대체로 유용하지 않습니다. 파울리 트윌링 자체는 여러 단일 큐비트 게이트(파울리 게이트)를 사용합니다. 추가된 파울리 게이트는 결맞은 오류 누적을 무작위화하여 얻는 이점보다 더 많은 오류를 초래할 가능성이 큽니다. 이중 큐비트 게이트와 관련된 오류율은 단일 큐비트 게이트와 관련된 오류율보다 훨씬 큽니다. 게다가 일부 단일 큐비트 게이트는 비클리포드(non-Clifford)이어서 완전히 트윌링할 수 없습니다. 이것이 바로 Qiskit이 단일 큐비트 게이트가 아닌 이중 큐비트 게이트 주위를 자동으로 트윌링하는 파울리 트윌링 옵션을 포함하는 이유입니다.
이는 위 그림에 암묵적으로 나타나 있었습니다. 파울리 트윌링은 CX 게이트 주위에는 구현되었지만 아다마르 게이트 주위에는 구현되지 않았습니다.
파울리 트윌링이 실제로 작동하는 두 가지 예시를 살펴봅시다.
결맞은 누적을 억제하기 위한 파울리 트윌링
파울리 트윌링이 결맞은 오류 누적을 더 느린 결맞지 않은 누적으로 바꾸는 과정을 관찰하기 위해, 결맞은 오류 스트레스 테스트 역할을 하는 회로와 관측량이 필요합니다. 유일한 목적은 결맞게 누적되는 이중 큐비트 오류를 눈에 보이게 만든 다음, 파울리 트윌링이 그 결맞은 누적을 확률적 감쇠로 어떻게 바꾸는지 보여주는 것입니다.
CNOT(또는 CZ) 게이트는 결맞은 오류의 흔한 원인입니다. 이 경우 할 수 있는 가장 간단한 실험은 상태(예를 들어 )를 초기화하고, 쌍을 이룬 CNOT 게이트의 레이어를 적용(두 개의 CNOT이 항등 연산이 된다는 사실을 이용)한 다음, 파울리 트윌링을 사용할 때와 사용하지 않을 때 모두에 대해 레이어 수가 증가함에 따라 오류가 어떻게 누적되는지 확인하는 것입니다.
관심 있는 관측량은 단일 큐비트에 대한 이며, 이를 CNOT 쌍의 반복 횟수의 함수로 그래프를 그립니다.
# --- Imports ---

import numpy as np
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
# Build the circuit with CX/CX identity per layer

def identity_cx_pairs(layers: int) -> QuantumCircuit:
    q = QuantumRegister(2, "q")
    c = ClassicalRegister(1, "c")  # we only measure q0
    qc = QuantumCircuit(q, c, name=f"N={layers}")

    # |+> on q0
    qc.h(q[0])

    for _ in range(layers):
        qc.barrier()
        qc.cx(q[0], q[1])
        qc.cx(q[0], q[1])

    # Measure in X basis: H then measure q0

    qc.h(q[0])
    qc.measure(q[0], c[0])

    return qc
측정 전에 기저를 회전시켰으므로, 의 측정은 마지막 아다마르 게이트 직전에 상태가 였음을 의미하며, 과 에 대해서도 마찬가지입니다. 따라서 우리의 기댓값 은 의 카운트에서 의 카운트를 뺀 값으로 간단히 계산할 수 있습니다.
# Compute <X> from SamplerV2 counts

def x_expect_from_counts(counts: dict[str, int]) -> float:
    shots = sum(counts.values())
    p0 = counts.get("0", 0) / shots
    p1 = counts.get("1", 0) / shots
    return p0 - p1  # <X> = P(0) - P(1) after H,measure
오류가 누적되도록 할 적절한 수의 CNOT 레이어를 선택하고, 회로를 구성한 다음 트랜스파일합니다.
# Choose the number of layers for the experiment
N_layers_list = [0, 1, 2, 3, 4, 5]

circuits = [identity_cx_pairs(n) for n in N_layers_list]

# Transpile to backend ISA so that primitives run native instructions
pm = generate_preset_pass_manager(backend=backend, optimization_level=0)
isa_circuits = [pm.run(c) for c in circuits]
각 레이어가 하나 이상의 이중 큐비트 게이트로 구성된다는 점을 유념하십시오. 아래 함수를 사용해 트랜스파일된 이중 큐비트 깊이를 모니터링하십시오.
# We can check the 2-qubit depths of any of our circuits like this:
print(
    "two-qubit depth",
    isa_circuits[5].decompose().depth(lambda instr: len(instr.qubits) > 1),
)
two-qubit depth 15
# Configure two Samplers: (A) no twirling, (B) gate twirling
#    - No DD, no measurement twirling in both (to isolate gate twirling)
# ------------------------------
shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
이제 작업(job)을 실행합니다.
# Run both jobs; extract counts; compute <X>

# Helper to run a sampler and compute <X> per circuit
def run_and_x_expect(sampler: Sampler, circ_list: list[QuantumCircuit]) -> list[float]:
    job = sampler.run(
        circ_list
    )  # shots taken from options.default_shots unless overridden
    result = job.result()
    # For SamplerV2, use join_data().get_counts() to combine registers if needed
    exp_vals = []
    for pub in result:
        counts = pub.join_data().get_counts()
        exp_vals.append(x_expect_from_counts(counts))
    return exp_vals

x_no_twirl = run_and_x_expect(sampler_no_twirl, isa_circuits)
x_twirl = run_and_x_expect(sampler_twirl, isa_circuits)

# ------------------------------
# 6) Print a small table
# ------------------------------
print("\nN_layers   <X> (no twirl)   <X> (gate twirl)")
for n, a, b in zip(N_layers_list, x_no_twirl, x_twirl):
    print(f"{n:7d}   {a:14.6f}   {b:14.6f}")
N_layers   <X> (no twirl)   <X> (gate twirl)
      0         0.984375         0.987549
      1         0.934326         0.936523
      2         0.844238         0.892822
      3         0.712158         0.879395
      4         0.592529         0.844971
      5         0.449463         0.785156
마지막으로 이 결과를 시각화합니다.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using XX
ax.scatter(
    N_layers_list, x_no_twirl, c="blue", linestyle="-", label="No twirl", alpha=0.7
)

## Add values with XY4
ax.scatter(N_layers_list, x_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7)

# Add labels and plot
ax.set_xlabel("CX layers")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Pauli twirling")
ax.grid(True)

plt.show()
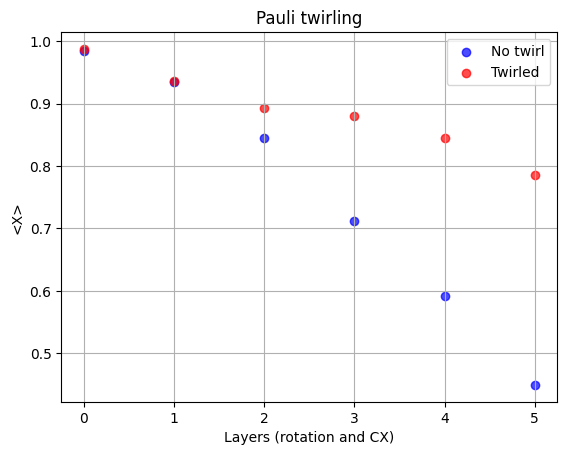
트윌링된 회로가 이상적인 에 더 가까운 기댓값을 낸다는 것을 명확히 알 수 있습니다. 이 예시는 그 목적을 다했으니, 더 유용한 것으로 넘어가 봅시다. 바로 고도로 얽힌 상태의 생성에서의 트윌링입니다.
GHZ 상태 준비에서의 파울리 트윌링
앞선 예시는 CNOT 게이트와 관련된 오류의 결맞은 누적을 무너뜨리는 데 있어 파울리 트윌링이 설득력 있는 사례임을 보여주었습니다. GHZ 상태 생성은 많은 양자 컴퓨팅 응용에 유용한 고도로 얽힌 상태를 만들기 위해 많은 CNOT 게이트를 사용합니다. 크기가 커지는 GHZ 상태를 통해 이러한 맥락에서 파울리 트윌링이 어떻게 도움이 되는지 살펴봅시다.
# Imports if not already loaded in previous cells
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit

# Define a GHZ circuit building function, so that we can build GHZ states of increasing size.

def ghz_circuit(n: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q[0])
    for i in range(n - 1):
        qc.cx(q[i], q[i + 1])

    qc.barrier()

    qc.measure(q, c)
    return qc

# Build a test state with 10 qubits to remind ourselves of GHZ structure.

num_qubits = 10

qc_ghz = ghz_circuit(num_qubits)
qc_isa = pm.run(qc_ghz)
qc_ghz.draw("mpl")
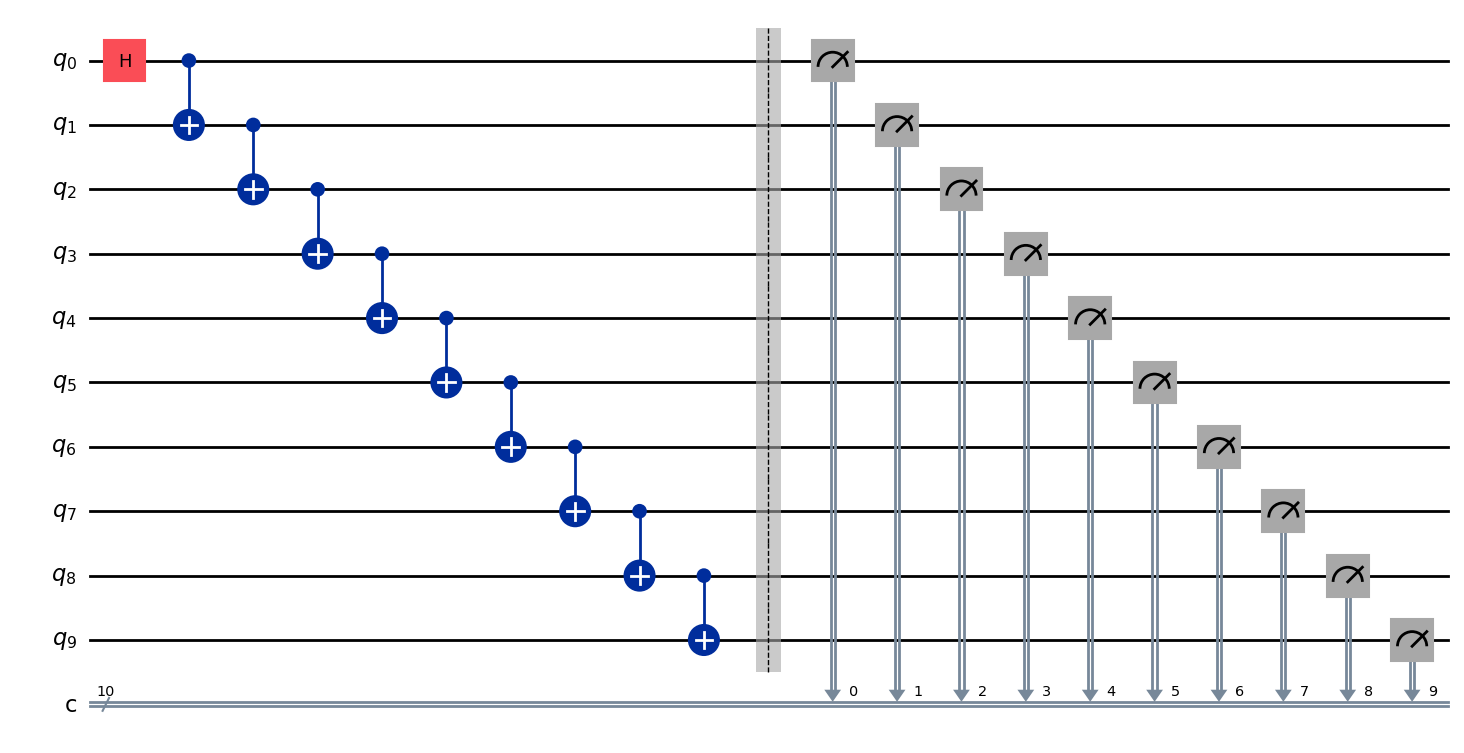
이제 회로를 구성하고 트랜스파일합니다. 이 경우에는 항등 연산으로 환원되는 인위적으로 반복된 게이트가 없습니다. 따라서 패스 매니저가 조금 더 최적화를 하도록 허용할 수 있습니다. 이를 레벨 3으로 설정하겠습니다.
# Set up a pass manager

opt_level = 3
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

# Build GHZ circuits of increasing size.

nmin = 5
nmax = 15
circuits = []
for n in range(nmin, nmax):
    qc = ghz_circuit(n)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
최적화기가 우리의 추상 회로를 큐비트 123, 124, 136, 142, 143에 매핑했음을 알 수 있습니다.
circuits[0].draw("mpl")
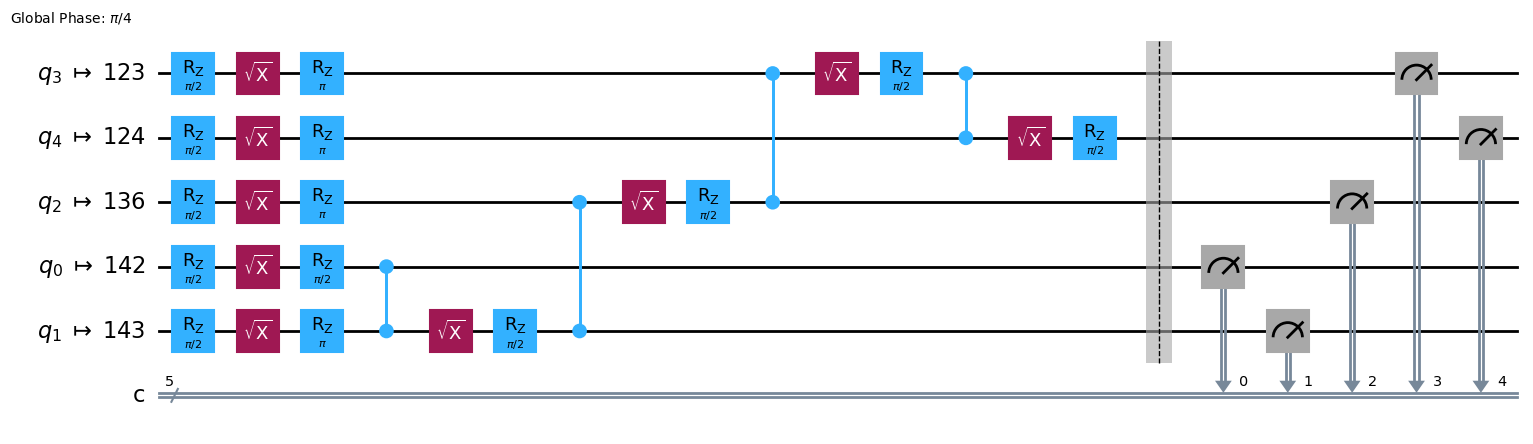
그 이유를 이해하기 위해 백엔드 배치도를 살펴봅시다(이 이미지에서는 ibm_fez이지만, 어떤 백엔드에서든 동등한 분석을 수행할 수 있습니다).
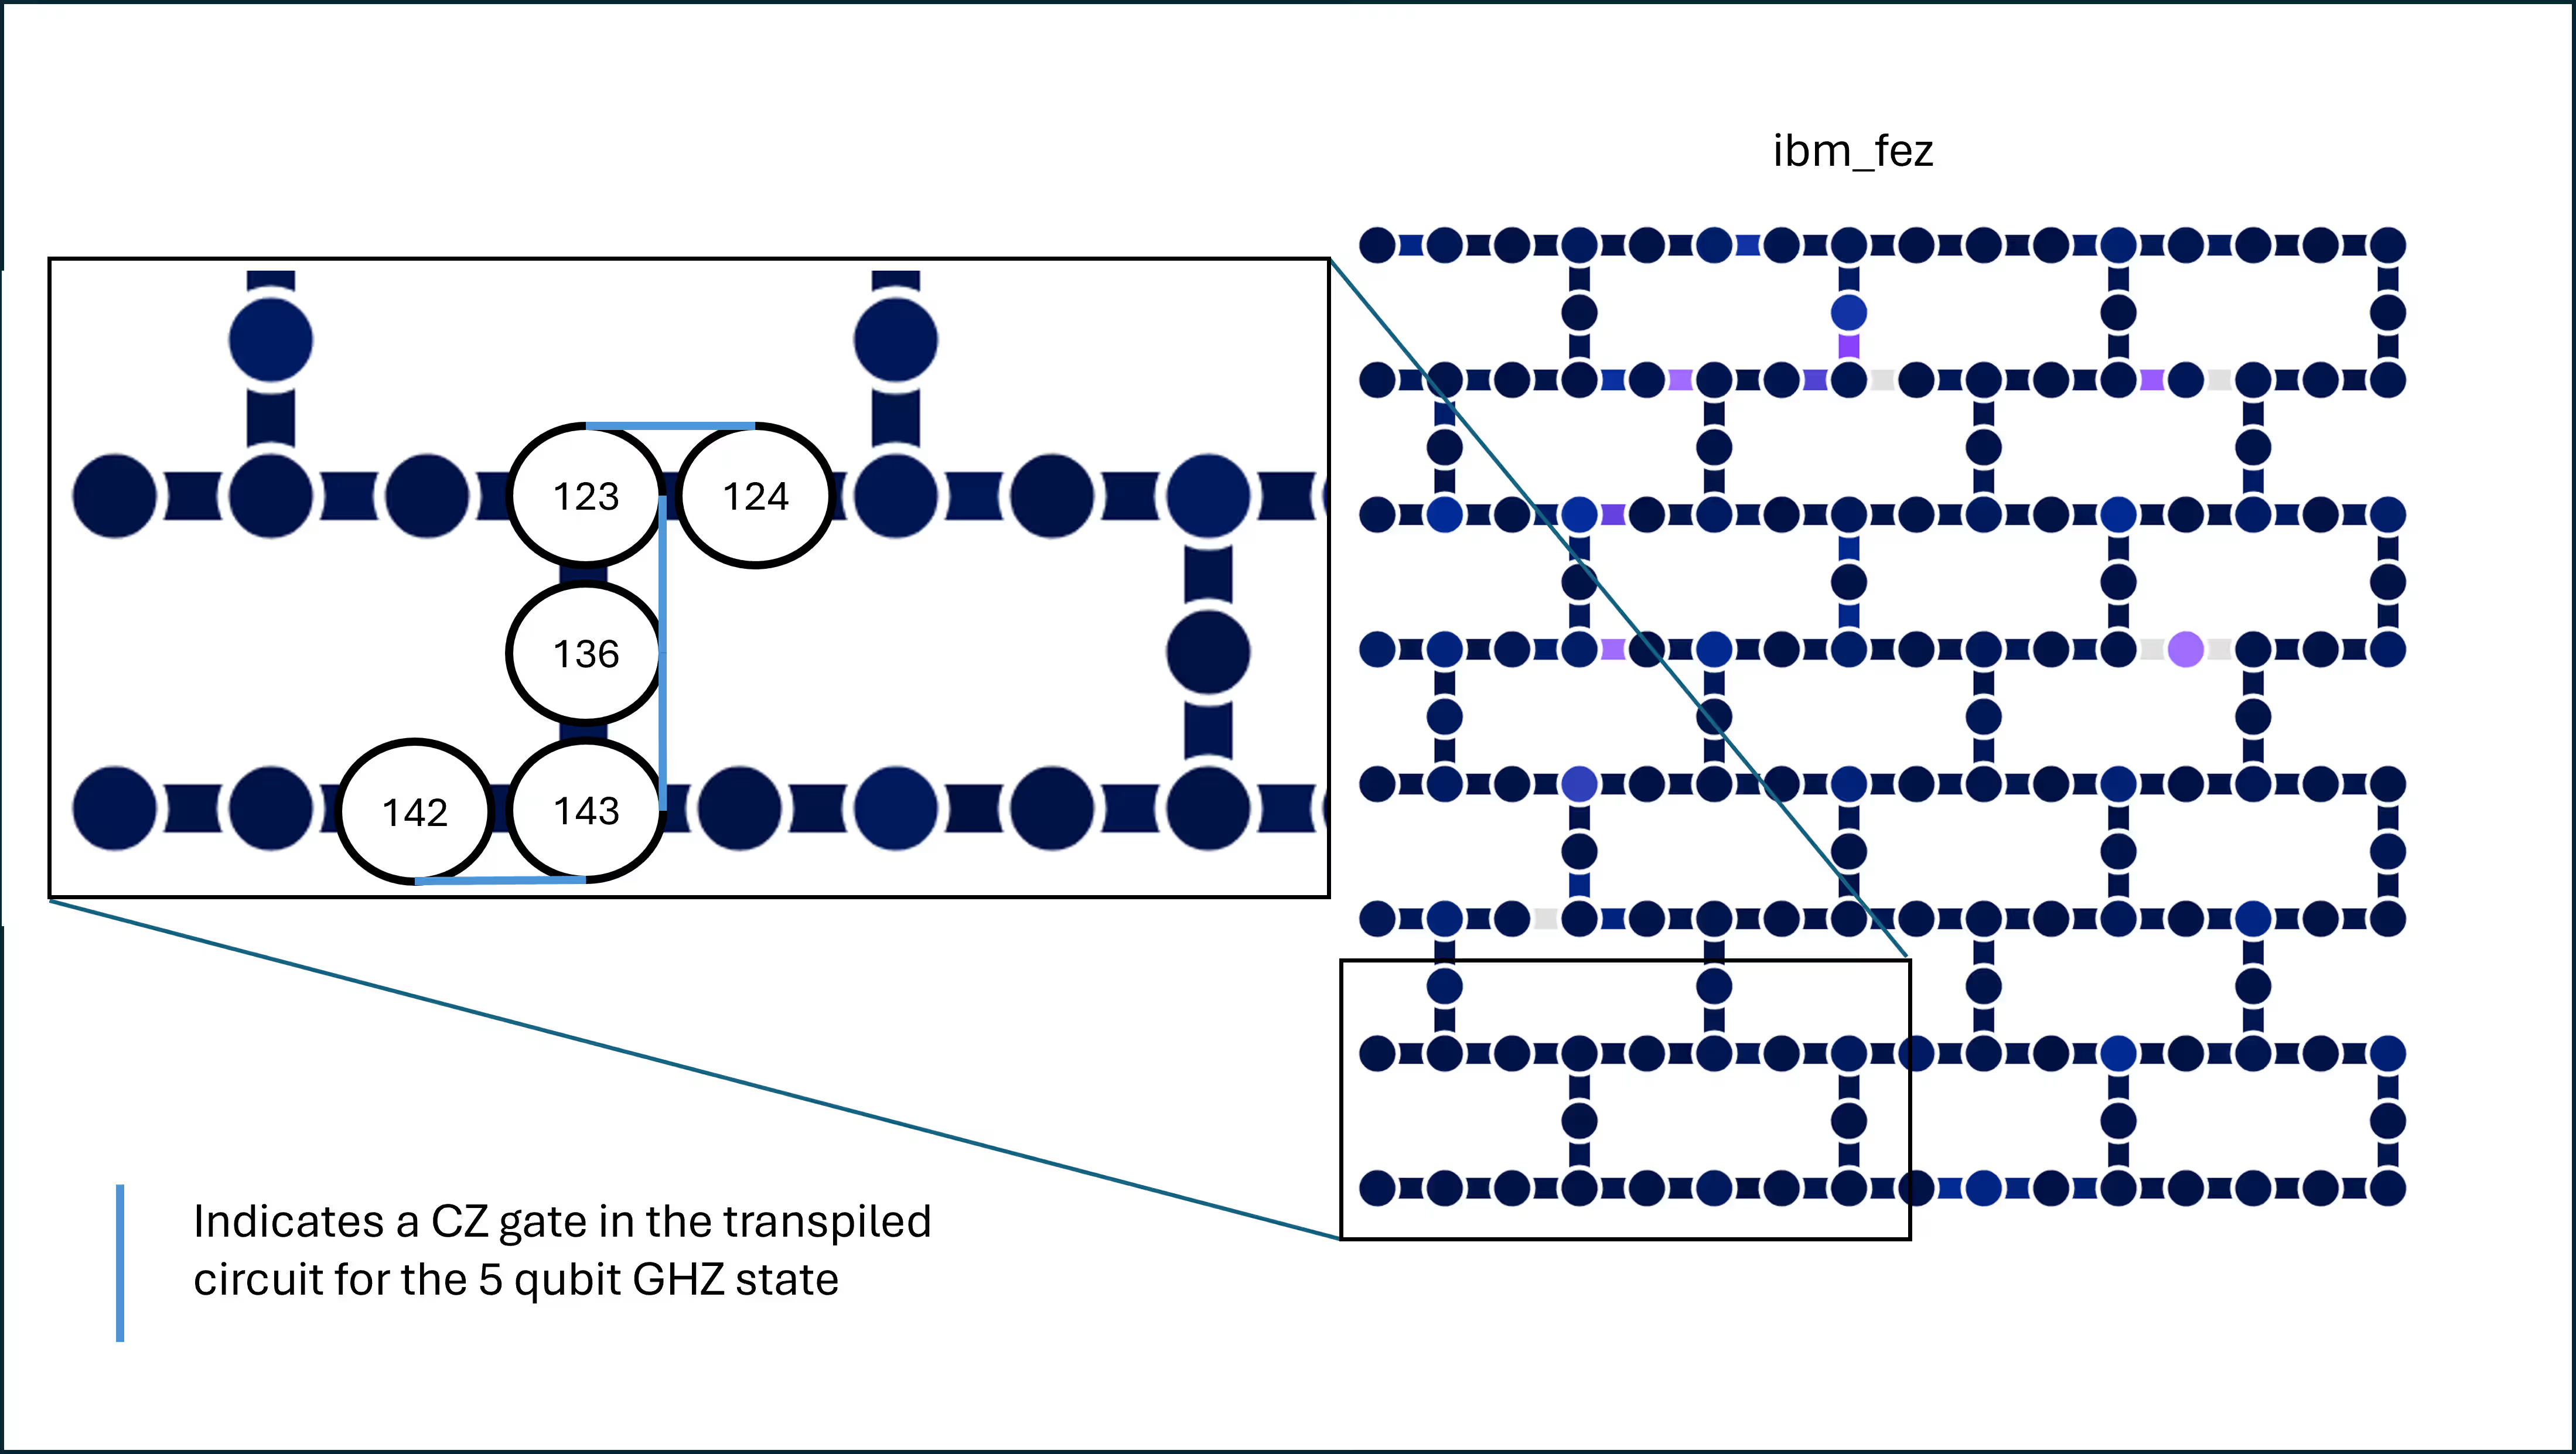
큐비트들이 스왑 게이트, 즉 회로 깊이를 최소화하기 위해 체인 형태로 선택되었음을 알 수 있습니다. 또한 회로에서 구현된 각 CZ 게이트는 인접한 큐비트 사이에 있습니다. 마지막으로 다섯 큐비트 모두 판독 할당 오류율을 포함해 비교적 낮은 오류율을 갖고 있습니다. 이러한 오류율은 Compute resources 페이지에서 어떤 백엔드에서든 확인할 수 있습니다. 이러한 배치를 찾는 것은 단순한 선형 체인의 경우 어렵지 않지만, 문제가 더 복잡해질수록 회로 배치의 최적화는 더 어려워지고 더 가치 있어집니다.
이제 Sampler 프리미티브를 구성합니다. 파울리 트윌링에 집중하기 위해 다른 억제/완화 도구는 끕니다.
# Configure two Samplers: (A) no twirling, (B) gate twirling
# No DD, no measurement twirling in both (to isolate gate twirling)

shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
마지막으로 작업을 실행합니다. 나중에 다시 가져오기 위해 작업 ID 번호를 원한다면 출력할 수 있습니다.
job = sampler_twirl.run(circuits)
res_ghz_twirl = job.result()
job_id = job.job_id()  # job id for twirling on/true
print("job number for twirling the ghz prep is ", job_id)

job = sampler_no_twirl.run(circuits)
res_ghz_no_twirl = job.result()
job_id = job.job_id()  # job id for twirling off/false
print("job number for NO twirling the ghz prep is ", job_id)
job number for twirling the ghz prep is  d7h967bjne2c7393s0b0
job number for NO twirling the ghz prep is  d7h96f7b91ec73aufing
트윌링을 사용한 경우와 사용하지 않은 경우 모두에 대해 모든 회로에서 측정된 각 계산 기저 상태의 카운트를 추출합니다.
# --------- Extract counts per circuit ----------
def extract_counts_list(res):
    counts_list = []
    for r in res:  # each r corresponds to one circuit
        # r.data.<classical_register_name>.get_counts()
        counts = r.data.c.get_counts()
        counts_list.append(counts)
    return counts_list

counts_list_ghz_twirl = extract_counts_list(res_ghz_twirl)
counts_list_ghz_no_twirl = extract_counts_list(res_ghz_no_twirl)
print(counts_list_ghz_twirl[0])
print(counts_list_ghz_twirl[4])
{'11111': 3440, '11101': 87, '00000': 3434, '10111': 87, '00001': 168, '10011': 4, '11000': 102, '00011': 39, '01111': 93, '00111': 111, '01000': 90, '11110': 235, '00110': 6, '00010': 75, '11011': 30, '11100': 42, '10000': 82, '00101': 7, '10001': 2, '11001': 6, '11010': 5, '01010': 3, '01110': 7, '00100': 14, '10101': 1, '10110': 8, '01001': 6, '10100': 1, '01101': 4, '01011': 1, '10010': 2}
{'111111111': 2683, '000000000': 2976, '111000000': 53, '110000000': 74, '111111100': 47, '111011111': 76, '111111110': 195, '111111000': 67, '000000010': 66, '011111110': 10, '011110001': 1, '101110111': 7, '101011111': 9, '111110111': 87, '111100000': 96, '111011000': 2, '010000000': 60, '111111010': 3, '100000000': 110, '111111011': 32, '000000111': 51, '000100000': 84, '000011111': 82, '000000001': 176, '100000010': 6, '111100001': 3, '000000011': 36, '101111111': 98, '100000011': 2, '001111111': 75, '000001000': 60, '000011101': 4, '110111111': 38, '111111101': 72, '111100100': 3, '000100010': 1, '001011101': 1, '000000110': 8, '110000011': 1, '000111111': 48, '000000100': 23, '000001111': 65, '010000101': 2, '000100001': 8, '111110000': 51, '010001111': 1, '111000111': 2, '111000001': 2, '000111100': 1, '011111111': 116, '111110001': 1, '000011110': 10, '000010000': 23, '000101111': 3, '000101110': 1, '011110111': 4, '010000111': 7, '111101111': 36, '001000000': 40, '010100000': 3, '101111110': 8, '110111000': 5, '000000101': 8, '010000010': 4, '000110001': 2, '110111110': 4, '111100010': 2, '111010111': 2, '000001110': 5, '111110101': 3, '001110000': 4, '101100000': 5, '001111110': 8, '100000001': 5, '111011110': 3, '111110100': 5, '110001011': 1, '001110111': 4, '000010110': 2, '111001111': 2, '000011000': 5, '010111110': 1, '000101000': 4, '101000000': 4, '100111111': 4, '111110011': 2, '000101100': 1, '101111100': 2, '111011100': 1, '001111011': 3, '011111011': 3, '110100000': 5, '000001011': 3, '111110110': 5, '111111001': 5, '000001001': 8, '010000001': 5, '011111101': 2, '001010111': 1, '011101110': 1, '110110110': 1, '001111100': 3, '100001000': 3, '001000011': 1, '001011111': 6, '110000010': 2, '110010000': 1, '010011111': 2, '111101101': 3, '101110000': 1, '111100111': 6, '010111111': 5, '110110000': 2, '011011111': 2, '110011111': 1, '110000111': 6, '001000001': 2, '001100000': 3, '101101111': 1, '000111110': 5, '111011101': 2, '100100000': 2, '101111101': 3, '001001111': 1, '001010000': 2, '111001000': 1, '011110000': 2, '011101111': 3, '000001100': 1, '110101000': 1, '011000000': 4, '111101000': 3, '110000001': 4, '000010111': 4, '011111100': 1, '111000010': 1, '101011000': 1, '101111000': 2, '001101111': 1, '010001100': 1, '000100011': 1, '111110010': 1, '111101110': 1, '100001111': 1, '100011011': 1, '010110111': 1, '001110110': 2, '100000100': 1, '001000110': 1, '100011111': 2, '010010001': 1, '111010110': 1, '011110110': 1, '000111000': 2, '000100111': 1, '011010000': 1, '001111000': 2, '100010000': 1, '011111000': 2, '110111100': 2, '110110111': 1, '110001000': 1, '000110111': 1, '000101011': 1, '000110000': 1, '011100000': 3, '001000010': 1, '001001000': 1, '001000111': 1, '001111101': 3, '111101011': 1, '111010000': 1, '100000101': 1, '000010010': 1, '001011110': 1, '000011011': 1, '111101100': 1}
GHZ 상태의 이상적인 분포는 샷의 절반이 을 반환하고 나머지 절반이 을 반환하는 분포임을 알고 있습니다. 비교를 위해 이를 구성합니다.
ideal_dist = []
for n in range(nmin, nmax):
    ideal_dist.append({"0" * n: int(shots / 2), "1" * n: int(shots / 2)})
이제 최종 상태의 품질을 측정하기 위해 헬링거 충실도(Hellinger fidelity)를 사용합니다.
from qiskit.quantum_info import hellinger_fidelity

num_qubits = []
fidelities_twirl = []
fidelities_no_twirl = []
for n in range(len(ideal_dist)):
    num_qubits.append(nmin + n)
    fidelities_twirl.append(hellinger_fidelity(counts_list_ghz_twirl[n], ideal_dist[n]))
    fidelities_no_twirl.append(
        hellinger_fidelity(counts_list_ghz_no_twirl[n], ideal_dist[n])
    )
마지막으로 결과를 그래프로 그립니다.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using no twirling
ax.scatter(
    num_qubits,
    fidelities_no_twirl,
    c="blue",
    linestyle="-",
    label="No twirl",
    alpha=0.7,
)

## Add values with twirling
ax.scatter(
    num_qubits, fidelities_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Qubits in GHZ state")
ax.set_ylabel("Hellinger fidelity")
ax.legend()
ax.set_title("Pauli twirling in GHZ states")
ax.grid(True)

plt.show()
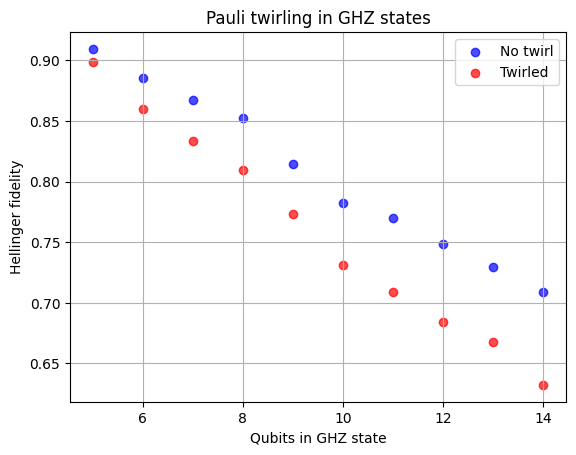
파울리 트윌링을 사용한 결과는 트윌링을 사용하지 않은 경우보다 나아지지 않았으며(오히려 약간 더 나쁩니다). 무슨 일이 일어난 것일까요?
두 가지 일이 일어났습니다. 첫째, 파울리 트윌링은 전체 노이즈의 양을 줄이지 않습니다 — 오히려 결맞고 체계적인 오류를 확률적 파울리형 오류로 재구성하여, 오류 증가가 예측 가능하고 모델링 가능하게 만듭니다. 특별한 경우를 제외하면 오류 감소에 대한 어떠한 약속도 애초에 없었습니다.
둘째, GHZ 회로에서는 GHZ 구성의 대칭성 때문에 일부 결맞은 오류가 부분적으로 상쇄되거나 무해한 위상 이동처럼 작용할 수 있습니다. 트윌링은 이러한 우연적인 보호를 제거하고 이를 상관관계가 없는 확률적 파울리 노이즈로 대체하므로, 트윌링을 적용하면 GHZ 충실도가 약간 더 나빠집니다.
이 두 번째 주장은 약간의 설명이 필요합니다. 이 주장은 GHZ 회로가 모든 종류의 결맞은 오류 누적으로부터 보호된다는 것이 아니라, 오직 일부 종류로부터만 보호되며 — 그러한 경우에 그 보호가 트윌링에 의해 무너진다는 것입니다. 구체적으로, CX 게이트와 관련된 결맞은 과회전을 생각해 봅시다. 과회전이 있는 실제 CX 게이트를 라고 부르겠습니다:
여기서 는 , , , 등과 같은 파울리 연산자의 임의의 곱입니다. 일반적인 상태의 경우, 이러한 과회전 중 어느 것이라도 측정 통계(따라서 상태 충실도의 척도)에 영향을 줄 수 있습니다. 하지만 이 중 일부는 와 같은 연산자를 포함하여 많은 표준 GHZ 관측량을 변화시키지 않고 그대로 둡니다. GHZ 상태를 준비하는 맥락에서, 이러한 유형의 관련 과회전 오류는 다음과 같습니다:
전체 -큐비트 GHZ 상태의 준비는 다음과 같이 보일 것입니다:
GHZ 상태를 준비한 후, 이상적으로 상태는 다음과 같습니다:
이 상태는 다음을 포함하는 많은 파울리 연산자 집합의 동시 고유상태입니다:
고유값 을 가집니다. 그 결과, 형태의 연산자는 GHZ 상태에 위상 인자 을 곱하는 형태로 작용하며, 이는 패리티, 집단 , 또는 계산 기저 모집단과 같은 표준 GHZ 관측량에 영향을 미치지 않습니다. 따라서 과회전 오류 가 결맞고 체계적이더라도, GHZ 충실도를 평가하는 데 사용되는 측정에는 사실상 보이지 않습니다. 이러한 의미에서 GHZ 회로는 우연한 결맞음 보호를 누립니다: 특정 결맞는 CX 오류는 준비되는 상태의 구조와 교환되므로 측정된 성능을 저하시키지 않습니다.
파울리 트월링은 이 상황을 근본적으로 바꿉니다. 트월링은 결맞는 과회전 오류를 결정론적인 프로세스로 보존하지 않습니다. 대신, 결맞는 오류 채널을 효과적인 확률적 파울리 채널로 변환합니다. 그 결과, 오류 채널에는 이제 GHZ 안정자와 교환되지 않는 , , , 와 같은 항이 포함됩니다.
이러한 확률적 파울리 오류가 발생하면, 개별 큐비트 또는 큐비트 쌍에 실제 비트 플립 및 위상 플립 결함이 생성됩니다. 이러한 오류는 상태를 GHZ 안정자 부분공간에서 벗어나게 하여, 과 사이의 간섭을 줄이고, GHZ 충실도와 다중 큐비트 패리티 신호를 직접적으로 낮춥니다. 다시 말해, 파울리 트월링은 오류의 결맞는 구조를 제거하지만, 이전에 그 오류들을 무해하게 만들었던 대칭 기반 상쇄도 함께 제거합니다. 그 결과는 약간 더 나쁜 GHZ 상태입니다 — 트월링이 노이즈를 추가해서가 아니라, 대체로 무해했던 결맞는 오류를 실제로 해로운 확률적 오류로 변환하기 때문입니다.
이 예시는 중요한 교훈을 보여줍니다: 파울리 트월링은 만능 개선 전략이 아닙니다. 결맞는 오류가 회로 전체에 걸쳐 필요한 충실도를 파괴하는 방식으로 누적될 때 가장 유익합니다. GHZ 상태 준비와 같은 고도로 대칭적인 회로에서는, 일부 결맞는 오류가 자연스럽게 상태의 안정자와 정렬되어 있으며, 이를 의도적으로 무작위화하면 이러한 우연한 보호가 사라질 수 있습니다.
방법 결합하기
원칙적으로 파울리 트월링을 동적 디커플링과 결합할 수 있습니다. 이 경우 두 가지 이유로 DD를 사용하지 않았습니다: 첫째, 이 회로에는 극도로 긴 유휴 기간이 없어야 합니다. 둘째, GHZ 상태는 정보의 대부분을 단일 큐비트 위상 결맞음에 저장하지 않습니다. 특히 원하는 비트스트링 과 사이의 위상이 아니라 비트스트링 카운트 측면에서만 충실도를 관찰하는 경우 더욱 그렇습니다.
만약 GHZ 준비를 100개 이상의 큐비트로 확장한다면, 첫 번째/초기 큐비트를 측정하는 데 걸리는 지연이 실제로 DD가 유용할 만큼 충분히 길어질 수 있습니다. 이는 회로의 트랜스파일된 깊이를 고려할 때 특히 그렇습니다.
RTZ 에코 구조에서의 파울리 트월링
결맞는 오류 누적을 줄이는 맥락에서 파울리 트월링의 마지막 예제는 X-CZ-X-CZ 조합 레이어로 이루어진 회로를 사용합니다. 이것은 트월링 없이도 2큐비트 게이트에서 결맞는 ZZ 오류 항을 상쇄하는 데 자주 사용되는 잘 알려진 게이트 시퀀스입니다. 하지만 트월링과 함께 사용하면, 다른 형태의 결맞는 오류 누적을 줄이거나 무작위화할 수 있습니다.
먼저 다양한 개수의 레이어로 RTZ와 유사한 회로를 구축하는 함수를 정의하는 것부터 시작하겠습니다.
from qiskit import QuantumCircuit

def rtz_echo_circuit(n_qubits: int, depth: int) -> QuantumCircuit:
    """
    Construct an RTZ echo-style circuit.

    Args:
        n_qubits: Number of qubits in the circuit.
        depth: Number of repeated echo layers.

    Returns:
        A QuantumCircuit implementing the echo sequence with measurements.
    """
    q = QuantumRegister(n_qubits, "q")
    c = ClassicalRegister(n_qubits, "c")
    qc = QuantumCircuit(q, c)

    for _ in range(depth):
        qc.h(q)

        for i in range(0, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.x(q)

        for i in range(1, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.h(q)

    qc.measure(q, c)
    return qc
이제 합리적인 총 트랜스파일된 2큐비트 깊이까지 레이어 수를 늘려가며 회로를 구축합니다.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

circuits = []
qcs = []
depths = list(range(3, 27, 4))
n_qubits = 10

opt_level = 0
pm = generate_preset_pass_manager(
    optimization_level=opt_level,
    backend=backend,
    initial_layout=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9],
)

for d in depths:
    qc = rtz_echo_circuit(n_qubits, d)
    qcs.append(qc)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
# We can check the 2-qubit depths of any of our circuits like this:
two_qubit_depths = []
for n in range(len(circuits)):
    two_qubit_depths.append(
        circuits[n].decompose().depth(lambda instr: len(instr.qubits) > 1)
    )
print(two_qubit_depths)
[6, 14, 22, 30, 38, 46]
qcs[0].draw("mpl")
# circuits[0].draw("mpl")
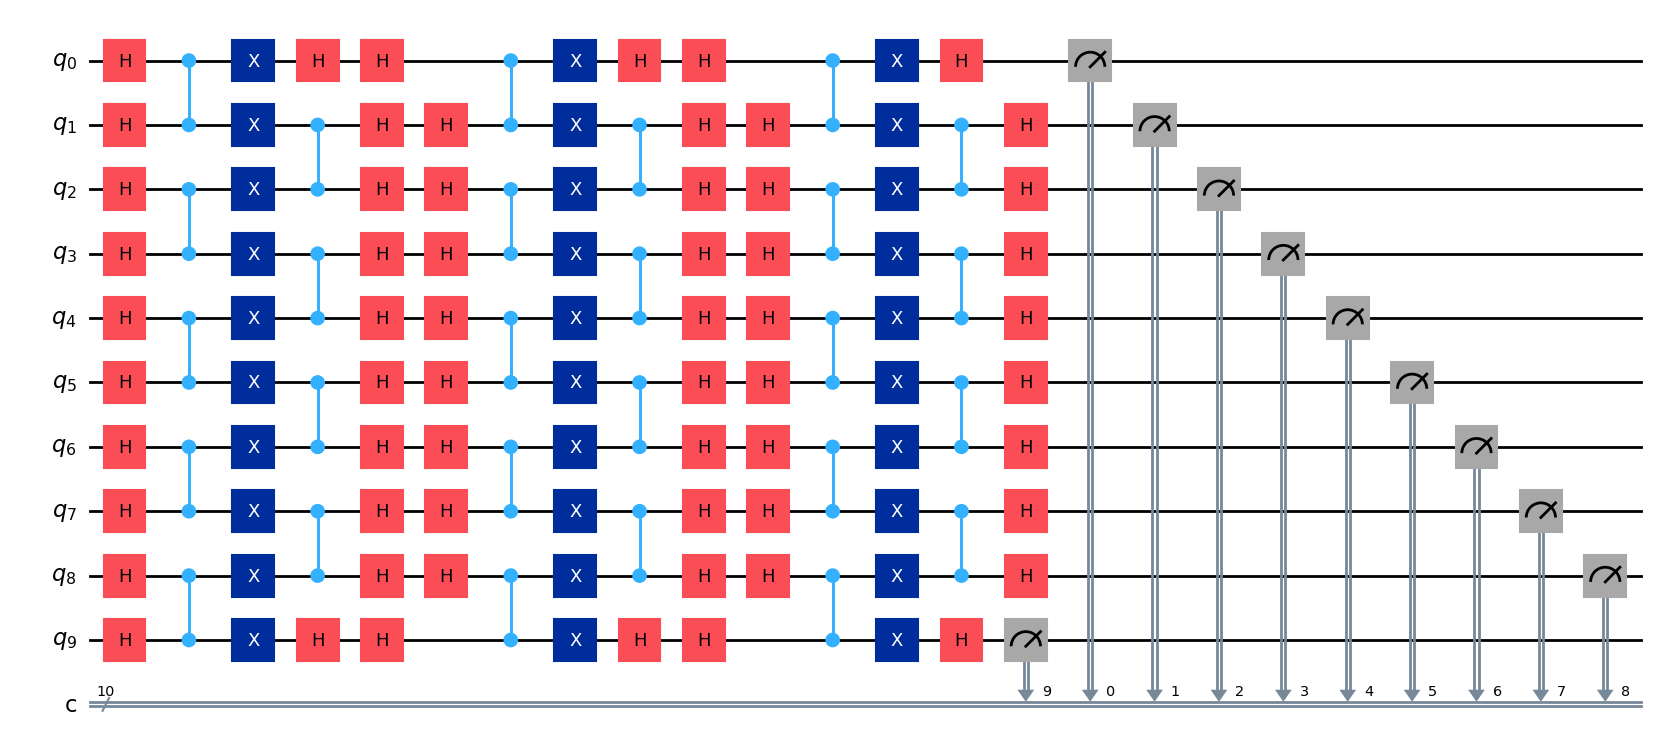
상단에서는 이러한 회로 중 일부가 상당히 깊습니다. 노이즈 모델이 없는 AerSimulator를 사용하여 각 회로의 끝에서 이상적인 상태를 얻어 봅시다. 그런 다음 헬링거 충실도를 사용하여 실제 양자 컴퓨터에서 얻은 결과를 벤치마크할 수 있습니다.
from qiskit_aer import AerSimulator

sim = AerSimulator()
ideal_results = sim.run(circuits, shots=8192).result()
ideal_counts = ideal_results.get_counts()
이제 트월링을 사용하는 SamplerV2와 사용하지 않는 SamplerV2를 정의합니다.
from qiskit_ibm_runtime import SamplerV2 as Sampler

shots = 8192

# --- No Twirling ---
sampler_no = Sampler(mode=backend)
sampler_no.options.twirling.enable_gates = False
sampler_no.options.twirling.enable_measure = False
sampler_no.options.default_shots = shots

# --- With Twirling ---
sampler_tw = Sampler(mode=backend)
sampler_tw.options.twirling.enable_gates = True
sampler_tw.options.twirling.enable_measure = False
# sampler_tw.options.twirling.num_randomizations = "auto"
sampler_tw.options.twirling.num_randomizations = 32
sampler_tw.options.twirling.strategy = "active-circuit"
sampler_tw.options.default_shots = shots
이제 작업을 실행합니다.
# Each job took 17 sec (34 sec total) on ibm_fez. Your times might vary.

job_no = sampler_no.run(circuits)
job_tw = sampler_tw.run(circuits)

res_no = job_no.result()
res_tw = job_tw.result()
실제 양자 컴퓨터에서 실행한 각 결과의 카운트를 가져옵니다.
counts_no = [r.data.c.get_counts() for r in res_no]
counts_tw = [r.data.c.get_counts() for r in res_tw]
이제 이러한 각 실행 결과를 노이즈 없는 AerSimulator 결과와 비교하여 헬링거 충실도를 구합니다.
from qiskit.quantum_info import hellinger_fidelity

f_no = [hellinger_fidelity(counts_no[i], ideal_counts[i]) for i in range(len(circuits))]

f_tw = [hellinger_fidelity(counts_tw[i], ideal_counts[i]) for i in range(len(circuits))]
이제 결과를 시각화합니다.
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 5))
plt.plot(two_qubit_depths, f_no, "o-", label="No Twirling")
plt.plot(two_qubit_depths, f_tw, "o-", label="With Twirling")
plt.xlabel("Two-qubit transpiled depth")
plt.ylabel("Hellinger Fidelity")
plt.title("RTZ Echo Circuit: Twirling vs No Twirling")
plt.legend()
plt.grid(True)
plt.show()
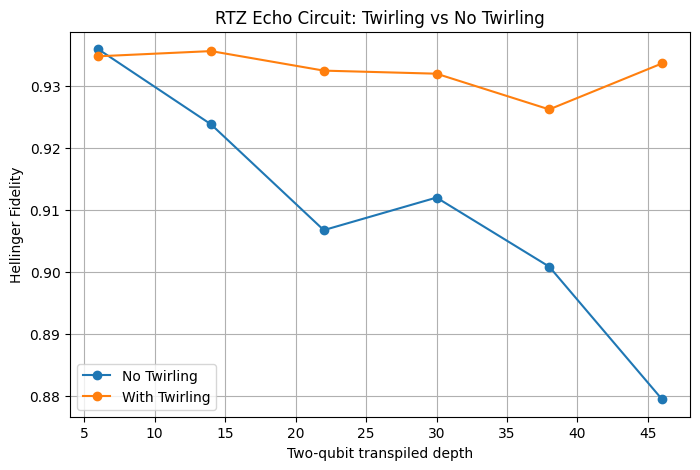
이 레슨 전반에 걸쳐, 결맞는 오류 누적을 제한하기 위해 파울리 트월링이 사용되는 사례들을 살펴보았으며, 이러한 맥락에서는 오류 억제라고 표현할 수 있습니다. 하지만 파울리 트월링은 결맞는 오류를 더 예측 가능하고 모델링하기 쉬운 형태로 변환하는, 오류 동작을 재구성하는 도구로서 더 유용한 경우가 많습니다. 이러한 유용성은 합리적으로 예측 가능한 노이즈 스케일링에 의존하는 제로 노이즈 외삽(ZNE)과 같은 오류 완화 기법의 맥락에서 더욱 분명해질 것입니다. 이는 다음 레슨에서 다룹니다.