플로 집합을 이용한 1D Fermi-Hubbard 동역학 시뮬레이션
이 가이드에서 설명하는 함수는 현재 Python API에서만 사용할 수 있습니다. 동등한 기능은 향후 릴리스에서 C API로도 제공될 예정입니다.
이 가이드는 해밀토니안을 작성하는 것부터 시간 발전한 사이트 밀도를 확인하는 것까지, 1차원 Fermi-Hubbard 모델의 시간 동역학을 위한 회로를 구성합니다. 이 방식을 흥미롭게 만드는 것은 Gandon 등의 플로 집합(flow set) 프레임워크 [1]에서 가져온 하나의 아이디어이며, 이 연구는 이 패키지의 TransferVertexOperator의 동기가 되기도 했습니다.
해밀토니안 항을 페르미온-큐비트 매핑 이후에 묶는 대신, 매핑 이전에 플로 집합으로 묶습니다. 플로 집합은 전달 연산자들이 서로 교환되는, 방향이 있는 페르미온 상호작용 그래프의 1차원 부분 집합입니다.
이 선택이 아래의 모든 것을 이끕니다. 이를 위해 다음이 필요합니다.
-
플로 집합에 맞춘 사용자 지정 페르미온-큐비트 인코딩. 여기서는 보조 큐비트 하나를 사용하므로, 주어진 해밀토니안 항을 구현하는 데 관련된 큐비트 수가 더 이상 페르미온 모드 수에 따라 늘어나지 않습니다(Jordan-Wigner(JW)의 경우와 다릅니다).
-
각 집합 내부의 교환성을 활용하는 사용자 지정 합성. 그 결과 2큐비트 깊이가 시스템 크기에 대해 일정한 회로를 얻으며, 이는 JW 기반의 항별 Trotter 분해에서 깊이가 선형으로 증가하는 것과 대조됩니다.
직접 만든 인코딩을 트랜스파일러에 넣는 장치(CustomF2QLayout와 MapperFnEvolutionSynthesis)는 어떤 모델에도 그대로 적용할 수 있습니다.
전달 연산자와 플로 집합
TransferVertexOperator는 꼭짓점 연산자 와 전달 연산자 로 구성됩니다. 페르미온 생성 및 소멸 연산자로 나타내면,
따라서 는 모드 의 점유를 측정하며(비어 있으면 , 채워져 있으면 ), 는 방향이 있는 간선 를 따라 페르미온을 전달합니다. 의 두 인덱스는 서로 바꿀 수 없다는 점에 유의하세요. 첫 번째 인덱스에는 마이너스 조합이, 두 번째에는 플러스 조합이 붙으며, 이 때문에 는 와 구별되고 간선에 방향이 생깁니다.
이들은 혼합 교환 관계를 만족합니다. 서로소인 사이트에 작용하는 두 전달 연산자는 각각이 페르미온 연산자의 짝수 개 곱이므로 자명하게 교환됩니다. 흥미로운 경우는 사이트를 공유할 때입니다. 이때 화살표가 그 사이트를 통과해 흐르면(하나는 들어오고 하나는 나가면) 두 연산자는 교환하고, 충돌하면(둘 다 들어오거나 둘 다 나가면) 반교환합니다.
이 규칙은 그림으로 보면 가장 이해하기 쉽습니다. 꼭짓점을 노드로, 각 를 에서 로 향하는 화살표로 그리면 방향이 있는 상호작용 그래프가 되며, 아래는 이 가이드 전체에서 사용하는 4-사이트 체인의 경우로, 모든 결합의 두 방향을 모두 담고 있습니다.

그림에서 규칙을 따라가 보세요. 예를 들어 와 을 보면, 한 화살표는 사이트 2에 들어오고 다른 하나는 나가므로 페르미온이 그대로 통과해 흐르며 두 연산자는 교환합니다. 반대로 와 를 보면, 두 화살표 모두 사이트 2를 향합니다. 이들은 충돌하며, 두 연산자는 반교환합니다.
바로 이것이 플로 집합을 가능하게 합니다. 방향 경로를 이루는 화살표 집합을 고르면 모든 쌍이 머리-꼬리로 만나거나 아예 만나지 않으므로, 개별 연산자가 공유 사이트에서 겹치더라도 집합 전체가 교환합니다. 따라서 단일 플로 집합에 대한 발전은 Trotter 오차가 없으며, 7단계에서 보듯이 일정한 회로 깊이로도 구현할 수 있습니다.
1. Fermi-Hubbard 해밀토니안
개 사이트(스핀 없음, 열린 경계)의 1D Fermi-Hubbard 모델은 다음과 같습니다.
문헌 [1]의 식 (9)에 따르면 호핑 항은 입니다. 상호작용은 대각이므로 를 이용해 꼭짓점 연산자로 표현됩니다.
두 부분 모두 TransferVertexOperator로 직접 구성합니다. 는 대각 항목 (j, j)로 저장된다는 점에 유의하세요.
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_1d(num_sites, tunneling, interaction):
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j in range(num_sites - 1):
...         k = j + 1
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> num_sites = 4
>>> hamiltonian = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
>>> print(format(hamiltonian))
  1.500000e0 +0.000000e0j * ()
-5.000000e-1 +0.000000e0j * (V(0))
 5.000000e-1 +0.000000e0j * (V(0) V(1))
  1.000000e0 +0.000000e0j * (T(0,1))
  1.000000e0 +0.000000e0j * (T(1,0))
 -1.000000e0 +0.000000e0j * (V(1))
 5.000000e-1 +0.000000e0j * (V(1) V(2))
  1.000000e0 +0.000000e0j * (T(1,2))
  1.000000e0 +0.000000e0j * (T(2,1))
 -1.000000e0 +0.000000e0j * (V(2))
 5.000000e-1 +0.000000e0j * (V(2) V(3))
  1.000000e0 +0.000000e0j * (T(2,3))
  1.000000e0 +0.000000e0j * (T(3,2))
-5.000000e-1 +0.000000e0j * (V(3))
내부 사이트는 두 결합에 나타나는 반면 경계 사이트는 하나에만 나타나기 때문에, 내부 사이트의 에는 계수 이 더해집니다. 여기에 나열된 모든 항은 위에 그린 그래프에 나타납니다. T(j,k) 항은 화살표이고 V(j) 항은 노드입니다.
2. 플로 집합으로 분할
다음으로 각 항에 그것이 속한 플로 집합을 레이블로 붙입니다. groups 속성이 이를 위해 존재합니다. 그룹이 지정된 연산자에 대한 Evolution 게이트는 그룹마다 하나의 Evolution으로 분해되므로(6단계에서 활용합니다), 페르미온 수준에서 여기서 정한 그룹화가 회로에까지 유지됩니다.
1D 체인에서 두 호핑 플로 집합은 동쪽 방향 화살표()와 서쪽 방향 화살표()입니다. 대각 상호작용 항은 모든 대각 항과 교환하며 세 번째 그룹을 이룹니다.
>>> def flow_set_groups(operator):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         match terms:
...             case [(left, right)] if right == left + 1:
...                 groups.append(0)  # east-oriented: T_{j,j+1}
...             case [(left, right)] if right == left - 1:
...                 groups.append(1)  # west-oriented: T_{j+1,j}
...             case _:
...                 groups.append(2)  # diagonal interaction terms
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian)
>>> hamiltonian.num_groups()
3
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(index, sorted(terms for terms, _ in group.iter_terms()))
0 [[(0, 1)], [(1, 2)], [(2, 3)]]
1 [[(1, 0)], [(2, 1)], [(3, 2)]]
2 [[], [(0, 0)], [(0, 0), (1, 1)], [(1, 1)], [(1, 1), (2, 2)], [(2, 2)], [(2, 2), (3, 3)], [(3, 3)]]
그룹 0과 1이 두 플로 집합입니다. 각 집합은 체인을 따르는 방향 경로이므로, 플로 성질에 의해 한 그룹 안의 모든 항은 교환합니다.
곱 공식은 그룹을 따로 지수화하고 에르미트 인자만이 유니터리 발전을 가지므로, 각 그룹은 그 자체로도 에르미트여야 합니다. groups_are_hermitian()이 이를 확인해 줍니다.
>>> from qiskit_fermions.operators.terms.grouping import groups_are_hermitian
>>>
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
두 호핑 그룹이 단방향이라는 점에서 잠시 짚고 넘어갈 만합니다. 그룹 0에는 동쪽 방향 항만, 그룹 1에는 서쪽 방향 항만 있습니다. 해밀토니안을 이렇게 나누면 보통 에르미트성이 깨지는데, 에는 그 켤레 짝인 가 함께 있어야 하기 때문입니다. TransferVertexOperator는 가 이미 그 자체로 에르미트이기 때문에 이 문제를 피합니다. 이는 단순한 가 아니라 두 Majorana 연산자의 곱이므로(1단계의 정의 참조), 그 Jordan-Wigner 상은 허수가 아닌 실수 계수를 가집니다. 따라서 이 연산자 표현을 선택하는 것이 단방향 플로 집합을 적법한 Trotter 인자로 만들어 주는 바로 그 요소입니다.
이 가이드 전반에서 사용하는 동/서 표기는 기하학적인 것으로, 체인을 왼쪽에서 오른쪽으로 그리고 모드 인덱스가 그 방향으로 증가한다고 가정합니다. 은 동쪽을, 는 서쪽을 가리킵니다. 문헌 [1]은 이 명명에서 내부적으로 일관되지 않으므로(본문과 그림이 서로 다릅니다) 이 가이드는 의도적으로 본문을 따르지 않고 그림의 표기를 유지합니다. 논문과 대조해 읽을 때는 방위 용어가 아니라 Pauli 가중치(아래의 1과 3)로 플로 집합을 맞춰 보세요.
3. 사용자 지정 인코딩 작성
문헌 [1]의 IV B절은 국소 페르미온-큐비트 인코딩을 플로 집합으로 제한했을 때 가질 수 있는 형태를 분류합니다. 일반 Jordan-Wigner는 개의 큐비트를 사용하며 모든 호핑 항을 가중치 2의 Pauli로 매핑합니다. 이 분류는 추가 큐비트를 사용하면 인코딩된 연산자에 구조를 얻을 수 있음을 보여 줍니다.
여기서 구현하는 인코딩은 부록 B 2(식 B4와 B5)의 패리티 비국소화 구성으로, 보조 큐비트 하나를 사용하므로 입니다. 페르미온 패리티는 큐비트 쌍에 걸쳐 비국소화됩니다.
마지막 식의 인덱스 때문에 추가 큐비트가 필요합니다. 체인의 마지막 결합은 이므로 그 는 큐비트 에 놓이는데, 이는 마지막 페르미온 모드 바로 다음입니다. 이 끝의 큐비트가 보조 큐비트이며, 가 가 아니라 인 이유입니다. 같은 범위가 에도 나타나며, 일 때 그 은 보조 큐비트에 있습니다.
이점은 곧바로 드러납니다. 플로 집합 하나 전체가 가중치 1인 Pauli의 합으로 매핑됩니다.
계수는 정규화 로 정해지고, 두 방향 사이의 상대적인 마이너스 부호는 위의 Pauli가 만족하는 곱 항등식 로 정해집니다. 둘 중 어느 하나라도 틀리면 교환 관계는 따르지만 더 이상 같은 해밀토니안을 나타내지 않는 연산자가 되므로, 4단계에서 보듯이 인코딩을 수치적으로 검증해야 합니다.
인코딩을 작성한다는 것은 하나의 일반화된 전달 연산자를 Pauli 문자열로 매핑하는 함수를 작성하는 것입니다. 항에 대한 반복과 그 합성은 map_transfer_vertex_generators()가 처리합니다.
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def flow_set_action(action, num_qubits):
...     match action:
...         case (j, k) if j == k:
...             # vertex operator: V_j = Z_j Z_{j+1}
...             return SparseObservable.from_sparse_list(
...                 [("ZZ", [j, j + 1], 1.0)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j + 1:
...             # east-oriented transfer operator: weight 1
...             return SparseObservable.from_sparse_list(
...                 [("X", [k], -0.5)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j - 1:
...             # west-oriented transfer operator: weight 3
...             return SparseObservable.from_sparse_list(
...                 [("ZXZ", [k, k + 1, k + 2], 0.5)], num_qubits=num_qubits
...             )
...         case _:
...             raise ValueError(f"not a nearest-neighbor transfer operator: {action}")
>>>
>>> def flow_set_encoding(operator, num_qubits):
...     return map_transfer_vertex_generators(
...         operator,
...         lambda action: flow_set_action(action, num_qubits),
...         identity=lambda: SparseObservable.identity(num_qubits),
...         compose=SparseObservable.compose,
...     ).simplify()
MapperFnEvolutionSynthesis.mapper_fn은 (operator, num_qubits) 시그니처를 기대하며 반환 타입은 SparseObservable이어야 하고, 이로써 이 함수를 트랜스파일러 플러그인으로 바로 사용할 수 있습니다. 6단계를 참조하세요.
이를 1단계의 해밀토니안에 적용하면 개 큐비트에서의 인코딩된 연산자를 얻습니다.
>>> num_qubits = num_sites + 1
>>> encoded = flow_set_encoding(hamiltonian, num_qubits)
>>> for label, indices, coeff in sorted(encoded.to_sparse_list()):
...     print(f"{label:3s} {str(indices):12s} {coeff.real:+.2f}")
    []           +1.50
X   [1]          -0.50
X   [2]          -0.50
X   [3]          -0.50
ZXZ [0, 1, 2]    +0.50
ZXZ [1, 2, 3]    +0.50
ZXZ [2, 3, 4]    +0.50
ZZ  [0, 1]       -0.50
ZZ  [0, 2]       +0.50
ZZ  [1, 2]       -1.00
ZZ  [1, 3]       +0.50
ZZ  [2, 3]       -1.00
ZZ  [2, 4]       +0.50
ZZ  [3, 4]       -0.50
항은 14개이며 세 가지 모양입니다. 호핑은 X와 ZXZ가 되었고, 상호작용은 ZZ이며, 맨 앞의 []는 항등원으로 전역 위상에만 기여합니다. ZZ 항은 최근접 이웃 및 차근접 이웃에 걸쳐 있다는 점에 유의하세요. 은 큐비트 부터 까지에 걸치며, 이것이 패리티를 비국소화하는 비용입니다.
플로 집합별로 묶으면 이 구성이 가져다주는 비대칭이 드러납니다. 각 그룹에 있는 Pauli 가중치를 나열해 보겠습니다.
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     weights = {len(indices) for _, indices, _ in flow_set_encoding(group, num_qubits).to_sparse_list()}
...     print(index, sorted(weights))
0 [1]
1 [3]
2 [0, 2]
동쪽 방향 플로 집합(그룹 0)은 전부 가중치 1인 Pauli로 이루어져 있습니다. 따라서 그 시간 발전은 단일 큐비트 회전의 한 층이며 얽힘 게이트가 필요 없지만, Jordan-Wigner에서는 모든 호핑 항이 가중치 2여서 얽힘 게이트가 필요합니다. 이것이 문헌 [1]의 시공간 절충을 가장 단순하게 보여 줍니다. 큐비트 하나를 더 쓰면 호핑 해밀토니안의 절반이 단일 큐비트 회전으로 바뀝니다.
서쪽 방향 플로 집합(그룹 1)은 그 대가로 가중치 3을 치르고, 상호작용(그룹 2)은 가중치 2에 있으며, 가중치 0 항목은 항등원입니다. 이 중 어느 것도 아직 회로에 대한 주장은 아니며, 합성이 이 가중치로 무엇을 만드는지는 6단계와 7단계의 주제입니다.
4. 인코딩 검증
사용자 지정 인코딩은 충실할 때에만 유용하며, 손으로 작성한 인코딩은 검증해야 합니다. 이 인코딩은 개 큐비트를 사용하므로 큐비트 힐베르트 공간이 페르미온 공간의 두 배 크기여서, 인코딩된 해밀토니안은 항 단위로 Jordan-Wigner 해밀토니안과 같을 수 없습니다. 대신 둘은 등長사상(isometry)으로 연결됩니다.
등長사상이 나오는 곳: Jordan-Wigner에서 기저 상태는 점유 문자열이며, 큐비트 가 를 담습니다. 반면 이 인코딩은 누적 패리티를 저장합니다. 다음과 같이 정의합니다.
따라서 비트 은 사이트 까지(사이트 포함) 모든 점유의 패리티를 기록합니다. 점유 개에 대해 이런 비트가 개 있으며, 이것이 보조 큐비트가 생기는 이유입니다. 점유는 이웃한 비트 사이의 차이로 복원되며, 입니다. 따라서 점유된 사이트는 인접한 두 비트 사이의 도메인 월로 나타나며, 그래서 이를 도메인 월(또는 Kramers-Wannier) 인코딩이라고 부릅니다. 인 이유도 이것입니다. 이웃한 두 의 곱이 그 차이를 읽어 냅니다.
이 맵을 몇 가지 상태에 대해 적어 보면 구조가 구체적으로 드러납니다. 이 고정되어 있으므로 개의 큐비트 상태 중 절반만 상(image)에 포함되며, 따라서 유니터리가 아니라 아이소메트리입니다.
>>> def domain_wall_bits(occupations):
...     parity = 0
...     bits = [0]
...     for occupation in occupations:
...         parity ^= occupation
...         bits.append(parity)
...     return bits
>>>
>>> for occupations in ([0, 0, 0, 0], [1, 0, 0, 0], [1, 1, 0, 0], [1, 0, 1, 0]):
...     bits = domain_wall_bits(occupations)
...     # little-endian: reversed() prints qubit 0 on the right, as Qiskit labels do
...     print("".join(map(str, occupations)), "->", "".join(str(b) for b in reversed(bits)))
0000 -> 00000
1000 -> 11110
1100 -> 00010
1010 -> 00110
사이트 0의 페르미온 하나가 그 위의 모든 누적 패리티를 뒤집는데, 이것이 바로 비국소화가 작동하는 방식입니다. 이 열들을 모아 행렬로 만들면 아이소메트리 가 되며, 두 해밀토니안을 서로 얽히게(intertwine) 할 때 인코딩이 충실하다고 말할 수 있습니다.
즉, 페르미온 상태를 큐비트 공간으로 매핑한 다음 그곳에서 시간 발전시킨 결과는, 먼저 페르미온 공간에서 시간 발전시킨 다음 매핑한 결과와 같아야 합니다.
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> def to_matrix(observable):
...     # SparseObservable carries no dense-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix()
>>>
>>> def domain_wall_isometry(num_sites):
...     isometry = np.zeros((2 ** (num_sites + 1), 2**num_sites), dtype=complex)
...     for index in range(2**num_sites):
...         occupations = [(index >> j) & 1 for j in range(num_sites)]
...         bits = domain_wall_bits(occupations)
...         isometry[sum(b << j for j, b in enumerate(bits)), index] = 1.0
...     return isometry
>>>
>>> isometry = domain_wall_isometry(num_sites)
>>> np.allclose(isometry.conj().T @ isometry, np.eye(2**num_sites))
True
>>>
>>> def intertwines(operator):
...     """Whether both mappings of `operator` agree through the isometry."""
...     flow = to_matrix(flow_set_encoding(operator, num_qubits))
...     reference = to_matrix(transfer_vertex_jordan_wigner(operator, num_sites).simplify())
...     return np.allclose(flow @ isometry, isometry @ reference)
>>>
>>> intertwines(hamiltonian)
True
>>> # and, more strongly, once per flow set: a product formula evolves the groups
>>> # separately, so each one has to be intertwined on its own
>>> all(intertwines(group) for group in hamiltonian.split_out_groups())
True
얽힘(intertwining) 관계는 각 흐름 집합(flow set)마다 따로, 그리고 정확하게 성립합니다. 이 두 번째의 더 강한 명제가 이후 단계에서 의존하는 부분입니다. 곱 공식(product formula)은 그룹을 한 번에 하나씩 시간 발전시키고, 얽힌 인자들의 곱 또한 얽혀 있으므로, 이 그룹들로 만든 어떤 근사도 두 인코딩이 서로 다르더라도 두 인코딩 사이에서 일치합니다. 그 결과로 스펙트럼도 일치해야 하며, 더 큰 공간에서는 모든 Jordan-Wigner 고유값이 제약 없는 전역 패리티의 각 값마다 한 번씩, 총 두 번 나타납니다.
>>> jw_matrix = to_matrix(transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify())
>>> flow_matrix = to_matrix(flow_set_encoding(hamiltonian, num_qubits))
>>>
>>> jw_spectrum = np.linalg.eigvalsh(jw_matrix)
>>> flow_spectrum = np.linalg.eigvalsh(flow_matrix)
>>> np.allclose(
...     np.sort(flow_spectrum),
...     np.sort(np.concatenate([jw_spectrum, jw_spectrum])),
... )
True
>>> print(f"{jw_spectrum[0]:.10f}  {flow_spectrum[0]:.10f}")
-1.8557725066  -1.8557725066
5. 페르미온 회로 만들기
큐비트를 사용하기 전에, 먼저 페르미온 수준에서 동역학을 표현합니다. FermionicCircuit은 큐비트가 아니라 페르미온 모드에 작용하며, 해밀토니안에 대한 Evolution 게이트 하나가 회로 전체입니다.
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>>
>>> total_time = 1.0
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>> circuit.draw("mpl")
<Figure size ... with 1 Axes>

네 개의 모드 전체에 걸친 불투명한 상자 하나가 있으며, 흥미로운 부분은 이것이 무엇으로 분해되는가입니다. synthesis 인수가 그 방법을 알려 줍니다. FermionicLieTrotter는 1차 곱 공식으로, 연산자를 groups에 따라 나누고 각 그룹을 차례로 시간 발전시킵니다. 따라서 2단계의 흐름 집합 분할이 바로 Trotter화이며, 단 한 번의 decompose()로 이를 수행하여 그룹 순서대로 흐름 집합마다 하나씩의 Evolution을 얻습니다. 순서는 동쪽, 서쪽, 그다음 대각 상호작용이며, 각각 3개, 3개, 8개의 항을 가집니다.
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.draw("mpl")
<Figure size ... with 1 Axes>
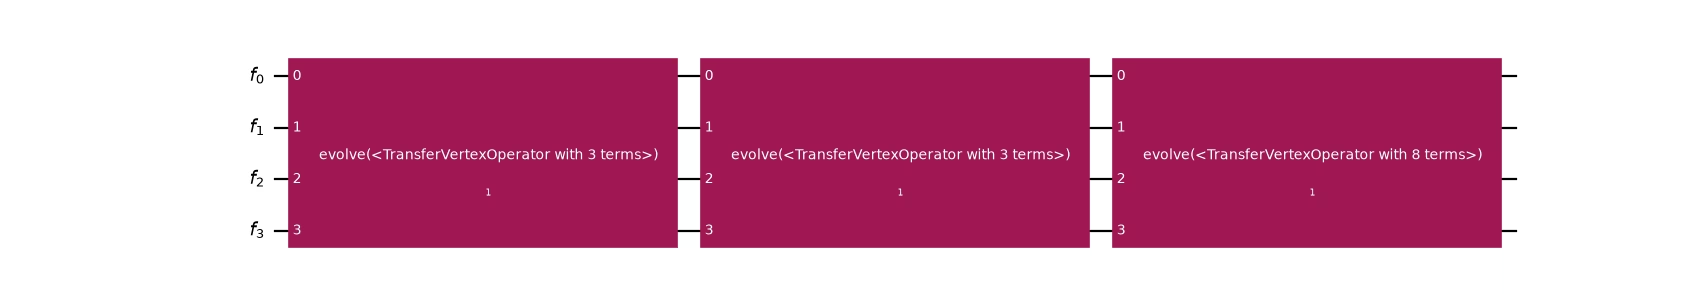
이 과정이 전적으로 페르미온 공간에서 일어난다는 점에 유의하세요. 아직 큐비트는 언급되지 않았지만 근사는 이미 이루어졌습니다. 따라서 Trotter 단계의 수도 여기에 속하며, reps가 시간을 나누고 전체 스윕을 반복합니다.
>>> def trotter_steps(reps):
...     step = FermionicCircuit(num_sites)
...     step.append(
...         Evolution(
...             num_sites,
...             hamiltonian,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=reps),
...         ),
...         step.modes,
...     )
...     return step.decompose()
>>>
>>> trotter_steps(3).count_ops()["Evolution"]
9
게이트는 아홉 개입니다. 세 개의 흐름 집합을 각각 시간의 3분의 1씩으로 세 번 순환한 것입니다. 이 순환이 있기 때문에 하나의 그룹을 다시 쪼갠 것이 아니라 Trotter화가 됩니다. 하나의 그룹만 반복하는 것은 아무 효과가 없는데, 같은 연산자의 연속된 지수 함수는 가환이므로 A(t/3) A(t/3) A(t/3)는 그냥 A(t)이기 때문입니다. 그룹을 읽는 공식은 그룹들을 교차 배치할 수 있지만, 매핑 이후에 적용되는 공식은 그럴 수 없습니다. 그 시점에는 그룹 정보가 이미 사라졌기 때문입니다.
이 단계가 그룹화를 의미 있게 만듭니다. 생성된 각 게이트는 독립적으로 매핑되고 합성되므로, 이후의 모든 과정은 페르미온 수준에서 정해진 분할에 따라 작동합니다. 분해를 건너뛰면 연산자 전체가 다음 단계로 넘어가고 그룹화는 무시됩니다.
6. 사용자 정의 인코딩으로 트랜스파일하기
이제 인코딩을 Transpiler에서 사용할 준비가 되었습니다. 두 가지가 더 필요합니다.
-
레이아웃. 기본값인
TrivialF2QLayout은 모드당 큐비트 하나를 가정하는데, 이 상황에서는 맞지 않습니다.CustomF2QLayout은 페르미온 레지스터를 크기가 다른QuantumRegister와 연결하며, 이를 통해 보조(ancilla) 큐비트가 파이프라인에 들어옵니다. -
합성 플러그인.
MapperFnEvolutionSynthesis는 매퍼 함수를 직접 받아Evolution게이트의 해밀토니안을 그것으로 매핑하고, 규약을 유지하면서PauliEvolutionGate를 생성합니다. 이 클래스의product_formula가 그 게이트를 회전으로 바꾸는 방식을 결정합니다. 이것은 매핑 이후 큐비트에 작용하는 두 번째의 독립적인 곱 공식이라는 점에 유의하세요. 여기에는 Qiskit의LieTrotter를 전달하며, 7단계에서는 이를 흐름 집합을 아는 공식으로 교체합니다.
아래의 모든 비교에서 이 파이프라인을 다시 실행하므로, 한 번 함수로 감싸 두는 것이 좋습니다.
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> def flow_set_pass_manager(mode_register, product_formula=None):
...     '''Build the pipeline mapping `mode_register` with the flow-set encoding.'''
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         flow_set_encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla on top of the fermionic modes
...     qubit_register = QuantumRegister(mode_register.size + 1, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from qiskit.synthesis import LieTrotter
>>>
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
5
네 개의 페르미온 모드가 다섯 큐비트 회로가 되었으며, 보조 큐비트는 사용자 정의 레이아웃이 제공했습니다.
이제 결과 회로가 실제로 무엇을 담고 있는지 살펴봅시다. 반복해서 분해하면 시간 발전 게이트가 U와 CX까지 내려가므로, 아래에서 비교하는 두 합성 전략의 2큐비트 비용을 같은 기준으로 측정할 수 있습니다. count_ops()는 CX 개수를 알려 주고, depth()는 필터 함수를 받아 2큐비트 깊이를 측정합니다. 여기서의 reps는 분해 깊이이며, 이 가이드 뒤에서 reps라는 이름으로 나오는 곱 공식의 Trotter 단계 수와는 무관합니다.
>>> decomposed = qubit_circuit.decompose(reps=6)
>>> decomposed.count_ops()["cx"]
26
>>> decomposed.depth(lambda instruction: len(instruction.qubits) == 2)
23
CX 게이트 26개가 23개의 층에 놓여 있어 거의 아무것도 병렬로 실행되지 않습니다. 회로를 그려 보면 그 이유를 알 수 있습니다.
>>> decomposed.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
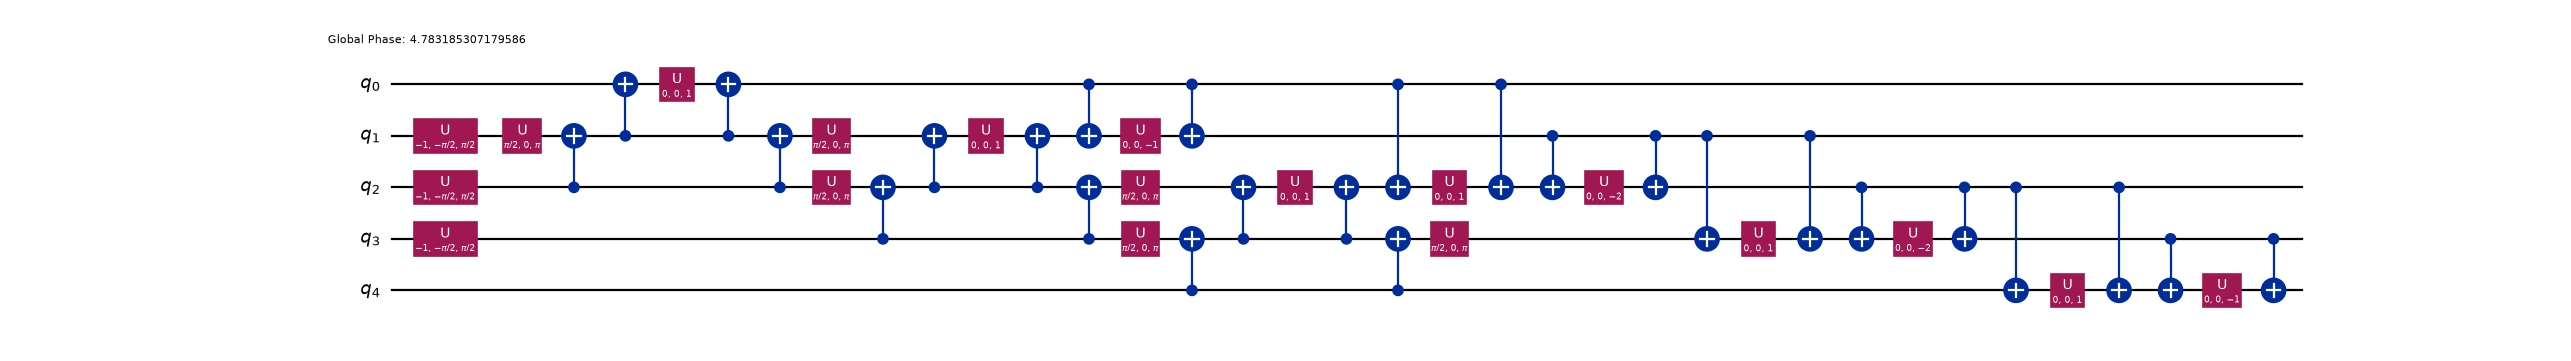
모든 항이 독립적으로 컴파일되었습니다. 기저 변환, 단일 회전까지 내려가는 CX 사다리, 그리고 사다리를 되돌리는 순서입니다. 가중치 1 흐름 집합은 비용이 들지 않습니다. 그 항들은 주위에 사다리가 없는 단독 회전이기 때문입니다. 하지만 가중치 3 항은 각각 CX 게이트 네 개를 소모하고, 사다리가 순차적으로 생성되므로 서로 겹치는 부분이 없습니다.
따라서 그룹화는 파이프라인 전체에서 유지되지만(세 개의 흐름 집합, 세 개의 매핑된 PauliEvolutionGate) 얻는 이득은 거의 없습니다. 5단계의 페르미온 Trotter화는 제 역할을 했으며, 이를 낭비하는 것은 큐비트 쪽 공식입니다. LieTrotter는 자신에 대해 아무 정보도 받지 못한 항들의 집합을 받아 각 항을 독립적으로 컴파일합니다. 항들이 서로 가환이라는 사실을 알 수 없으므로, 하나의 기저 변환을 공유할 수 있는 것을 직렬화합니다.
이것이 이 인코딩이 메우려는 간극입니다. 두 개의 곱 공식이 작동하는데, 지금까지는 페르미온 쪽에만 구조가 주어졌습니다. 다음 단계에서는 이를 활용하는 큐비트 쪽 합성을 제공합니다.
7. 흐름 집합을 인식하는 합성
이점을 되찾으려면 큐비트 쪽 합성에 이 구조를 알려 주어야 합니다. 이것은 참고문헌 [1]의 IV C절입니다. 흐름 집합의 모든 항은 서로 가환이므로 하나의 Clifford 회로로 동시에 대각화할 수 있고, 항마다 한 번씩이 아니라 하나의 공유 기저에서 한 번 회전했다가 되돌릴 수 있습니다.
이 인코딩에서 Clifford는 간단합니다. 최근접 이웃에 대한 CZ 게이트 체인으로 켤레 변환하면 다음과 같이 매핑됩니다.
이는 모든 에 대해 동시에 성립합니다. CZ 체인 하나가 가중치 3(서쪽) 흐름 집합 전체를 서로 독립적인 단일 큐비트 회전의 층으로 바꿉니다. EvolutionSynthesis 인터페이스는 synthesize() 메서드만 요구하며, 이 클래스가 구현하는 것도 그것뿐입니다. 이 클래스는 한 번에 하나의 흐름 집합만 받으므로 집합들에 걸쳐 시간 발전을 세분할 수 없어 Trotter 단계의 수를 가지지 않습니다. 그 세분화는 한 단계 위의 페르미온 공간에 속하며, 그곳에서는 F2FSynthesisPlugin가 모든 집합을 한꺼번에 봅니다(9단계 참조).
>>> from qiskit.circuit import QuantumCircuit
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> def cz_brickwork(circuit):
...     # emit even and odd bonds as two layers, so the CZs are scheduled in
...     # parallel: a chain of overlapping CZs has depth 2, not num_qubits - 1
...     #
...     # NOTE: CZ gates are diagonal, so they all commute and each is its own inverse.
...     # This whole layer is therefore self-inverse, which is why the conjugation below
...     # calls it twice rather than calling it and then its inverse.
...     for offset in (0, 1):
...         for j in range(offset, circuit.num_qubits - 1, 2):
...             circuit.cz(j, j + 1)
>>>
>>> # The interaction reaches nearest (distance 1) and next-nearest (distance 2)
>>> # neighbors, so every interior qubit carries four Rzz gates and can only do one at
>>> # a time: four layers is the best any schedule can do. These offsets achieve it.
>>> def rzz_layers(circuit, angles):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     near = [(j, k) for j, k in angles if k - j == 1]
...     far = [(j, k) for j, k in angles if k - j == 2]
...     schedule = [
...         [(j, k) for j, k in near if j % 2 == 0],
...         [(j, k) for j, k in far if j % 4 in (0, 1)],
...         [(j, k) for j, k in near if j % 2 == 1],
...         [(j, k) for j, k in far if j % 4 in (2, 3)],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     '''Synthesize one flow set of the encoded Hamiltonian at a time.'''
...
...     preserve_order = True
...
...     def synthesize(self, evolution):
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         east, west, diagonal = [], [], {}
...
...         for label, indices, coeff in evolution.operator.to_sparse_list():
...             angle = 2 * evolution.time * coeff.real
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "X", [qubit]:  # east flow set: already weight-1
...                     east.append((qubit, angle))
...                 case "ZXZ", [j, k, l] if (k, l) == (j + 1, j + 2):
...                     west.append((k, angle))  # needs the CZ conjugation below
...                 case "ZZ", [j, k]:  # interaction: diagonal, see rzz_layers above
...                     diagonal[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...
...         # east flow set: bare rotations, no entangling gates at all
...         for qubit, angle in east:
...             circuit.rx(angle, qubit)
...
...         # west flow set: one CZ chain diagonalizes the WHOLE set at once
...         if west:
...             cz_brickwork(circuit)
...             for qubit, angle in west:
...                 circuit.rx(angle, qubit)
...             cz_brickwork(circuit)
...
...         if diagonal:
...             rzz_layers(circuit, diagonal)
...
...         return circuit
놓치기 쉬운 세부 사항이 두 가지 있습니다. 사용자 정의 EvolutionSynthesis는 고수준 합성(high-level-synthesis) 패스가 읽는 preserve_order 속성을 제공해야 합니다.
두 도우미 모두 게이트를 항 순서가 아니라 명시적인 층으로 생성하는데, depth()가 게이트를 추가된 순서대로 가능한 한 일찍 스케줄링하기 때문입니다. 이 집합들 안의 모든 게이트는 서로 가환이므로 순서는 자유롭게 고를 수 있습니다. 항별 합성은 순서를 나쁘게 고릅니다. 겹치는 CZ 체인을 순차적으로 생성하면, 하드웨어가 달성할 수 있는 상수 2가 아니라 큐비트 수에 따라 커지는 깊이가 보고됩니다.
위의 합성이 Trotter 단계의 수를 가지지 않는 이유가 이것입니다. 게이트마다 하나의 흐름 집합을 받으므로, 그 안에서 반복하면 집합들 사이를 순환하는 것이 아니라 한 집합 내에서 반복하게 됩니다.
repeating within one set:      A(t/2) A(t/2) B(t/2) B(t/2)
what a Trotterization needs:   A(t/2) B(t/2) A(t/2) B(t/2)
첫 번째 형태는 아무 이득이 없습니다. 같은 연산자의 연속된 지수 함수는 가환이므로 A(t/2) A(t/2)는 그냥 A(t)이고, 몇 단계를 요청하든 오차는 한 단계일 때의 값 그대로입니다.
따라서 단계 수는 5단계의 페르미온 FermionicLieTrotter에 속하며, 이것은 groups를 읽고 그룹들을 교차 배치할 수 있습니다. 이러한 역할 분담이 핵심입니다. 페르미온 공식은 몇 단계를 어떤 순서로 할지 결정하고, 이 클래스는 결과로 나온 각 집합을 얼마나 저렴하게 구현할지 결정합니다.
순서를 선택하려면 MapperFnEvolutionSynthesis.product_formula에 전달하면 되며, 이것이 flow_set_pass_manager가 받는 인수입니다. 파이프라인의 나머지(또는 그것이 실행되는 페르미온 회로)는 아무것도 바뀌지 않습니다.
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, FlowSetSynthesis())
>>>
>>> flow_circuit = pass_manager.run(flow_set_circuit).decompose(reps=6)
>>> flow_circuit.count_ops()["cx"]
22
>>> flow_circuit.depth(lambda instruction: len(instruction.qubits) == 2)
12
>>> flow_circuit.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
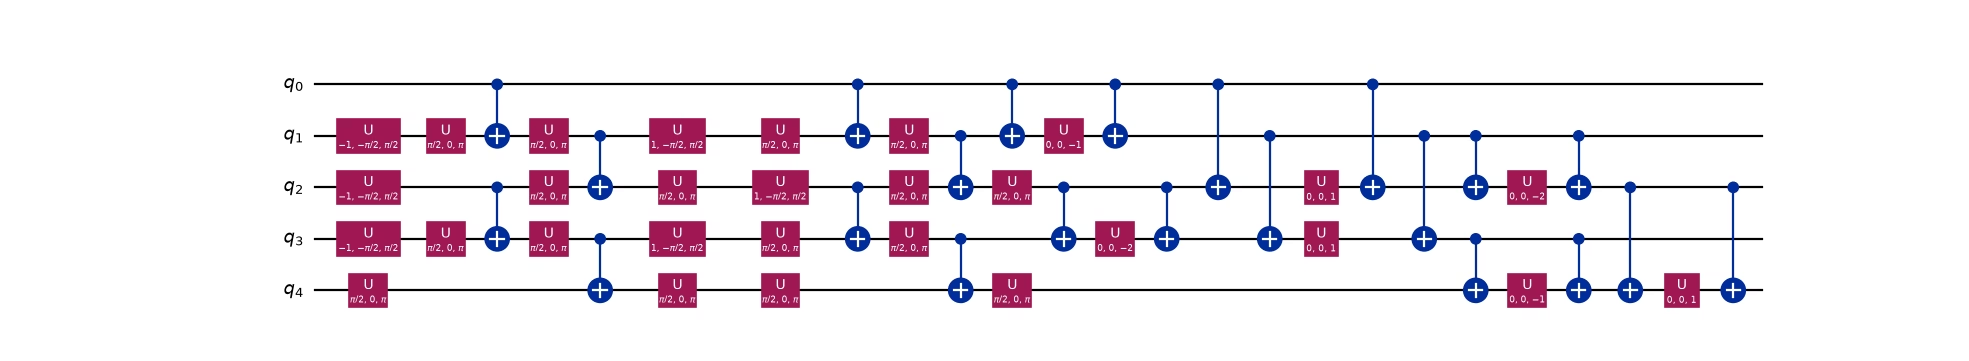
깊이 23, CX 게이트 26개에서 깊이 12, CX 게이트 22개로 줄었습니다. 얽힘 게이트가 더 적고 깊이도 거의 절반이라는 점에 유의하세요. 두 그림을 비교하면, 차이는 게이트가 더 저렴해졌다는 것이 아니라 쌓인다는 것입니다. 직렬 사다리는 사라졌고, 서쪽 흐름 집합 전체가 하나의 공유 기저에서 회전되며 상호작용이 서로소인 쌍의 층으로 생성되기 때문에, 얽힘 게이트가 공유된 층에서 서로 위아래로 놓입니다.
FlowSetSynthesis는 절대 큐비트 인덱스를 패턴 매칭하는데, 이 해밀토니안의 모든 흐름 집합이 레지스터 전체에 걸쳐 있기 때문에 여기서만 안전합니다. 페르미온 곱 공식은 각 인자를 실제로 건드리는 모드로 좁히므로, 집합이 체인의 일부만 덮는 그룹화라면 레이블이 바뀌어 도착하게 되고 위의 패턴은 일치하지 않을 것입니다.
두 그림 모두 decompose(reps=6) 이후의 회로를 보여 주며, 이는 모든 것을 U와 CX 기저로 다시 쓰기 때문에 FlowSetSynthesis가 생성한 CZ, Rx, Rzz 게이트는 그대로 보이지 않습니다. 이는 의도된 것입니다. 두 회로를 같은 기저에 두는 것이 위의 2큐비트 개수와 깊이를 비교할 수 있게 하는 유일한 방법이기 때문입니다. 이 그림에서 눈여겨볼 것은 게이트 레이블이 아니라 층 구조입니다.
8. 규모에 따른 상수 깊이
흥미로운 질문은 모드 네 개에서의 개수가 아니라 그것이 어떻게 확장되는가입니다. 두 개의 CZ 벽돌 배열 층은 체인 길이에 따라 커지지 않으므로, Trotter 한 단계의 2큐비트 깊이는 상수여야 합니다. 완전한 Fermi-Hubbard 해밀토니안에서 직접 측정해 보겠습니다. 이는 무차별 대입으로 시뮬레이션할 수 있는 범위를 훨씬 넘어섭니다.
>>> def evolution_stats(num_sites, product_formula):
...     operator = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
...     operator.groups = flow_set_groups(operator)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, operator, time=total_time, synthesis=FermionicLieTrotter()
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # one Evolution per flow set, as in step 5
...
...     pass_manager = flow_set_pass_manager(circuit.register, product_formula)
...     decomposed = pass_manager.run(circuit).decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops()["cx"], decomposed.depth(two_qubit)
>>>
>>> sites = [4, 10, 20, 50, 100]
>>> flow = [evolution_stats(n, FlowSetSynthesis()) for n in sites]
>>> lie_trotter = [evolution_stats(n, LieTrotter()) for n in sites]
>>>
>>> [depth for _, depth in flow]
[12, 12, 12, 12, 12]
>>> [depth for _, depth in lie_trotter]
[23, 47, 87, 207, 407]
2큐비트 깊이는 12로 유지되어 모드 4개부터 100개까지 변하지 않는 반면, LieTrotter는 선형으로 늘어 407에 이릅니다. 흐름 집합은 파이프라인 내에서 약간의 병렬화를 가능하게 하지만, 각 집합은 여전히 항별로 Trotter화되므로 증가가 제거되는 것이 아니라 완만해질 뿐입니다.
>>> import matplotlib.pyplot as plt
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sites, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sites, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="modes", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

게이트 수는 두 방식 모두에서 선형으로 증가합니다(적용해야 할 항이 개이며 이는 피할 수 없습니다). 하지만 흐름 집합 합성은 이를 일정한 수의 병렬 층에서 적용합니다. 이것이 참고문헌 [1]의 상수 깊이 결과입니다.
깊이 12는 모든 체인 길이에서 세 흐름 집합에 0 + 4 + 8로 나뉩니다. 동쪽 흐름 집합의 기여는 0이며, 순수한 Rx 회전입니다. 서쪽 흐름 집합의 비용은 4로, 들어가는 CZ 벽돌 배열 층 두 개와 나오는 두 개에서 나옵니다. 상호작용을 빼면 어떤 체인 길이에서든 2큐비트 깊이는 4가 됩니다. 나머지 8은 상호작용으로, Rzz 항이 최근접 이웃과 차근접 이웃 모두에 작용하여 서로소인 층 네 개가 필요하고 각 층은 CX 게이트 두 개의 비용이 듭니다. 여기서 4는 최적입니다. 모든 내부 큐비트는 네 개의 Rzz 게이트(각 최근접 이웃에 둘, 각 차근접 이웃에 둘)를 가지며 한 번에 하나에만 참여할 수 있으므로, 어떤 스케줄도 이보다 나을 수 없습니다.
깊이의 3분의 2가 상호작용이라는 것은 이 인코딩이 호핑, 따라서 자유 페르미온 체인의 동역학에서 뛰어나다는 것을 보여 줍니다. 다만 상호작용은 호핑과 가환이 아니라는 점에 유의하세요. 이를 빼는 것은 Fermi-Hubbard의 근사가 아니라 다른 모델입니다. 주어진 문제에서 균형이 어디에 놓이는지는 탐구할 가치가 있습니다.
9. 동역학 확인하기
domain-wall 맵에서는 점유 패턴이 누적 패리티 문자열이 되므로, 초기 상태는 Jordan-Wigner와 다르게 준비됩니다. 이는 패리티를 비국소화한 데서 오는 간과하기 쉬운 실용적 결과입니다. 4단계의 도우미가 올바른 레이블을 줍니다.
>>> occupations = [1, 0, 1, 0]
>>> initial_label = "".join(str(b) for b in reversed(domain_wall_bits(occupations)))
>>> initial_label
'00110'
상태를 준비했으니 두 가지 질문이 남으며, 이를 따로 묻는 것이 가장 좋습니다. 흐름 집합 합성이 올바른 것을 계산하는가, 그리고 그것을 더 저렴하게 계산하는가?
먼저 정확성입니다. FlowSetSynthesis와 Qiskit의 LieTrotter는 같은 페르미온 Trotter화로부터 같은 인코딩된 흐름 집합을 받으므로, 전역 위상을 제외하고 같은 유니터리를 구현해야 합니다. 사용자 정의 Clifford는 작업을 재구성할 뿐 결과를 바꾸지 않습니다. 임의의 상태 벡터는 전체 유니터리를 만드는 것보다 훨씬 저렴하게 어떤 불일치든 찾아냅니다.
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(reps, samples=3):
...     """Compare both qubit-side syntheses of the same fermionic Trotterization."""
...     step = trotter_steps(reps)
...     trotter = flow_set_pass_manager(step.register, LieTrotter()).run(step)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     trotter, flow = trotter.decompose(reps=6), flow.decompose(reps=6)
...     dimension = 2**trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> [agrees_up_to_one_phase(reps) for reps in (1, 3)]
[(True, True), (True, True)]
그 확인의 두 부분 모두 중요합니다. 단일 상태에서 크기가 1인 겹침은 필요조건이지만 충분조건은 아닙니다. 상태에 의존하는 위상을 잘못 얻은 합성이라도 여전히 그렇게 보일 수 있기 때문입니다. 여러 임의 상태에서 같은 위상을 요구하면 이 간극이 메워집니다. 하나보다 많은 reps를 확인하는 것도 중요한데, 일치가 단일 스윕에서만 성립하는 것이 아니라 흐름 집합들의 교차 배치 후에도 유지됨을 확인해 주기 때문입니다.
따라서 큐비트 쪽 합성의 선택은 정확도에 아무 영향이 없으며, 이것이 비용 비교를 의미 있게 만듭니다. 남은 질문은 인코딩 전체가 명백한 대안, 즉 보조 큐비트도 사용자 정의 Clifford도 없이 num_sites개의 큐비트에서 쓰는 단순 Jordan-Wigner 대비 무엇을 얻는가입니다. 두 열은 인코딩과 큐비트 쪽 합성이 모두 다르지만, 위의 확인으로 후자는 결과에 영향을 줄 수 없음이 드러났으므로, 충실도가 검사하는 것은 인코딩입니다. 또한 두 파이프라인은 같은 페르미온 Trotter화에서 시작하므로, 충실도에 차이가 있다면 트레이드오프가 아니라 버그를 나타냅니다. 두 열은 인코딩, 즉 흐름 집합 대 Jordan-Wigner입니다.
>>> def jordan_wigner_pass_manager(mode_register, product_formula):
...     """The same pipeline under plain Jordan-Wigner: one qubit per mode."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         transfer_vertex_jordan_wigner, product_formula=product_formula
...     )
...     qubit_register = QuantumRegister(mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from scipy.linalg import expm
>>>
>>> jw_state = np.zeros(2**num_sites, dtype=complex)
>>> jw_state[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> reference_jw = expm(-1j * total_time * jw_matrix) @ jw_state
>>> reference_flow = expm(-1j * total_time * flow_matrix) @ (isometry @ jw_state)
>>>
>>> def cost_and_fidelity(reps):
...     step = trotter_steps(reps)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     jw = jordan_wigner_pass_manager(step.register, LieTrotter()).run(step)
...     flow, jw = flow.decompose(reps=6), jw.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     evolved_flow = Statevector.from_label(initial_label).evolve(flow).data
...     evolved_jw = Statevector(jw_state).evolve(jw).data
...     return (
...         abs(np.vdot(evolved_flow, reference_flow)) ** 2,
...         flow.count_ops()["cx"],
...         flow.depth(two_qubit),
...         abs(np.vdot(evolved_jw, reference_jw)) ** 2,
...         jw.count_ops()["cx"],
...         jw.depth(two_qubit),
...     )
>>>
>>> for reps in (1, 2, 4, 8):
...     flow_f, flow_cx, flow_d, jw_f, jw_cx, jw_d = cost_and_fidelity(reps)
...     print(
...         f"{reps} step(s):  flow set {flow_f:.6f}"
...         f" ({flow_cx:3d} CX, depth {flow_d:3d})"
...         f"   JW {jw_f:.6f} ({jw_cx:3d} CX, depth {jw_d:3d})"
...     )
1 step(s):  flow set 0.590661 ( 22 CX, depth  12)   JW 0.590661 ( 18 CX, depth  14)
2 step(s):  flow set 0.926656 ( 44 CX, depth  24)   JW 0.926656 ( 36 CX, depth  26)
4 step(s):  flow set 0.982053 ( 88 CX, depth  48)   JW 0.982053 ( 72 CX, depth  50)
8 step(s):  flow set 0.995395 (176 CX, depth  96)   JW 0.995395 (144 CX, depth  98)
먼저 충실도 열을 읽어 보세요. 서로 다른 두 힐베르트 공간에서 서로 다른 두 인코딩인데도 출력된 모든 자릿수까지 동일합니다. 이는 페르미온 Trotter화가 드러나는 것입니다. 근사는 어느 인코딩이 선택되기 전인 5단계에서 고정되었으므로, 두 회로 모두 세 흐름 집합에 대한 1차 공식의 오차를 그대로 가지며, 이 오차는 단계 수가 두 배가 될 때마다 대략 4분의 1로 줄어듭니다.
인코딩이 다른 부분은 비용이며, 이 트레이드오프는 분명하게 말할 가치가 있습니다. 흐름 집합은 더 많은 얽힘 게이트를 사용합니다. 한 단계에서 18개 대신 22개입니다. 보조 큐비트가 이유는 아닌데, 보조 큐비트 자체에는 2큐비트 게이트가 없기 때문입니다. 이유는 3단계에서 경고했듯이 상호작용입니다. 패리티를 비국소화하면 최근접 이웃 ZZ 항 세 개가 최근접 및 차근접 이웃에 걸친 일곱 개가 되고, 각각 CX 게이트 두 개의 비용이 듭니다. 이것이 호핑을 저렴하게 만든 대가입니다.
또한 이 크기에서는 깊이에서 근소하게만 앞서는데(12 대 14), 모드 네 개는 점근적 성질이 드러나기에는 너무 작기 때문입니다. 핵심은 8단계에서 측정한 확장성입니다. 깊이 12는 상수인 반면 Jordan-Wigner 깊이는 체인과 함께 늘어납니다. 모드 14개에서는 이미 12 대 34입니다.
위의 decompose() 호출은 서로 독립적인 두 가지 이유로 필수입니다.
evolve()와 Operator는 PauliEvolutionGate의 정확한 정의를 사용하므로 사용자 정의 큐비트 쪽 합성을 우회합니다. 분해되지 않은 회로로 검증하면 일부러 틀리게 만든 합성에서도 완벽한 충실도가 보고됩니다.
같은 점이 한 단계 위의 페르미온 합성에도 적용됩니다. 분해되지 않은 Evolution 게이트는 통째로 페르미온-큐비트 단계로 넘어가고, 거기서는 Evolution.synthesis를 전혀 참조하지 않고 매핑하므로 reps는 아무 알림 없이 효과가 없게 됩니다. 5단계의 trotter_steps가 그 분해를 수행하며, F2FSynthesis로 방법을 설정하는 파이프라인은 패스에서 같은 전개를 얻습니다.
마지막 교차 확인으로, 인코딩된 공간에서 계산한 사이트 밀도 가 Jordan-Wigner 결과를 재현해야 합니다. 이 확인은 회로가 아니라 인코딩에 관한 것이므로 Trotter 근사가 개입하지 않습니다. 두 시간 발전 모두 각 해밀토니안의 행렬 지수 함수로 정확하게 계산됩니다. 따라서 어떤 불일치든 곱 공식이 아니라 인코딩을 가리킬 것입니다.
>>> time = 0.8
>>> state_jw = np.zeros(2**num_sites, dtype=complex)
>>> state_jw[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> evolved_jw = expm(-1j * time * jw_matrix) @ state_jw
>>> evolved_flow = expm(-1j * time * flow_matrix) @ (isometry @ state_jw)
>>>
>>> for j in range(num_sites):
...     v_flow = to_matrix(
...         SparseObservable.from_sparse_list([("ZZ", [j, j + 1], 1.0)], num_qubits)
...     )
...     v_jw = to_matrix(SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_sites))
...     density_flow = (1 - np.vdot(evolved_flow, v_flow @ evolved_flow).real) / 2
...     density_jw = (1 - np.vdot(evolved_jw, v_jw @ evolved_jw).real) / 2
...     print(f"site {j}:  {density_flow:.10f}  {density_jw:.10f}")
site 0:  0.6507935456  0.6507935456
site 1:  0.5963201678  0.5963201678
site 2:  0.3365016619  0.3365016619
site 3:  0.4163846247  0.4163846247
밀도는 소수점 10자리까지 일치합니다.
핵심 정리
-
매핑 전에 그룹화하세요. 흐름 집합은 방향이 있는 페르미온 상호작용 그래프에서 정의되므로, 문제 구조를 아직 쓸 수 있는 시점에 그룹화가 선택됩니다.
groups속성이 이를 회로로 전달하고, 단 한 번의decompose()로 흐름 집합마다Evolution게이트 하나가 됩니다. -
보조 큐비트는 구조를 얻는 대가입니다. 큐비트 하나를 더 쓰면 흐름 집합 전체가 가중치 1 Pauli가 되어 그 시간 발전에 얽힘 게이트가 필요 없습니다. 참고문헌 [1]은 이 트레이드오프를 일반적으로 관찰합니다. 큐비트 대 페르미온 비율이 클수록 더 얕은 시간 발전 회로가 가능합니다.
-
사용자 정의 인코딩은 함수 하나입니다. 일반화된 전달 연산자 하나를 Pauli 문자열로 매핑하면,
map_transfer_vertex_generators()와MapperFnEvolutionSynthesis가 나머지를 처리합니다. -
매핑과 그룹화만으로는 충분하지 않습니다. 흐름 집합별로 시간 발전을 나누는 것은 깊이의 선형 증가를 늦출 뿐이었고, 각 집합을 항별로 합성하면 그 항들이 가환이라는 사실이 여전히 버려졌습니다. 흐름 집합을 인식하는
EvolutionSynthesis를 제공해야만 깊이가 상수가 되었습니다. 사용자 정의 인코딩, 그룹화, 사용자 정의 합성은 서로 보완적이며, 세 가지 모두 필요합니다. -
두 개의 곱 공식, 두 가지 역할.
FermionicLieTrotter는 그룹화가 아직 보이는 페르미온 공간에서 근사를 고정하므로, Trotter 오차와 단계 수를 혼자 결정합니다. 그러면 큐비트 쪽EvolutionSynthesis는 각 집합을 얼마나 저렴하게 구현할지만 결정합니다. 9단계에서 두 선택이 같은 유니터리를 준다는 것을 확인했습니다. 이 둘을 분리하면 정확도와 비용을 독립적으로 조정할 수 있습니다. 페르미온 공간에서 Evolution 게이트 합성하기를 참조하세요. -
검증하세요. 교환 관계를 만족하는 인코딩이라도 접두 계수나 부호가 잘못되면 다른 해밀토니안을 나타낼 수 있습니다. 얽힘 관계(또는 더 저렴하게는 스펙트럼)를 확인하면 이를 잡아낼 수 있습니다.
위의 FlowSetSynthesis는 1차원 체인의 이 인코딩을 위해 의도적으로 작성되었습니다. 인코딩이 만들어 내는 특정 Pauli 레이블을 패턴 매칭하고, 그 외의 것에는 일반적인 곱 공식으로 조용히 되돌아가는 대신 오류를 발생시킵니다. 일반적인 구현은 두 부분으로 이루어집니다. 연산자의 groups에서 흐름 집합 구조를 읽는 것은 시간 발전을 위한 F2FSynthesisPlugin이 이미 하는 일입니다. 참고문헌 [1]의 IV C절에 설명된 대로 안정자 군에서 대각화 Clifford를 유도하는 것이 인코딩에 고유하게 남는 부분입니다.
또한 패리티를 비국소화하면 상호작용 항 이 단일 큐비트에서 대각이 아니라 가중치 2가 되며, 이는 더 저렴해진 호핑 항에 대응하는 비용입니다.
다음: 2차원
위의 모든 내용은 1차원이며, 의도적으로 그렇게 했습니다. 체인에서 흐름 집합은 두 화살표 방향일 뿐이고 인코딩에는 보조 큐비트 하나면 충분합니다. 2차원에서는 이 두 단순화가 모두 성립하지 않으며, 바로 여기서 국소 인코딩이 필요해집니다.
평면 격자에서 흐름 집합은 상호작용 그래프를 지나는 방향 경로(또는 꼭짓점이 서로소인 방향 경로들의 합집합)이며, 모든 간선을 덮는 이런 경로의 작은 집합을 찾는 것은 두 줄짜리 분류가 아니라 그 자체로 하나의 조합 최적화 문제가 됩니다. 인코딩의 성격도 바뀝니다. 체인 전체에 보조 큐비트 하나를 두는 대신 격자 사이트마다 또는 셀마다 하나씩 추가합니다. Verstraete-Cirac는 모든 페르미온 사이트를 각자의 보조 큐비트와 짝지어 큐비트 대 모드 비율이 이고, Derby-Klassen은 홀수 plaquette 각각의 중심에 하나씩 두어 비율이 입니다. 그러면 레지스터 배치는 진정한 2차원 구조를 가지며, 사영해야 하는 안정자 군은 더 이상 자명하지 않습니다. 인코딩된 해밀토니안은 부분 공간에서만 충실하며, 이는 상태 준비와 4단계의 검증 절차를 모두 바꿉니다.
이 가이드에서 만든 요소 중 그대로 이어지는 것은 다음과 같습니다. 모드 수와 크기가 다른 레지스터를 위한 CustomF2QLayout, 인코딩 자체를 위한 map_transfer_vertex_generators(), 이를 Transpiler에 연결하기 위한 MapperFnEvolutionSynthesis, 그리고 흐름 집합 구조가 효과를 내도록 하는 사용자 정의 EvolutionSynthesis입니다. 인코딩과 흐름 집합 분해만 달라집니다.
2D 흐름 집합 가이드는 여기서 이어지며, 정사각 격자에서의 Verstraete-Cirac 인코딩을 다룹니다. 네 개의 흐름 집합, 각각에 대한 깊이 2 Clifford, 그리고 검증에 필요한 안정자 사영을 다룹니다.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.