흐름 집합으로 2D Fermi-Hubbard 동역학 시뮬레이션하기
이 가이드의 개념은 현재 Python API에서만 사용할 수 있습니다. 동등한 기능은 향후 릴리스에서 C API로 제공될 예정입니다.
먼저 1D 흐름 집합 가이드를 읽으세요. 이 가이드는 그 2차원 후속편이며, 거기서 다룬 내용을 반복하지 않습니다. 전달 연산자와 꼭짓점 연산자, 흐름 집합이란 무엇인지, groups가 회로까지 어떻게 유지되는지, 그리고 사용자 정의 인코딩이 MapperFnEvolutionSynthesis를 통해 Transpiler에 어떻게 연결되는지입니다.
전반에 걸쳐 언급되는 Transpiler 단계는 트랜스파일 가이드를, 사용자 정의 매퍼를 작성하는 일반적인 방법은 매퍼 가이드를 참조하세요.
1D 가이드는 2차원을 다룰 때 국소 인코딩이 필요하다는 언급으로 끝났습니다. 이 가이드는 그 단계를 이어서, 정사각 격자 위의 2차원 Fermi-Hubbard 모델을 Verstraete-Cirac(VC) 인코딩 [2]으로 다룹니다.
1D 문제와는 이 작업의 토대를 이루는 세 가지 차이가 있습니다.
-
흐름 집합이 늘어납니다. 체인에는 화살표 방향이 둘이지만 정사각 격자에는 넷(동, 서, 북, 남)이 있으며, 각각은 단일 경로가 아니라 꼭짓점이 서로소인 방향 경로들(격자의 행 또는 열마다 하나)의 합집합입니다.
-
인코딩이 사이트마다 보조 큐비트를 얻습니다. 전체 시스템에 하나가 아니라 사이트마다 하나씩이며, 그 결과
큐비트 대 모드 비율은 입니다. 전달 연산자는 가중치 3(수평) 및 가중치 4(수직) Pauli가 되고, 네 흐름 집합 각각이 고유한 Pauli 모양으로 매핑되므로 각각 자신만의 대각화 Clifford가 필요합니다.
-
인코딩된 해밀토니안은 부분 공간에서만 충실합니다. 모든 2D 국소 인코딩이 가지는 plaquette 제약의 결합
고유 공간 [2] [3]입니다. 1D에서는 인코딩이 단순한 아이소메트리였고 검증은 스펙트럼 확인이었습니다. 여기서는 9단계에서 보여 주듯이 비교를 사영해야 합니다.
이점의 형태는 1D와 같습니다. Trotter 한 단계의 2큐비트 깊이가 격자 크기와 무관하게 상수가 되어 (참고문헌 [1]과 일치하는 호핑 에 상호작용 을 더한 값)인 반면, 같은 인코딩된 해밀토니안에 대한 항별 Trotter화는 선형으로 증가합니다. 물론 게이트 수는 여전히 결합(bond) 수에 따라 증가합니다. 크기와 무관해지는 것은 그 게이트들이 차지하는 층의 수입니다. 깊이는 전반적으로 추상적이고 완전 연결된 레지스터에서 계산했으며, 인코딩을 장치의 제한된 커플링 맵에 매핑하는 것은 그 자체로 별도의 문제로 마지막에 다룹니다.
격자와 네 가지 방향
첫 번째 변화는 방향 상호작용 그래프에서 보입니다. 사이트는 행 우선 순서로 번호가 매겨지며 site(r, c) = r * cols + c이고, 1D의 체인처럼 모든 결합이 두 방향을 모두 가지지만 이제 결합은 두 축을 따라 놓입니다.
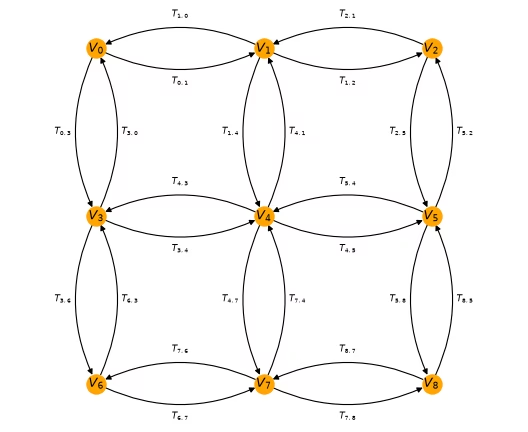
교환 규칙은 1D와 같으며 변하지 않습니다. 한 사이트를 공유하는 두 전달 연산자는 화살표가 그 사이트를 통과해 흐를 때 가환이고 충돌할 때 반가환입니다. 그러나 사이트에는 이제 결합이 둘이 아니라 최대 넷까지 붙으므로 화살표가 충돌하는 방식이 더 다양하고, 충돌하지 않는 화살표 집합은 더 이상 단일 경로가 아닙니다. 수평 화살표를 왼쪽에서 오른쪽으로 읽으면 이런 집합 하나가 되고, 수직 화살표를 위에서 아래로 읽으면 또 하나가 되며, 각각을 뒤집으면 두 개가 더 생깁니다. 이것이 이후 모든 것을 조직하는 동, 서, 북, 남 흐름 집합입니다.
Verstraete-Cirac 인코딩
Verstraete-Cirac(VC)는 모든 페르미온 모드 를 자신의 보조 큐비트와 짝짓습니다. 격자 사이트가 개일 때 모드 는 큐비트 에 있고 그 보조 큐비트는 큐비트 에 있으므로, 레지스터는 개의 큐비트를 가집니다. 꼭짓점 연산자는 가능한 한 단순하게 유지됩니다.
이 덕분에 나중에 점유를 직접 읽을 수 있습니다. 전달 연산자는 간선 방향에 따라 달라집니다. 가 서쪽 사이트인 수평 간선 와, 가 북쪽 사이트인 수직 간선에 대해 다음과 같습니다.
가중치 3의 “삼각형”과 가중치 4의 “사각형”입니다. 각 화살표를 구분하는 것이 중요합니다. 가 서쪽 사이트이면 는 동쪽을 가리키지만, 가 북쪽 사이트이면 남쪽을 가리킵니다. 반대 방향은 항등식 에서 나오며, 이는 XXZ 삼각형을 YYZ로, XYXY 사각형을 YXXY로 바꿉니다. 이 네 개의 서로 다른 레이블이 네 흐름 집합이며, 이 가이드의 나머지는 이를 추적합니다.
이 식들은 참고문헌의 식 (A1)과 정확히 같지는 않습니다. [1]은 "단일 Qubit 회전을 제외하고"라고 명시하며, 논문을 확인하는 독자가 알아차릴 만한 세 가지 차이가 있어 짚어 둡니다.
-
전위 계수: 식 (A1)에는 없습니다. 여기의 덕분에 이 성립하며, 이는
TransferVertexOperator가 사용하는 정규화 와 일치합니다. 논문은 전이 연산자를 안에서만 사용하므로 배율 인자가 회전 각도에 흡수되지만, 여기서는 항등식을 만족하는 연산자여야 합니다. -
방향: 식 (A1)은 의 행 홀짝에 따라 문자를 선택하는데, 수평 간선에서는 두 끝점이 같은 값을 가지므로 와 를 구별하지 못합니다. 논문은 층으로 켤레 변환하여 방향을 따로 복원합니다. 이 가이드는 대신 방향을 인코딩에 포함시키고, 로부터 역방향을 유도합니다. 이 덕분에 3단계에서 두 방향이 서로 다른 Pauli에 대응됩니다.
-
수직 형태: 식 (A1)은 행의 홀짝에 따라
XXXX와YYYY를 번갈아 쓰지만, 이 가이드는 단일XYXY를 사용합니다. 두 방식은 같은 것을 얻는 서로 다른 방법입니다. 즉, 수직 간선이 그와 만나는 수평 간선과 올바르게 충돌하도록 하는 문자의 비대칭성입니다. 이 차이를 자유로운 기저 선택으로 읽어서는 안 됩니다. 홀짝 교대를 없애고 단일XXXX를 쓰면 대수가 완전히 깨지며, 그래서 서로 다른 문자를 가정하지 않고 확인합니다.
보조 Qubit은 사이트마다 붙으므로 비율은 입니다. (홀수) 플라켓마다 보조 Qubit 하나를 두어 더 작은 비율 를 얻는 것은 Derby-Klassen 인코딩입니다. 여기서 VC를 사용하는 이유는, 대각화하는 Clifford를 참고문헌 [1]이 닫힌 형태로 제시하는 전이 연산자가 VC의 것이기 때문입니다.
1. 정사각 격자 위의 해밀토니안
구성은 1D와 같지만 간선 목록이 2차원입니다. 사이트는 위 그림에 쓰인 행 우선 번호 매기기 site(r, c) = r * cols + c를 유지하므로, 수평 결합은 연속된 인덱스를 잇고 수직 결합은 cols만큼 차이 나는 인덱스를 잇습니다.
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_2d(rows, cols, tunneling, interaction):
...     site = lambda r, c: r * cols + c
...     edges = [(site(r, c), site(r, c + 1)) for r in range(rows) for c in range(cols - 1)]
...     edges += [(site(r, c), site(r + 1, c)) for r in range(rows - 1) for c in range(cols)]
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j, k in edges:
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> rows, cols = 3, 3
>>> num_sites = rows * cols
>>> hamiltonian = fermi_hubbard_2d(rows, cols, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 46
2. 두 개가 아닌 네 개의 흐름 집합
각 호핑 항은 격자 위에서 화살표가 가리키는 방향으로 분류됩니다. 두 끝점의 divmod 행/열 좌표를 비교하면 수평 간선과 수직 간선이 구분되고, 차이의 부호로 방향이 정해집니다. 대각 성분(항등원, , 항)은 모두 다섯 번째 그룹에 들어갑니다.
방향 규칙. 이름은 위 그림에서 그대로 읽은 것입니다. 화살표가 행을 따라 오른쪽 또는 왼쪽을 향하면 east 또는 west, 열을 따라 위 또는 아래를 향하면 north 또는 south입니다. 번호가 행 우선이므로 east와 south가 인덱스가 증가하는 방향입니다. 이후 과정은 이름에 의존하지 않으며(그룹의 레이블일 뿐입니다) 혼동하기 쉬우니 그림과 대조하여 정해 두는 것이 좋습니다. 참고문헌 [1]도 정사각 격자의 흐름 집합을 같은 방식으로 명명합니다.
>>> EAST, WEST, NORTH, SOUTH, DIAGONAL = range(5)
>>>
>>> def flow_set_groups(operator, cols):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         if len(terms) == 1 and terms[0][0] != terms[0][1]:
...             j, k = terms[0]
...             row_j, col_j = divmod(j, cols)
...             row_k, col_k = divmod(k, cols)
...             if row_j == row_k:
...                 groups.append(EAST if col_k > col_j else WEST)
...             else:
...                 groups.append(SOUTH if row_k > row_j else NORTH)
...         else:
...             groups.append(DIAGONAL)
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian, cols)
>>>
>>> names = ["east", "west", "north", "south", "diagonal"]
>>> for index, name in enumerate(names):
...     count = sum(1 for group in hamiltonian.groups if group == index)
...     print(f"{name:9s} {count:2d}")
east       6
west       6
north      6
south      6
diagonal  22
하나의 흐름 집합 안에서는 1D에서처럼 모든 화살표가 다른 화살표와 머리-꼬리로 만나거나 아예 만나지 않으므로, 흐름 집합은 여전히 항별로 교환하며 그 시간 발전에는 Trotter 오차가 없습니다. 새로운 점은 흐름 집합이 이제 연결되어 있지 않다는 것입니다. rows x cols 격자의 east 집합은 rows개의 독립적인 좌-우 경로로 이루어집니다. 6단계에서 보듯이 이 분리는 복잡한 문제가 아니라 오히려 이점입니다.
3. 연산자 인코딩
인코딩은 일반화된 전이 연산자 하나를 Pauli 문자열로 매핑하는 함수 하나이며, 이 함수가 map_transfer_vertex_generators()에 전달됩니다. 1D 버전에 비해 본문에 경우가 더 많습니다. 대각, 수평, 수직, 그리고 를 통한 역방향입니다.
문제가 하나 있습니다. map_transfer_vertex_generators()는 생성자 하나만 넘겨 콜백을 호출하는데, 결합의 Pauli 문자열을 정하려면 모드 인덱스에서 행과 열 좌표를 복원하기 위한 cols도 필요합니다. 함수를 중첩하여 클로저로 감싸는 대신 functools.partial()로 바인딩하면 두 함수를 모두 최상위에 두고 독립적으로 호출할 수 있습니다.
>>> from functools import partial
>>>
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def ancilla_qubit(mode, num_sites):
...     """The auxiliary qubit paired with fermionic mode `mode`."""
...     return num_sites + mode
>>>
>>> def vc_action(generator, width, cols):
...     """Map one generalized transfer operator to its Verstraete-Cirac Pauli."""
...     num_sites = width // 2
...     ancilla = partial(ancilla_qubit, num_sites=num_sites)
...     j, k = generator
...     if j == k:  # vertex operator V_j = Z_j
...         return SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     row_j, col_j = divmod(j, cols)
...     row_k, col_k = divmod(k, cols)
...     if row_j == row_k:  # horizontal: weight-3 triangle
...         left, right = (j, k) if col_j < col_k else (k, j)
...         operator = SparseObservable.from_sparse_list(
...             [("XXZ", [left, right, ancilla(left)], 0.5)], num_qubits=width
...         )
...         forward = (j, k) == (left, right)
...     else:  # vertical: weight-4 square
...         up, down = (j, k) if row_j < row_k else (k, j)
...         operator = SparseObservable.from_sparse_list(
...             [("XYXY", [up, down, ancilla(up), ancilla(down)], 0.5)], num_qubits=width
...         )
...         forward = (j, k) == (up, down)
...     if forward:
...         return operator
...     # reverse orientation: T_kj = -V_j V_k T_jk
...     v_j = SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     v_k = SparseObservable.from_sparse_list([("Z", [k], 1.0)], num_qubits=width)
...     return (-1.0 * v_j.compose(v_k).compose(operator)).simplify()
>>>
>>> def vc_encoding(operator, width, cols):
...     """Map a TransferVertexOperator to a qubit observable, Verstraete-Cirac style."""
...     return map_transfer_vertex_generators(
...         operator,
...         partial(vc_action, width=width, cols=cols),
...         identity=lambda: SparseObservable.identity(width),
...         compose=SparseObservable.compose,
...     ).simplify()
>>>
>>> # bind the lattice width once; the transpiler only ever passes (operator, width)
>>> encoding = partial(vc_encoding, cols=cols)
>>> num_qubits = 2 * num_sites
>>> num_qubits
18
매핑 전에 그룹화하는 이유는 바로 알 수 있습니다. 각 흐름 집합이 집합 전체에 걸쳐 균일한 단일 Pauli 형태로 인코딩됩니다.
>>> for index, name in enumerate(names):
...     observable = encoding(hamiltonian.split_out_groups()[index], num_qubits)
...     shapes = sorted({label for label, _, _ in observable.to_sparse_list()})
...     print(f"{name:9s} {shapes}")
east      ['XXZ']
west      ['YYZ']
north     ['YXXY']
south     ['XYXY']
diagonal  ['', 'Z', 'ZZ']
네 가지 호핑 형태는 서로 다르므로, 각 흐름 집합은 5단계에서 자기만의 Clifford를 갖습니다. 역방향은 같은 Pauli의 이름만 바꾼 것이 아니라 서로 다른 Pauli입니다. 그래서 1D 합성은 회로가 하나면 되지만 2D 흐름 집합 합성에는 회로가 네 개 필요합니다.
4. 사용자 정의 인코딩으로 트랜스파일
이 단계는 Qubit 레지스터가 더 넓어진 1D 단계와 같습니다. CustomF2QLayout은 개 모드 레지스터를 개 Qubit에 매핑하고, MapperFnEvolutionSynthesis는 인코딩을 담당하며, product_formula 인수는 결과로 나온 PauliEvolutionGate를 어떻게 분해할지 선택합니다. 보조 Qubit 하나로 같은 파이프라인을 구성하는 1D 가이드의 6단계와 비교해 보세요.
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit.synthesis import LieTrotter
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> total_time = 1.0
>>>
>>> def flow_set_pass_manager(mode_register, encoding, product_formula=None):
...     """Build the pipeline mapping `mode_register` with the VC `encoding`."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla per fermionic mode
...     qubit_register = QuantumRegister(2 * mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>>
>>> # as in 1D, one decompose() splits the Evolution group by group (five gates here,
>>> # the four hopping flow sets in group order, then the diagonal interaction)
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.count_ops()["Evolution"]
5
2단계에서 센 6, 6, 6, 6, 22개 항을 담은 Gate 다섯 개입니다. 각각 독립적으로 매핑·합성되므로, 페르미온 수준에서 정한 분할이 회로까지 그대로 유지됩니다.
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, encoding, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
18
>>>
>>> def two_qubit_stats(circuit):
...     decomposed = circuit.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops().get("cx", 0), decomposed.depth(two_qubit)
>>>
>>> two_qubit_stats(qubit_circuit)
(144, 47)
이것이 기준선입니다. 인코딩과 그룹화는 모두 갖춰져 있지만 LieTrotter는 각 흐름 집합을 항별로 합성하므로 깊이가 격자 크기에 따라 증가합니다.
5. 흐름 집합별 깊이 2 Clifford
메커니즘은 1D와 같습니다. 교환하는 흐름 집합 전체를, 각 항을 서로 다른 무게 1 Pauli로 보내는 Clifford로 켤레 변환하면 집합 전체의 시간 발전이 단일 Qubit 회전만으로 이루어집니다. 1D에서는 CZ Gate 한 겹의 브릭워크가 이 역할을 했습니다.
2D에서는 각 흐름 집합에 자체 회로가 필요하며, 참고문헌 [1]의 IV C절과 그림 7을 따릅니다. 네 회로 모두 한 번에 격자의 한 줄(east/west는 행, north/south는 열)과 그 줄의 보조 Qubit에 작용하며, 모두 같은 세 부분 구조를 갖습니다.
-
각 Qubit을 흐름 집합이 필요로 하는 기저에 놓는 단일 Qubit 회전 층.
-
첫 번째
CX층. 항상 같은 사이트의 사이트-보조 Qubit 사이에 걸립니다. -
두 번째
CX층. 줄을 따라 이웃을 연결합니다.
2단계와 3단계만이 2-Qubit 층이므로, 줄의 길이와 관계없이 2-Qubit 깊이는 입니다. 아래에 흐름 집합별로 함수 하나씩 작성했습니다. 회전은 각 흐름 집합의 항을 켤레 변환하고 서로 다른 무게 1 이미지를 요구하여 찾아낸 것이므로, 주어진 것으로 받아들이고 이어지는 검사를 신뢰하세요.
두 수평 집합이 가장 단순합니다. 이들의 항은 무게 3인 XXZ와 YYZ이며, 사이트에서 를 로 바꾸는 추가 만 다릅니다.
>>> from qiskit.circuit import QuantumCircuit
>>>
>>> def east_clifford(circuit, line, ancilla):
...     """Diagonalize the east flow set (XXZ) on one lattice row."""
...     for j in line:
...         circuit.h(ancilla(j))
...     for j in line[:-1]:  # layer 1: each site with its own ancilla
...         circuit.cx(ancilla(j), j)
...     for j, k in zip(line, line[1:]):  # layer 2: ancilla with the next site along
...         circuit.cx(k, ancilla(j))
>>>
>>> def west_clifford(circuit, line, ancilla):
...     """Diagonalize the west flow set (YYZ) on one lattice row."""
...     for j in line:
...         circuit.s(j)  # the only difference from east: X -> Y on the sites
...         circuit.h(ancilla(j))
...     for j in line[:-1]:
...         circuit.cx(ancilla(j), j)
...     for j, k in zip(line, line[1:]):
...         circuit.cx(k, ancilla(j))
두 수직 집합은 무게 4인 XYXY와 YXXY이며 그만큼 더 복잡합니다. 회전이 줄을 따른 위치에 따라 번갈아 나타나고, 두 번째 CX 층도 번갈아 가며 짝수 위치의 사이트와 홀수 위치의 보조 Qubit을 (또는 그 반대로) 연결합니다.
>>> def south_clifford(circuit, line, ancilla):
...     """Diagonalize the south flow set (XYXY) on one lattice column."""
...     for position, j in enumerate(line):
...         if position % 2 == 0:
...             circuit.sdg(ancilla(j))
...             circuit.h(ancilla(j))
...         else:
...             circuit.h(j)
...             circuit.s(j)
...             circuit.h(ancilla(j))
...             circuit.s(ancilla(j))
...     for j in line:  # layer 1
...         circuit.cx(ancilla(j), j)
...     for position, (j, k) in enumerate(zip(line, line[1:])):  # layer 2
...         if position % 2 == 0:
...             circuit.cx(ancilla(j), ancilla(k))  # ancilla to ancilla
...         else:
...             circuit.cx(j, k)  # site to site
>>>
>>> def north_clifford(circuit, line, ancilla):
...     """Diagonalize the north flow set (YXXY) on one lattice column."""
...     for position, j in enumerate(line):
...         if position % 2 == 0:
...             circuit.h(ancilla(j))
...             circuit.s(ancilla(j))
...         else:
...             circuit.h(j)
...             circuit.s(j)
...             circuit.sdg(ancilla(j))
...             circuit.h(ancilla(j))
...     for j in line:  # layer 1
...         circuit.cx(ancilla(j), j)
...     for position, (j, k) in enumerate(zip(line, line[1:])):  # layer 2
...         if position % 2 == 0:
...             circuit.cx(k, j)  # site to site, and the other way round from south
...         else:
...             circuit.cx(ancilla(j), ancilla(k))
세 사이트로 된 한 줄(사이트 먼저, 그다음 보조 Qubit)에 그려 보면 전체 메커니즘이 한 그림에 들어옵니다. 두 형태 중 삼각형이 더 알기 쉽습니다. 보조 Qubit의 기저 변환 후 CX 층이 둘 있으며, 첫 번째는 각 사이트를 자기 보조 Qubit과 짝짓고 두 번째는 줄을 따라 다음 사이트로 뻗습니다.
>>> line = [0, 1, 2]  # three sites, with ancillas on qubits 3, 4, 5
>>> triangle = QuantumCircuit(6)
>>> east_clifford(triangle, line, lambda mode: 3 + mode)
>>> triangle.draw("mpl")
<Figure size ... with 1 Axes>

사각형 형태는 단일 Qubit 작업이 더 필요하며(회전이 줄을 따라 번갈아 나타남), 두 번째 CX 층이 사이트 연결과 보조 Qubit 연결을 번갈아 합니다.
>>> square = QuantumCircuit(6)
>>> south_clifford(square, line, lambda mode: 3 + mode)
>>> square.draw("mpl")
<Figure size ... with 1 Axes>

둘 다 CX 층 두 개 깊이이며, 줄에 사이트를 추가하면 깊이는 그대로 폭만 넓어집니다. 이것이 상수 깊이 주장의 전부이며 눈으로 확인할 수 있습니다. west와 north Clifford는 단일 Qubit 층만 다르므로 따로 그리지 않았습니다.
합성에 여전히 필요한 것은 각 항이 어디에 도달하는지 정하는 일입니다. 개 사이트의 한 줄에는 개의 결합이 있고 각각 하나의 항을 만들므로, 아래 도우미는 결합마다 항목 하나를 반환합니다. 항이 도달한 Qubit과 그것이 된 단일 Qubit Pauli입니다. 중요한 점은 이것들이 예측이 아니라 켤레 변환에서 읽어낸 값이라는 것입니다. CZ 브릭워크 하나가 를 닫힌 형태로 매핑하는 1D와 달리 여기에는 그런 공식이 없고, 열 줄의 보조 Qubit은 연속적이지 않습니다. 흐름 집합 사이에서 다른 것은 입력으로 들어가는 Pauli 문자열뿐이며, 이는 3단계에서 이미 출력했습니다.
>>> from qiskit.quantum_info import Clifford, SparsePauliOp
>>>
>>> def clifford_supports(clifford, pauli, line, ancilla, num_qubits):
...     """Conjugate a flow set's terms to find which qubit each one lands on.
...
...     `pauli` is the flow set's Pauli string, as printed in step 3. Its letters apply
...     to the i-th term's qubits in the order below: the two sites of the bond, then
...     their ancillas.
...
...     This is the one check that needs SparsePauliOp: Clifford conjugation wants a
...     `Pauli` and its symplectic bits, and SparseObservable exposes neither -- its own
...     `evolve` conjugates by a Pauli, not by a Clifford.
...     """
...     supports = []
...     for i in range(len(line) - 1):
...         qubits = [line[i], line[i + 1], ancilla(line[i]), ancilla(line[i + 1])]
...         term = SparsePauliOp.from_sparse_list(
...             [(pauli, qubits[: len(pauli)], 1.0)], num_qubits=num_qubits
...         )
...         image = term.paulis[0].evolve(clifford, frame="s")
...         # a weight-1 image has exactly one qubit with an X and/or Z bit set
...         (support,) = np.nonzero(image.x | image.z)
...         assert len(support) == 1, f"term {i} is not weight-1"
...         supports.append((int(support[0]), image[support].to_label()))
...     return supports
이미지는 서로 다르고 무게 1이어야 각 항을 자기 Qubit에서 독립적으로 회전할 수 있습니다. 2-Qubit 깊이 는 위의 네 구성에서 이미 보이며, 각각 줄 길이와 무관하게 CX 층 두 개를 냅니다. 아래에서는 두 성질을 모든 흐름 집합, 모든 줄, 여러 격자 크기에 걸쳐 검사합니다. 이어서 6단계가 clifford_supports를 호출하므로, 이는 단순한 시연이 아니라 합성의 실제 구성 요소입니다.
6. 흐름 집합을 인식하는 합성
합성은 유리한 출발점을 얻습니다. Evolution이 그룹별로 스스로 분할하므로 synthesize는 흐름 집합마다 한 번씩(여기서는 네 호핑 집합과 대각 그룹, 총 다섯 번) 호출되고, 따라서 보이는 모든 호핑 항이 하나의 Pauli 형태를 공유하며 하나의 Clifford가 모두를 대각화합니다. 첫 번째 항에서 그 형태를 읽고 나머지를 어느 줄에 있는지에 따라 분류하기만 하면 됩니다. 그러면 2차원이 생각보다 저렴한 이유가 되는 관찰이 나옵니다.
하나의 흐름 집합의 성분들은 꼭짓점이 서로소입니다. west 집합의 행들은 Qubit을 공유하지 않습니다. 따라서 한 흐름 집합의 모든 Clifford를 함께 내보낼 수 있고, 행을 하나씩 차례로 쌓는 대신 같은 두 개의 2-Qubit 층을 공유합니다. 그러므로 흐름 집합 하나는 격자의 행이나 열 수와 관계없이 고정된 수의 층(Clifford에 둘, 그 역에 둘)이 들며, 이 때문에 전체 깊이가 상수가 됩니다.
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> # The interaction couples nearest neighbors only, so every interior site carries four
>>> # Rzz gates -- one per bond -- and can only do one at a time: four layers is the best
>>> # any schedule can achieve. Horizontal bonds split by column parity, vertical ones by
>>> # row parity, which achieves it.
>>> def rzz_layers(circuit, angles, cols):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     horizontal = [(j, k) for j, k in angles if k - j == 1]
...     vertical = [(j, k) for j, k in angles if k - j == cols]
...     schedule = [
...         [(j, k) for j, k in horizontal if (j % cols) % 2 == 0],
...         [(j, k) for j, k in horizontal if (j % cols) % 2 == 1],
...         [(j, k) for j, k in vertical if (j // cols) % 2 == 0],
...         [(j, k) for j, k in vertical if (j // cols) % 2 == 1],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     """Synthesize one 2D line flow set at a time, via its depth-2 Clifford."""
...
...     preserve_order = True
...
...     def __init__(self, rows, cols):
...         self.rows, self.cols = rows, cols
...
...     def rows_of_lattice(self):
...         return [[r * self.cols + c for c in range(self.cols)] for r in range(self.rows)]
...
...     def columns_of_lattice(self):
...         return [[r * self.cols + c for r in range(self.rows)] for c in range(self.cols)]
...
...     def synthesize(self, evolution):
...         num_qubits = 2 * self.rows * self.cols
...         ancilla = partial(ancilla_qubit, num_sites=self.rows * self.cols)
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         terms = [
...             (label, indices, 2 * evolution.time * coeff.real)
...             for label, indices, coeff in evolution.operator.to_sparse_list()
...         ]
...
...         # `Evolution.decompose()` hands us one gate per flow set, so every hopping term
...         # here shares a single Pauli shape and one Clifford diagonalizes all of them
...         shapes = tuple({label for label, _, _ in terms} - {"", "Z", "ZZ"})
...         match shapes:
...             case ("XXZ",):
...                 clifford_function, lines = east_clifford, self.rows_of_lattice()
...                 along_rows = True
...             case ("YYZ",):
...                 clifford_function, lines = west_clifford, self.rows_of_lattice()
...                 along_rows = True
...             case ("XYXY",):
...                 clifford_function, lines = south_clifford, self.columns_of_lattice()
...                 along_rows = False
...             case ("YXXY",):
...                 clifford_function, lines = north_clifford, self.columns_of_lattice()
...                 along_rows = False
...             case ():  # the diagonal group: no conjugation needed
...                 self.diagonal(circuit, terms)
...                 return circuit
...             case _:
...                 raise ValueError(f"expected one known flow set per gate, got {shapes}")
...
...         # a term's line is the row it sits in and its slot the column, or vice versa
...         rotations: dict[int, list] = defaultdict(list)
...         for _, indices, angle in terms:
...             row, col = divmod(indices[0], self.cols)
...             line, slot = (row, col) if along_rows else (col, row)
...             rotations[line].append((slot, angle))
...
...         active = sorted(rotations)
...         # the lines of one flow set are vertex-disjoint, so all of their Cliffords
...         # are emitted together and share the same two two-qubit layers
...         conjugation = QuantumCircuit(num_qubits)
...         for line in active:
...             clifford_function(conjugation, lines[line], ancilla)
...         circuit.compose(conjugation, inplace=True)
...         for line in active:
...             supports = clifford_supports(
...                 Clifford(conjugation), shapes[0], lines[line], ancilla, num_qubits
...             )
...             for slot, angle in rotations[line]:
...                 match supports[slot]:
...                     case qubit, "X":
...                         circuit.rx(angle, qubit)
...                     case qubit, "Y":
...                         circuit.ry(angle, qubit)
...                     case qubit, "Z":
...                         circuit.rz(angle, qubit)
...         circuit.compose(conjugation.inverse(), inplace=True)
...         return circuit
...
...     def diagonal(self, circuit, terms):
...         """Synthesize the diagonal group: a phase, single-qubit Z and paired Rzz."""
...         rzz = {}
...         for label, indices, angle in terms:
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "Z", [qubit]:  # a lone vertex operator
...                     circuit.rz(angle, qubit)
...                 case "ZZ", [j, k]:  # interaction, see rzz_layers above
...                     rzz[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...         rzz_layers(circuit, rzz, self.cols)
1D와 마찬가지로 이는 이 인코딩을 위해 의도적으로 작성되었습니다. 네 가지 Pauli 형태를 인식하고 그 외에는 조용히 대체하지 않고 예외를 발생시킵니다. 또한 위의 게이트당 흐름 집합 하나라는 분할을 전제하며 이를 명시합니다. 하나의 Gate에 호핑 형태가 둘 이상 있다면 그룹화가 적용되지 않았다는 뜻이며, 이는 우회할 일이 아니라 오류입니다.
1D의 대응물처럼 이 합성도 Trotter 단계 수를 받지 않습니다. Trotter 단계는 흐름 집합들 사이를 순환해야 하지만, 아래의 transpile_trotter_step은 페르미온 회로를 집합당 하나의 Evolution Gate로 분해합니다. 따라서 이 메서드는 한 번에 한 집합만 보며 그 안에서만 반복할 수 있는데, 이는 아무것도 바꾸지 않습니다. 하나의 연산자를 반복하는 것은 그 시간 발전을 같은 크기의 조각으로 나눌 뿐이기 때문입니다.
따라서 다단계 Trotter화에는 분해 이전에 단일 Gate 안에서 연산자의 groups를 존중하는 곱 공식이 필요합니다. FermionicLieTrotter가 이를 수행하며, 10단계에서 수렴을 측정하는 데 사용합니다.
이름이 비슷한 두 클래스에 유의하세요. 위에서 기준선으로 사용한 Qiskit의 LieTrotter는 이미 그룹화가 사라진 매핑된 해밀토니안에 작용합니다. FermionicLieTrotter는 그 페르미온 대응물이며, 흐름 집합을 여전히 볼 수 있는 것은 이쪽입니다.
7. 결과: 상수 깊이
지금까지는 1단계에서 만든 단일 격자에서 실행했습니다. 커지는 격자들에 걸쳐 두 합성 경로를 비교하려면 이 전체 순서(연산자, 그룹화, 인코딩, 회로, 패스 매니저)를 크기마다 반복해야 하므로, 한 번 감싸 두는 것이 좋습니다.
>>> def transpile_trotter_step(rows, cols, product_formula, steps=1):
...     """Transpile `steps` Trotter steps on a `rows` x `cols` lattice."""
...     num_sites = rows * cols
...     operator = fermi_hubbard_2d(rows, cols, 1.0, 2.0)
...     operator.groups = flow_set_groups(operator, cols)
...     encoding = partial(vc_encoding, cols=cols)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites,
...             operator,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=steps),
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # split into one Evolution per flow set
...
...     pass_manager = flow_set_pass_manager(circuit.register, encoding, product_formula)
...     return pass_manager.run(circuit)
여러 격자 크기에 걸쳐 두 지표를 수집하고 격자 변 길이에 대해 그리면 차이가 분명해집니다.
>>> sizes = [3, 4, 5, 6, 7, 8]
>>> lie_trotter = [
...     two_qubit_stats(transpile_trotter_step(n, n, LieTrotter())) for n in sizes
... ]
>>> flow = [
...     two_qubit_stats(transpile_trotter_step(n, n, FlowSetSynthesis(n, n))) for n in sizes
... ]
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sizes, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sizes, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="lattice edge $L$ (an $L \\times L$ lattice)", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

2-Qubit 깊이는 부터 까지(18개에서 128개 Qubit) 24로 일정한 반면, 동일하게 인코딩된 해밀토니안에 적용한 LieTrotter는 격자 변 길이에 따라 선형으로 47에서 92까지 증가합니다. 어느 쪽이든 적용할 항이 개이므로 Gate 수는 증가합니다. 흐름 집합이 없애는 것은 그 Gate들이 차지하는 층 수의 증가입니다.
예산은 호핑에 16, 상호작용에 8로 나뉩니다.
-
네 흐름 집합 각각은 개의 2-Qubit 층이 듭니다. 들어가는 Clifford와 나오는 역 Clifford로, 둘 다 구성상 깊이가 2이며 그 사이에는 단일 Qubit 회전만 있습니다. 이는 이며, 호핑 항만 세기 때문에 참고문헌 [1]이 제시하는 수치입니다. 위 코드에서 으로 두면 이를 재현합니다.
-
대각 그룹이 나머지 8을 더합니다. 이 그룹의
RzzGate는 네 층에 들어가고, 각Rzz는 단일 Qubit 회전을 감싼CXGate 두 개로 분해되므로 입니다. 네 층이 최적입니다. 정사각 격자에서 상호작용은 최근접 이웃에만 미치므로 모든 내부 사이트에는 (결합마다 하나씩)RzzGate가 네 개 있고 한 번에 하나에만 참여할 수 있습니다.
두 합 어디에도 격자 크기는 나오지 않으며, 이것이 핵심입니다.
8. 회로 검증
흐름 집합 합성과 LieTrotter는 같은 인코딩된 해밀토니안의 같은 Trotter 단계를 기술하므로, 두 유니터리는 전역 위상을 제외하고 일치해야 합니다. 임의의 상태 벡터를 쓰면 전체 유니터리를 만드는 것보다 훨씬 저렴하게 불일치를 감지할 수 있습니다.
두 회로 모두 상태에 적용하기 전에 1-Qubit 및 2-Qubit Gate까지 분해합니다. 분해하지 않고 두면 각 상위 수준 Evolution 명령 때문에 Statevector가 전체 밀집 연산자를 만들어야 합니다. 먼저 분해하면 Gate를 하나씩 적용할 수 있어 여기서는 수백 배 빠릅니다.
>>> import numpy as np
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(rows, cols, samples=3):
...     """Compare both syntheses on random states.
...
...     Returns whether they agree up to a phase, and whether it is the *same* phase
...     for every input state.
...     """
...     lie_trotter = transpile_trotter_step(
...         rows, cols, LieTrotter()
...     ).decompose(reps=6)
...     flow = transpile_trotter_step(
...         rows, cols, FlowSetSynthesis(rows, cols)
...     ).decompose(reps=6)
...     dimension = 2**lie_trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(lie_trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> agrees_up_to_one_phase(rows, cols)
(True, True)
그 검사의 두 절반 모두 중요합니다. 단일 상태에서 크기가 1인 겹침은 필요조건이지만 충분조건은 아닙니다. 상태에 의존하는 위상을 잘못 얻은 합성은 여전히 그것을 드러낼 것이기 때문입니다. 여러 임의 상태에서 같은 위상을 요구하는 것이 그 간극을 메웁니다.
9. 스태빌라이저 부분공간에서 물리 검증
여기가 2차원의 까다로운 부분입니다. 1D에서는 인코딩이 등거리 사상이어서 Jordan-Wigner 기준과 스펙트럼을 비교하는 것으로 충분했습니다. VC는 등거리 사상이 아닙니다. 개 모드에 개 Qubit을 사용하므로 차원 공간이 차원의 물리적 공간을 담습니다. 이는 2차원 국소 인코딩에 일반적인 것이며(여분의 Qubit은 플라켓마다 하나씩 국소 교환 대칭에 의해 제약됩니다 [2] [3]), 인코딩된 해밀토니안은 이 제약들의 결합 고유공간에서만 페르미온 해밀토니안을 충실히 나타낸다는 뜻입니다.
스태빌라이저라는 단어는 이 분야에서 두 가지 뜻으로 쓰이며, 두 의미는 관련이 없습니다. 참고문헌 [1]은 흐름 집합의 교환하는 전이 연산자에 이 말을 쓰는데, 이들은 5단계의 Clifford가 대각화하는 스태빌라이저 군을 이룹니다(컴파일 장치이며 위에서 줄곧 의도한 의미입니다). 이 절에서는 오류 정정의 의미로 씁니다. 고유공간이 물리적 부분공간인 연산자입니다. 참고문헌 [1]은 이 충돌을 명시적으로 지적하고 두 번째 의미는 제쳐 둡니다. 아래의 플라켓 제약은 흐름 집합 프레임워크의 결과가 아니라 VC 인코딩 [2]의 성질입니다.
생성자는 인용하지 않고 여기서 직접 구성합니다. 정사각 면마다 하나이며, 각각은 그 면을 도는 인코딩된 간선 연산자 고리입니다.
이를 위해서는 간선 연산자가 자연스러운 대상입니다. 이들의 닫힌 고리는 입자 수를 보존하는 모든 해밀토니안의 대칭이지만, 대응하는 전이 연산자의 고리는 그렇지 않습니다. 둘은 각 결합의 소스 사이트에 있는 꼭짓점 연산자만큼 다릅니다.
닫힌 고리를 따라 모든 사이트는 정확히 하나의 결합의 소스이므로, 고리는 사이트마다 를 하나씩 모으며 이것이 플라켓의 네 사이트의 국소 패리티입니다. 바로 이 국소 패리티가 차이를 만듭니다. 해밀토니안은 입자를 플라켓 경계 너머로 호핑시키므로 전역 패리티만 보존합니다. 따라서 단순한 전이 고리는 이와 교환하지 않지만, (패리티 인자를 지닌) 간선 고리는 교환합니다.
인코딩이 전이 연산자에 대해 정의되므로, 간선 연산자를 매핑하려면 위의 관계가 필요합니다. 이는 다섯 줄짜리 콜백이며, vc_action이 map_transfer_vertex_generators()에 끼워지는 것과 똑같이 map_edge_vertex_generators()에 끼워집니다.
>>> from qiskit_fermions.mappers import map_edge_vertex_generators
>>> from qiskit_fermions.operators import EdgeVertexOperator
>>>
>>> def vc_edge_action(generator, width, cols):
...     """Map one generalized *edge* operator to its Verstraete-Cirac Pauli."""
...     j, k = generator
...     if j == k:  # a vertex operator is the same object in both algebras
...         return SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     # The library decomposes T_jk = (i/2) V_j E_jk, so E_jk = -2i V_j T_jk. Reuse the
...     # transfer encoding for T_jk rather than repeating its four cases here. Note that
...     # `compose` left-multiplies its argument, so this composes to V_j T_jk; the other
...     # order carries the opposite sign, since a vertex and a transfer operator sharing a
...     # mode anticommute.
...     vertex = SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     return (-2.0j * vc_action(generator, width, cols).compose(vertex)).simplify()
>>>
>>> def vc_edge_encoding(operator, width, cols):
...     """Map an EdgeVertexOperator to a qubit observable, Verstraete-Cirac style."""
...     return map_edge_vertex_generators(
...         operator,
...         partial(vc_edge_action, width=width, cols=cols),
...         identity=lambda: SparseObservable.identity(width),
...         compose=SparseObservable.compose,
...     ).simplify()
>>>
>>> def plaquette_loops(rows, cols):
...     """The directed edge loop around each square face."""
...     at = lambda r, c: r * cols + c
...     return [
...         [(at(r, c), at(r, c + 1)), (at(r, c + 1), at(r + 1, c + 1)),
...          (at(r + 1, c + 1), at(r + 1, c)), (at(r + 1, c), at(r, c))]
...         for r in range(rows - 1)
...         for c in range(cols - 1)
...     ]
>>>
>>> def stabilizers(rows, cols):
...     """One plaquette stabilizer per square face of the lattice."""
...     num_qubits = 2 * rows * cols
...     out = []
...     for loop in plaquette_loops(rows, cols):
...         loop_operator = EdgeVertexOperator.from_dict({tuple(loop): 1.0})
...         encoded_loop = vc_edge_encoding(loop_operator, num_qubits, cols)
...         out.append(encoded_loop / complex(encoded_loop.coeffs[0]))
...     return out
>>>
>>> plaquette_stabilizers = stabilizers(rows, cols)
>>> for stabilizer in plaquette_stabilizers:
...     print(stabilizer.to_sparse_list())
[('ZZYXXY', [1, 4, 9, 10, 12, 13], (1+0j))]
[('ZZYXXY', [2, 5, 10, 11, 13, 14], (1+0j))]
[('ZZYXXY', [4, 7, 12, 13, 15, 16], (1+0j))]
[('ZZYXXY', [5, 8, 13, 14, 16, 17], (1+0j))]
각 생성자의 무게는 이며, 그 플라켓의 물리 Qubit 두 개와 보조 Qubit 네 개에 걸쳐 있습니다. 이들은 대합이며 인코딩된 해밀토니안과 교환하므로 동역학이 물리적 부분공간을 보존합니다. 두 성질 모두 연산자에 관한 명제이므로 SparseObservable 대수에서 기호적으로 검사하며, 행렬은 필요하지 않습니다.
>>> encoded = encoding(hamiltonian, num_qubits)
>>> identity = SparseObservable.identity(num_qubits)
>>> for stabilizer in plaquette_stabilizers:
...     square = stabilizer.compose(stabilizer).simplify()
...     print(square == identity, stabilizer.commutes(encoded))
True True
True True
True True
True True
스태빌라이저가 있으면 비교에 기저 대응이 필요하지 않습니다. 이므로 점유가 두 그림 모두에서 같은 물리 Qubit에 있기 때문입니다. 따라서 보조 Qubit을 에 둔 채 물리 Qubit에 곱 상태를 직접 쓰고, 이를 스태빌라이저 부분공간에 사영하고, 인코딩된 해밀토니안으로 발전시킨 뒤, 양쪽에서 사이트 밀도 를 읽습니다.
여기의 모든 단계는 벡터 수준에 머뭅니다. 사영 연산자는 곱해서 전개하지 않고 인자를 하나씩 적용하며, 시간 발전은 를 만들지 않고 를 계산하는 expm_multiply()를 사용합니다. 인코딩된 해밀토니안은 희소한 차원 연산자이므로, 이 구분 덕분에 이 절은 저렴하게 유지됩니다.
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> # an exact evolution time, unrelated to the Trotter step above
>>> evolution_time = 0.6
>>> reference = transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify()
>>>
>>> def to_sparse_matrix(observable):
...     # SparseObservable carries no dense- or sparse-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the numerical checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def basis_state(occupation, num_qubits):
...     """The computational basis state with `occupation` on the first qubits.
...
...     Qubit `q` carries bit `2**q`, and the ancillas are the *high* qubits `N..2N-1`,
...     so the same integer indexes the same site occupations on either register and
...     leaves every ancilla in |0>.
...     """
...     index = int("".join(str(bit) for bit in reversed(occupation)), 2)
...     state = np.zeros(2**num_qubits, dtype=complex)
...     state[index] = 1.0
...     return state
>>>
>>> def project_onto_codespace(state, stabilizers):
...     """Apply the projector one (1 + S) factor at a time, then renormalize.
...
...     The factors commute, so their product is itself a projector and the order does
...     not matter. Multiplying it out would build a dense 2^2N x 2^2N operator; applied
...     factor by factor this stays a handful of sparse matrix-vector products.
...
...     Each factor is really (1 + S)/2, but every one contributes the same scalar, so the
...     halvings only rescale the result and the final normalization absorbs them.
...     """
...     for stabilizer in stabilizers:
...         state += to_sparse_matrix(stabilizer) @ state
...     return state / np.linalg.norm(state)
>>>
>>> occupation = [1, 0, 1, 0, 1, 0, 0, 1, 0]  # site occupations of the initial state
>>> initial_reference = basis_state(occupation, num_sites)
>>> initial_encoded = project_onto_codespace(
...     basis_state(occupation, num_qubits), plaquette_stabilizers
... )
>>>
>>> evolved_encoded = expm_multiply(
...     -1j * evolution_time * to_sparse_matrix(encoded), initial_encoded
... )
>>> evolved_reference = expm_multiply(
...     -1j * evolution_time * to_sparse_matrix(reference), initial_reference
... )
>>>
>>> def density(state, qubit, width):
...     """Site density <n_j> = (1 - <Z_j>) / 2 of a statevector."""
...     z = to_sparse_matrix(
...         SparseObservable.from_sparse_list([("Z", [qubit], 1.0)], num_qubits=width)
...     )
...     return (1 - (state.conj() @ (z @ state)).real) / 2
>>>
>>> encoded_densities = [density(evolved_encoded, j, num_qubits) for j in range(num_sites)]
>>> reference_densities = [density(evolved_reference, j, num_sites) for j in range(num_sites)]
>>>
>>> for j, density_value in enumerate(encoded_densities):
...     print(f"site {j}: {density_value:.10f}")
site 0: 0.6750993356
site 1: 0.3689791258
site 2: 0.6750993356
site 3: 0.3818130396
site 4: 0.4868585996
site 5: 0.3818130396
site 6: 0.2693544696
site 7: 0.4916285849
site 8: 0.2693544696
>>> np.allclose(encoded_densities, reference_densities, atol=1e-12)
True
이것이 인코딩된 밀도이며, 사영 후에야 충실한 인코딩인 격자에서 Jordan-Wigner 기준과 기계 정밀도로 일치합니다.
10. Trotter 수렴 측정
8단계는 두 합성이 서로 일치함을 확인했는데, 이는 정확도가 아니라 동등성에 관한 명제입니다. 둘 다 같은 단일 Trotter 단계를 기술하므로 같은 Trotter 오차를 가집니다. 그 오차를 측정하려면 정확한 기준이 필요하며, 9단계가 방금 그것을 만들었습니다.
단계 수는 앞서 기준선으로 쓴 Qubit 수준 공식의 페르미온 대응물인 FermionicLieTrotter에서 옵니다. 분해 이전에 그룹화된 연산자 전체에 적용하면, 그 반복은 어느 한 집합 안이 아니라 네 흐름 집합과 대각 그룹 사이를 순환합니다.
>>> initial_state = project_onto_codespace(
...     basis_state(occupation, num_qubits), plaquette_stabilizers
... )
>>> exact = expm_multiply(
...     -1j * total_time * to_sparse_matrix(encoded), initial_state
... )
>>>
>>> def trotter_fidelity(steps):
...     # `steps` goes to the fermionic formula inside transpile_trotter_step, so the
...     # repetition cycles between the flow sets rather than within any one of them
...     circuit = transpile_trotter_step(
...         rows, cols, FlowSetSynthesis(rows, cols), steps=steps
...     )
...     evolved = Statevector(initial_state).evolve(circuit.decompose(reps=6))
...     return abs(np.vdot(evolved.data, exact)) ** 2
>>>
>>> for steps in (1, 2, 4, 8):
...     print(f"{steps} step(s): fidelity {trotter_fidelity(steps):.6f}")
1 step(s): fidelity 0.053820
2 step(s): fidelity 0.704014
4 step(s): fidelity 0.932937
8 step(s): fidelity 0.982687
단계가 짧아질수록 충실도가 단조롭게 1에 가까워지며, 이는 곱 공식이 보여야 하는 동작입니다. 단계를 짧게 하는 것은 두 조절 수단 중 하나일 뿐입니다. FermionicSuzukiTrotter는 더 높은 차수에서 둘을 맞바꿉니다. 이는 페르미온 공간에서 Evolution Gate 합성하기에서 측정합니다.
에서 이 해밀토니안의 단일 단계는 좋지 않은 근사이므로(네 호핑 집합과 상호작용은 교환하지 않습니다) 첫 행은 1과 거리가 멀며, 그것이 요점입니다. 구성을 확인해 주는 것은 어느 한 행이 아니라 수렴입니다.
일정의 각 인자는 이 격자의 모든 모드에 걸쳐 있으므로, 인자를 그 지지집합으로 좁히는 것은 여기서는 아무 영향이 없으며 FlowSetSynthesis가 매칭하는 절대 Qubit 인덱스는 바뀌지 않습니다. 그룹이 레지스터의 일부에만 닿는 연산자를 위해 작성한 합성은 그 재레이블링을 고려해야 합니다.
핵심 정리
-
2차원은 레시피가 아니라 부기를 바꿉니다. 1D 가이드의 모든 재료가 그대로 이어집니다. 그룹화에는
groups, 인코딩에는map_transfer_vertex_generators(), 맞지 않는 레지스터에는CustomF2QLayout, 이를 트랜스파일러에 연결하는 데는MapperFnEvolutionSynthesis를 씁니다. 커진 것은 각각 안에 있는 경우의 수입니다. -
서로소 성질이 2D를 상수 깊이로 만듭니다. 흐름 집합은 꼭짓점이 서로소인 줄들로 분해되므로 Clifford가 병렬로 나오고 격자가 아무리 커도 두 개의 2-Qubit 층을 공유합니다. 네 흐름 집합과 대각 그룹이 고정된 예산을 이룹니다. 여기서는 네 흐름 집합에 , 대각 상호작용 그룹에 입니다.
-
각 방향은 그 자체로 하나의 Pauli 형태입니다. 는
XXZ를YYZ로,XYXY를YXXY로 바꾸므로 네 흐름 집합에는 네 개의 Clifford가 필요합니다. 하나의 Clifford가 한 축의 두 방향을 모두 다룬다고 가정하는 것이 2D 흐름 집합 합성을 잘못 만드는 가장 쉬운 방법입니다. -
지지집합은 켤레 변환에서 읽으세요. 1D에서는
CZ브릭워크 하나가 이미지를 닫힌 형태로 줍니다. 2D에는 그런 공식이 없고 열 줄에는 연속적이지 않은 보조 Qubit이 있으므로, 각 항이 어디에 도달하는지 손으로 유도한 추측은 취약합니다. 켤레 변환하고 결과를 살펴보는 데는Clifford구성 한 번이면 되고 틀릴 수 없으며, 항을 다른 곳에 보내는 똑같이 유효한 Clifford도 계속 작동합니다. -
분류는 그룹화에 맡기세요.
Evolution이 그룹별로 스스로 분할하므로 합성은 한 번에 흐름 집합 하나를 받으며 분할을 다시 유도할 필요가 없습니다. 첫 항에서 Pauli 형태 하나를 읽고 맞는 Clifford를 고릅니다. 이를 가정하고 성립하지 않으면 예외를 발생시키는 것이synthesize를 짧게 유지해 줍니다. -
단계 수는 분할보다 위에 있습니다. 여기의 합성은 Gate당 흐름 집합 하나를 보므로 집합들에 걸쳐 시간 발전을 세분할 수 없습니다.
FermionicLieTrotter가 분해 이전에 페르미온 공간에서 이를 수행하며, 그 덕분에 수렴 검사가 가능해집니다. -
부분공간에서 검증하세요. 개 모드의 -Qubit 인코딩은 스태빌라이저가 말하는 곳에서만 충실합니다. VC가 를 유지하므로 가장 저렴하고 신뢰할 수 있는 검사는 곱 상태를 사영하여 밀도를 비교하는 것입니다. 얽힘 사상도, 제한된 해밀토니안이 겹침 상태일 때 신뢰할 수 없는 스펙트럼 매칭도 필요하지 않습니다.
인코딩된 해밀토니안은 스태빌라이저와 교환하므로 사영은 초기 상태에만 적용하면 됩니다. 시간 발전은 부분공간을 스스로 보존합니다. 실제 하드웨어에서는 스태빌라이저를 측정할 수 있으므로 이 인코딩이 오류 검출 자원으로도 유용합니다.
다음 단계
위 내용을 확장하는 방향은 둘이며, 둘 다 방법이 아니라 재료의 변경입니다. 첫째는 인코딩입니다. 여기서 Verstraete-Cirac을 고른 이유는 참고문헌 [1]이 대각화하는 Clifford를 닫힌 형태로 제공하기 때문이지만, Derby-Klassen은 사이트마다가 아니라 홀수 플라켓마다 보조 Qubit 하나를 사용하여 Qubit 대 모드 비율이 가 아닌 입니다. 이 인코딩의 전이 연산자는 Pauli 형태가 다르므로, 이식하려면 3단계의 인코딩 함수를 다시 쓰고 새 형태마다 Clifford를 찾아야 합니다. 그룹화, 레이아웃, 합성 골격은 그대로 이어집니다.
둘째는 격자 자체입니다. 여기의 모든 것은 열린 경계와 단일 페르미온 종을 가정합니다. 주기 경계는 각 줄을 순환으로 닫습니다. 각 화살표가 다음 것과 머리-꼬리로 만나므로 화살표들은 여전히 모두 교환하지만, 5단계의 두 Clifford 형태는 끝점이 있는 줄을 위해 만들어졌습니다. 개 사이트의 순환은 줄이 개를 갖는 곳에서 방향당 개의 결합을 가지므로, 감싸는 결합이 구성에 자리가 없어 별도 처리가 필요합니다. 스핀이 있는 모델은 더 쉽습니다. 흐름 집합은 건드리지 않고 레지스터를 두 배로 하고 대각 그룹에 온사이트 상호작용 항을 추가합니다. 어느 쪽도 상수 깊이 논증을 해치지 않지만 둘 다 부기를 바꾸며, 첫 번째 핵심 정리에서 말했듯 2차원이 더 크게 만드는 것이 바로 그 부분입니다.
하드웨어 연결성은 여기서 다루지 않습니다. 위의 모든 회로는 어떤 Qubit 쌍이든 상호작용할 수 있는 추상 레지스터 위에 구성되며, 보고된 깊이도 그 설정에서 센 것입니다. 실제 장치에는 제한된 커플링 맵이 있고, 이 인코딩을 거기에 매핑하는 것은 그 자체로 상당한 문제입니다. VC 레지스터는 -Qubit 그래프이며 Gate가 사이트와 그 보조 Qubit 사이, 이웃 사이트 사이, 이웃 보조 Qubit 사이에서 작용하므로, 레이아웃은 세 종류의 쌍을 모두 동시에 인접하게 유지해야 합니다. 그렇지 못하면 트랜스파일러가 SWAP Gate를 삽입하며, 그것이 더하는 층이 상수 깊이 구성이 되찾아 주던 것입니다. 참고문헌 [1]도 마찬가지로 CX만을 네이티브 얽힘 Gate로 하는 정사각 연결성 그래프를 가정하고 깊이 수치를 제시합니다. 주어진 장치 토폴로지에서 국소 인코딩에 좋은 레이아웃과 라우팅 전략을 찾는 일은 이 가이드의 범위를 벗어납니다.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.
F. Verstraete and J. I. Cirac, Mapping local Hamiltonians of fermions to local Hamiltonians of spins, J. Stat. Mech. 2005, P09012 (2005).
Y.-A. Chen and Y. Xu, Equivalence between fermion-to-qubit mappings in two spatial dimensions, PRX Quantum 4, 010326 (2023).