오류 완화
이 레슨은 다양한 오류 완화 기법의 배경을 설명하여, 각 기법을 언제 어떻게 사용하는 것이 가장 좋은지에 대한 직관을 기를 수 있도록 돕습니다. 중요한 점은, 이러한 기법의 최신 응용에서는 Samplomatic, Shaded Lightcones, Executor 같은 더 정교한 도구를 활용한다는 것입니다. 이러한 워크플로는 이후 레슨에서 다룹니다.
이 영상은 오류 완화 기법의 개요를 설명합니다. 아래 텍스트는 더 자세한 내용을 추가하고 Qiskit을 사용해 이러한 방법들을 살펴봅니다.
오류 완화 기법 개요
오류 완화는 양자 계산에서 오류가 발생한 이후에 그 영향을 줄이려는 모든 과정을 가리킵니다. 오류가 발생하지 않도록 막으려는 억제(suppression)나, 여러 물리 큐비트에 정보를 인코딩하고 그 정보의 일관성을 검사하여 하나의 논리 큐비트에서 정보를 보존하는 오류 정정과는 다릅니다. 이 레슨 전반에서 오류 완화 기법은 실행 중에 양자 상태를 정정하는 방법이 아니라, 이상적인 기댓값의 더 나은 추정기나 확률 분포의 더 나은 샘플러를 구성하는 방법으로 이해하는 것이 가장 좋습니다. 아래에서는 Qiskit과 그 애드온에서 모두 사용할 수 있고 양자 이점을 추구하는 데 유망한 도구인 오류 완화 방법들을 살펴보겠습니다.
**트월링된 판독 오류 소거(TREX)**는 측정 전에 무작위로 선택한 Pauli 연산을 적용하여 측정 과정을 무작위화한 다음, 그 알려진 효과를 관측된 비트열에서 고전적으로 되돌립니다. 적절한 측정 잡음 가정 아래에서 이는 판독 오류 채널을 더 단순하고 대칭적인 형태로 바꾸어, 보정하고 완화하기 더 쉽게 만듭니다.
**행렬 없는 측정 완화(M3)**는 할당 행렬이나 그 역행렬을 명시적으로 구성하지 않는, 확장 가능한 측정 오류 완화 기법입니다.
**영잡음 외삽(ZNE)**은 알려진 배수로 잡음을 인위적으로 키운 뒤 잡음이 없는 경우로 외삽하여, 잡음이 없을 때 관측량이 가질 값을 근사합니다. 이를 위해서는 잡음이 예측 가능한 방식으로 증가해야 합니다. 그러한 예측 가능성을 확보하려면 이 레슨에서 다루는 다른 방법(펄스 늘이기, 게이트 폴딩, 확률적 오류 증폭(PEA))이 필요할 수 있습니다.
**확률적 오류 상쇄(PEC)**는 가장 강력한 오류 완화 기법 중 하나이지만 계산 비용도 가장 큰 기법입니다. 시스템의 잡음 특성을 학습한 뒤, 이상적인 계산의 비편향 추정값을 통계적으로 구성하여 잡음을 상쇄하려고 시도하는 방식입니다. PEC가 출력하는 것은 오류가 정정된 결과가 아니라 통계적으로 보정된 관측량입니다.
이제 이러한 방법들을 하나씩 자세히 살펴보겠습니다.
M3
측정 오류는 근미래 양자 장치에서 가장 끈질기고 하드웨어에 특화된 잡음원 중 하나입니다. 양자 상태가 올바르게 준비되고 발전했더라도, 마지막 판독 단계에서 실제 계산 기저 결과를 잘못 보고할 수 있습니다. 이러한 오류는 과 에 해당하는 물리 상태를 불완전하게 구별하는 것, 측정 중의 이완, 측정 전자장치의 결함에서 비롯됩니다. 그 결과 관측된 비트열 분포는 실제(이상적) 분포가 왜곡된 형태인 경우가 많으며, 확률이 결과들 사이에서 잘못 재할당됩니다.
측정 완화는 측정 결과가 어떻게 잘못 할당되는지를 명시적으로 모델링하여 이 문제를 다룹니다. 표준적인 정식화에서는 이러한 동작을 할당 행렬 로 나타내며, 원소 는 실제 기저 상태가 였을 때 결과 가 기록될 확률을 나타냅니다. 측정 잡음이 고전적이고 정상적(stationary)이라면, 관측된 확률 벡터 는 이상적인 분포 과 다음과 같은 단순한 선형 관계로 연결됩니다.
할당 행렬 는 양자 채널이 아니라 고전적인 확률 사상(stochastic map)이라는 점에 유의하세요. 이 행렬은 판독을 얻기 위해 샘플링된 기저의 양자 상태가 아니라 고전적인 판독값에 작용합니다.
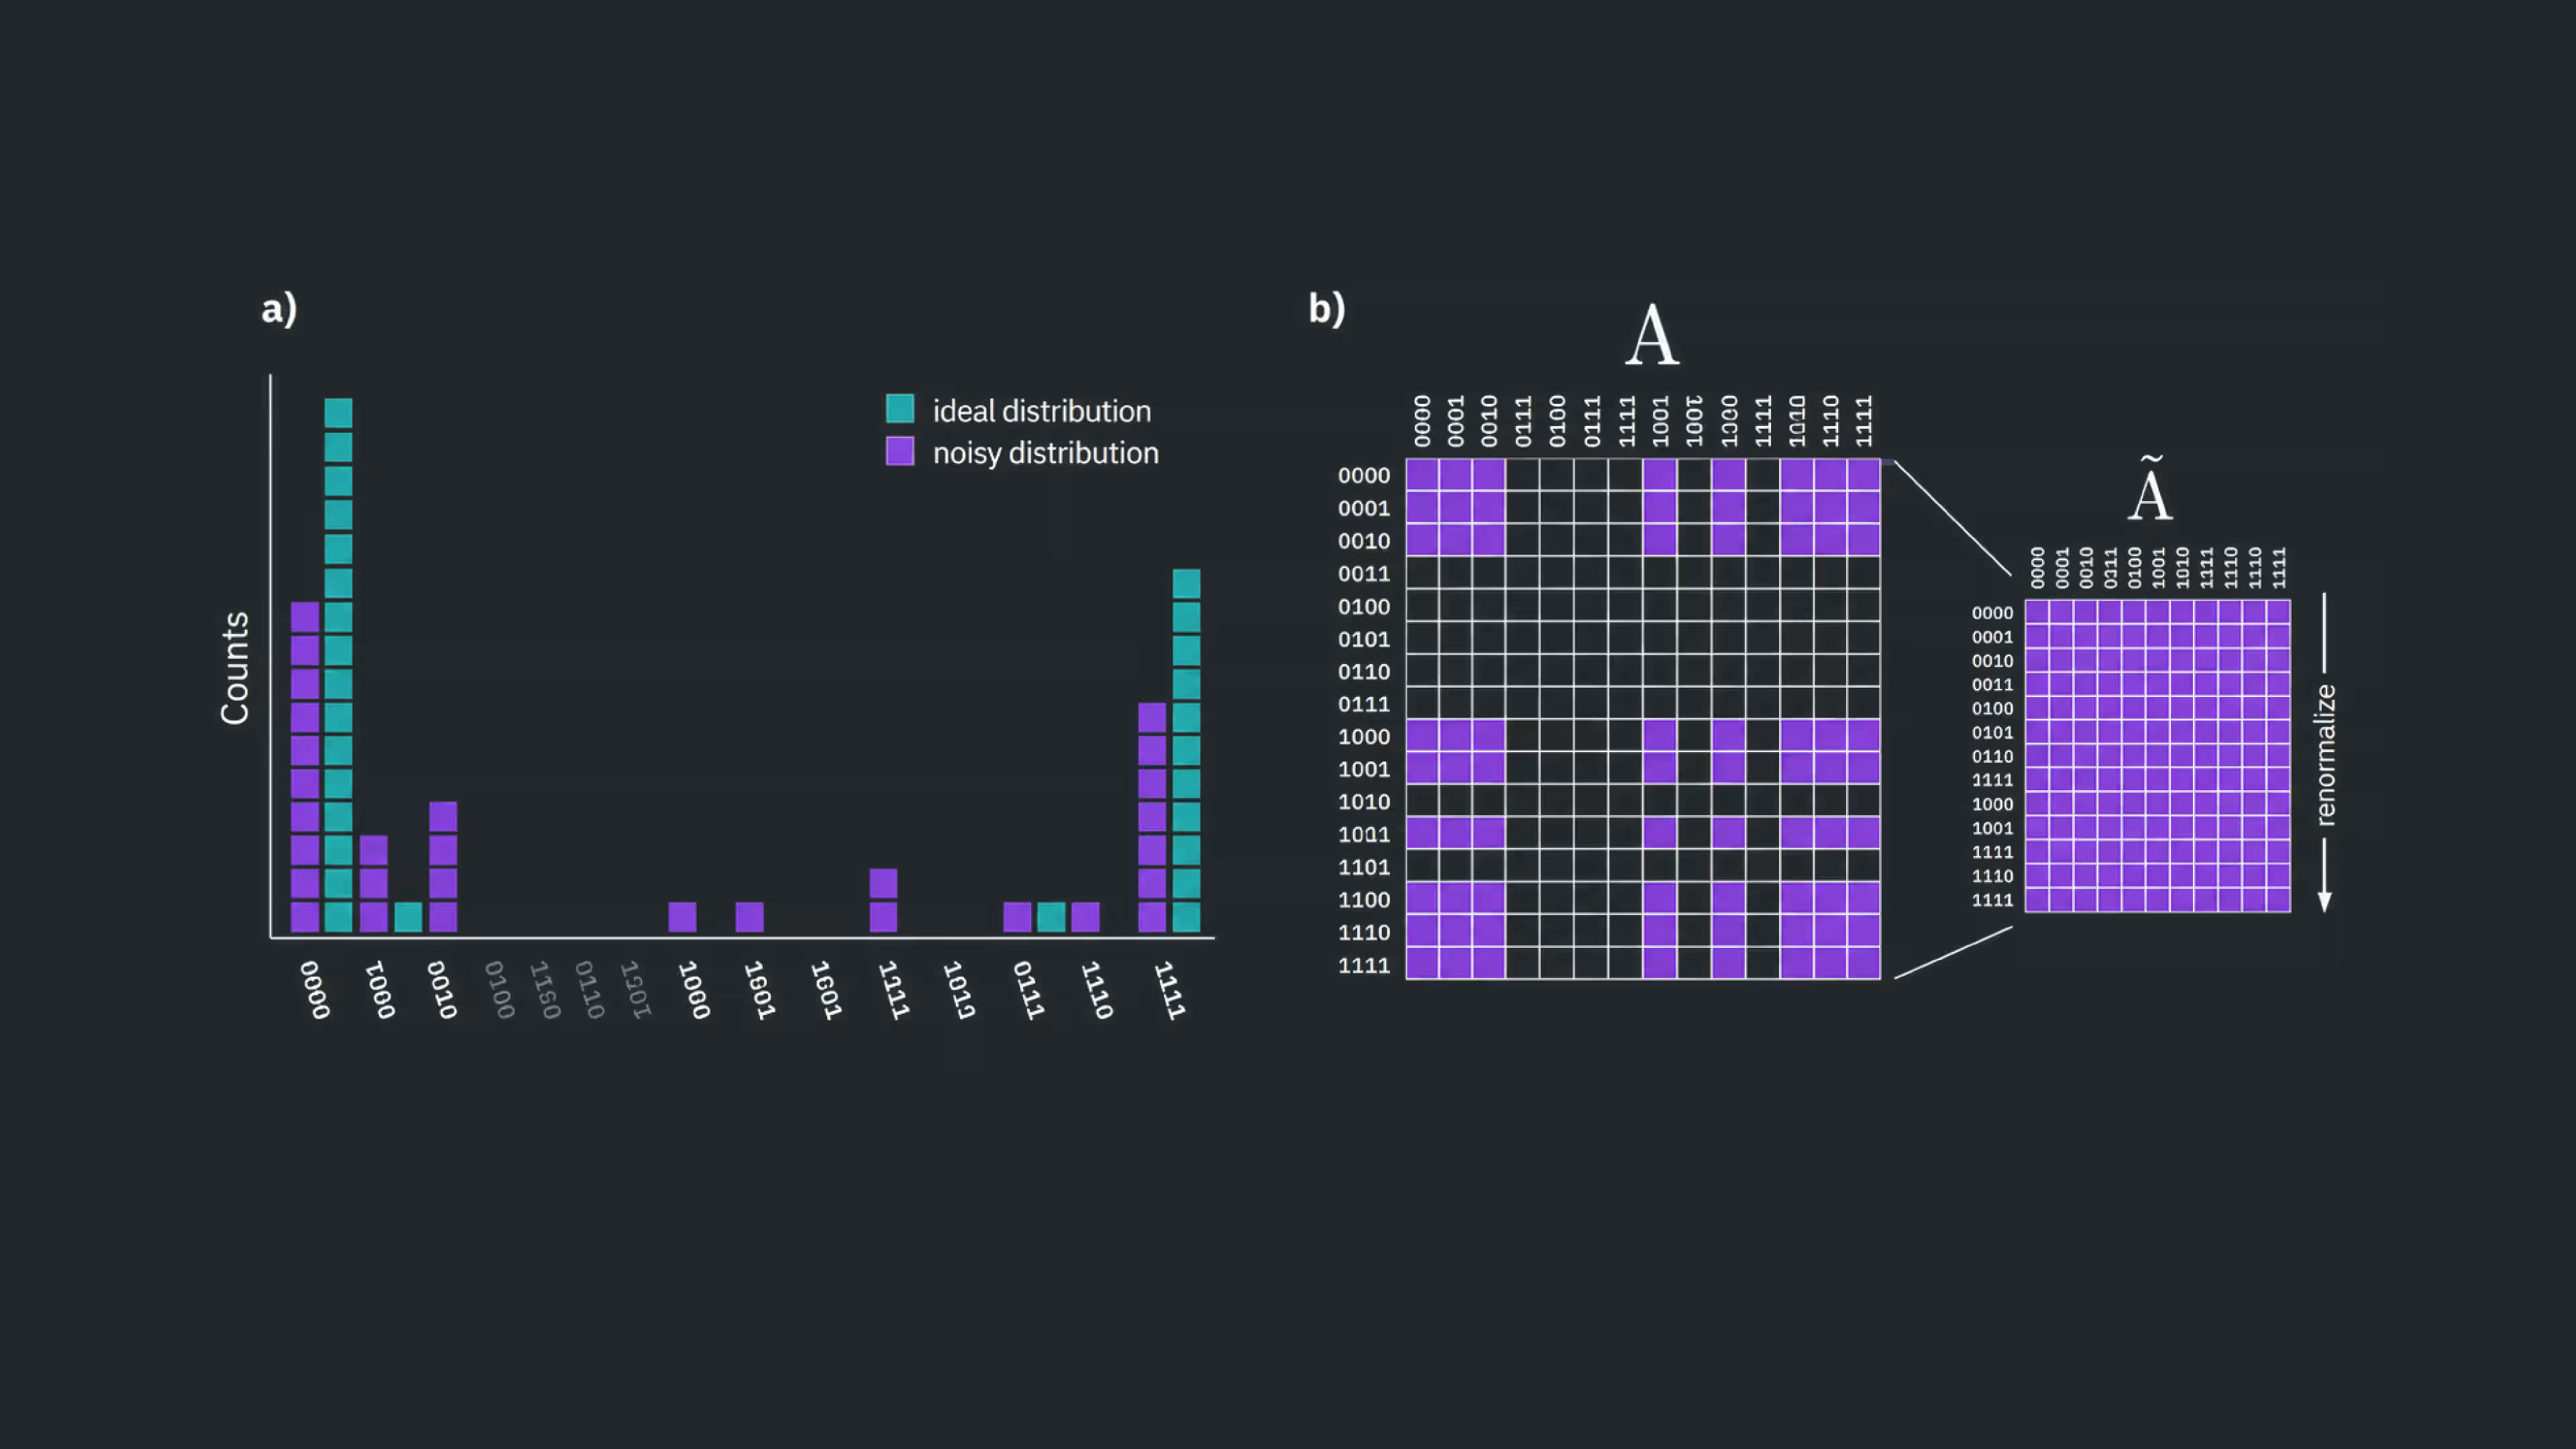
행렬 없는 측정 완화(M3)는 이 구조를 이용하여, 큐비트 수가 많으면 불가능할 전체 행렬 를 만들거나 역행렬을 구하지 않고도 의 완화된 추정값을 구성합니다. 대신 M3는 많은 근미래 양자 워크로드가 매우 뾰족하거나 엔트로피가 낮은 분포를 만든다는 사실을 활용하여, 관측된 분포에 크게 기여하는 결과의 부분집합에만 완화를 집중합니다.
할당 모델을 만들려면 양자 하드웨어에서 추가 보정 실험을 실행해야 합니다. 이러한 실험은 보통 알려진 계산 기저 상태를 준비하고 측정 시스템이 이를 어떻게 보고하는지 기록하는 것입니다. 보정 오버헤드는 측정되는 큐비트 수에 따라 증가하는 반면, 완화의 계산 비용은 관측된 분포의 구조에 따라 달라집니다. 이 비용은 전체 할당 행렬을 명시적으로 규명하는 데 필요한 비용보다 훨씬 작습니다. 이 보정 오버헤드는 실제로 존재하지만 영잡음 외삽이나 확률적 오류 상쇄 같은 회로 수준 기법에 비하면 가벼우므로, M3는 근미래 양자 실험에서 판독 오류를 완화하는 실용적이고 널리 쓰이는 도구입니다.
보정은 측정 과정이 보정 실행과 대상 실험 사이에서 충분히 안정적으로 유지되는 범위에서만 유용하다는 점에 유의하세요.
먼저 간단한 경우를 직접 계산하여 작동 방식을 보여 주고, 이어서 Qiskit에 내장된 도구로 더 현실적인 규모에서 M3를 사용하는 방법을 보여 드리겠습니다.
M3 간단한 예제
먼저 간단한 Bell 상태를 만듭니다.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
이 예제는 매우 작은 회로로 한정하므로 잡음 모델이 있는 시뮬레이터를 사용할 수 있습니다. 다음과 같은 형태의 판독 오류를 갖도록 잡음 모델을 명시적으로 구성합니다.
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
이러한 판독 오류율은 실제 IBM® 양자 컴퓨터에서 볼 수 있는 값보다 훨씬 높습니다. M3의 효과를 명확하게 볼 수 있도록 교육적인 목적으로 높은 값을 선택했습니다.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
잡음이 있는 시뮬레이터에서 회로를 실행하여 판독 오류의 영향을 관찰할 수 있습니다.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
이 간단한 예제에서는 잡음 모델의 판독 오류를 우리가 직접 정의했습니다. 하지만 실제 양자 컴퓨터를 사용할 때는 판독 오류를 미리 알 수 없습니다. 대신 실험적으로 추정해야 합니다. 이를 위해 큐비트를 알려진 계산 기저 상태 또는 로 준비하고 측정하는 회로를 만듭니다. 판독 오류가 없다면 준비한 상태를 정확히 측정하게 됩니다. 이러한 측정에서 통계를 수집하면 판독 오류를 나타내는 할당 행렬을 구성할 수 있습니다. 이 간단한 예제에서는 우리가 정의한 행렬과 비슷한 모습이어야 합니다.
더 현실적인 시스템에서는 각 물리 큐비트마다 통계를 누적해야 합니다. 트랜스파일 과정에서 추상 회로가 하드웨어에 매핑되고 큐비트 번호가 바뀌기 때문에 이는 때때로 간단하지 않습니다. 이 부분은 다음 예제에서 다시 다루겠습니다. 이 시뮬레이터 예제에서는 모든 큐비트에 동일한 판독 오류 모델을 할당했으므로 한 번의 규명으로 충분합니다.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
이것이 시뮬레이터를 구성하는 데 사용된 판독 오류 행렬과 매우 비슷하다는 점에 유의하세요.
다시 말하지만, 실제 양자 컴퓨터에서는 여러 물리 큐비트에 대해 이와 같은 통계를 얻게 됩니다. 이 시뮬레이터에서는 두 큐비트가 동일하고 서로 독립적인 판독 오류를 가진다고 가정하므로, 두 큐비트 할당 행렬 A_2q를 해당하는 한 큐비트 행렬들의 텐서 곱으로 구성할 수 있습니다. 또한 M3의 핵심은 전체 할당 행렬을 구성하는 것이 아니라는 점에 유의하세요. 대신 M3는 관측된 분포에 크게 기여하는 결과의 부분집합에 집중합니다. 여기서는 작동 방식을 보기 위해 매우 작은 예제의 전체 행렬을 구성해 보겠습니다. qiskit-ibm-runtime의 M3 구현은 이 간단한 예제보다 더 정교합니다. 서로 다른 판독 특성을 가진 많은 큐비트를 처리하면서도 전체 할당 행렬의 구성을 피해야 하기 때문입니다.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
이 예제에서는 서로 다른 큐비트의 판독 오류가 독립적이라고 가정하므로, 두 큐비트 할당 행렬을 해당하는 한 큐비트 행렬들의 텐서 곱으로 구성할 수 있습니다.
비교를 위해 원시 결과와 완화된 결과를 구합니다.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
이 시점에서 우리는 측정 과정이 이상적인 결과 확률을 어떻게 왜곡하는지 실험적으로 규명했습니다. 이제 목표는 이 왜곡을 되돌리고, 그 결과로 얻은 보정을 원시 확률에 적용하는 것입니다.
물리적인 정정이 아니라 선형 역변환을 수행하기 때문에, 결과로 나오는 "확률"이 항상 양수일 필요는 없습니다. 아주 작은 음의 준확률은 예상되는 현상이며, 측정 완화가 물리적인 확률 분포가 아니라 추정기를 만들어 낸다는 사실을 반영합니다.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
이를 그래프로 그리기 위해 카운트로 변환합니다.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
마지막으로 원시 분포, 완화된 분포, 이상적인 분포를 살펴봅니다. 아래의 완화된 "카운트"는 완화된 준확률의 크기를 조정해 얻은 시각화 보조 수단일 뿐입니다.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
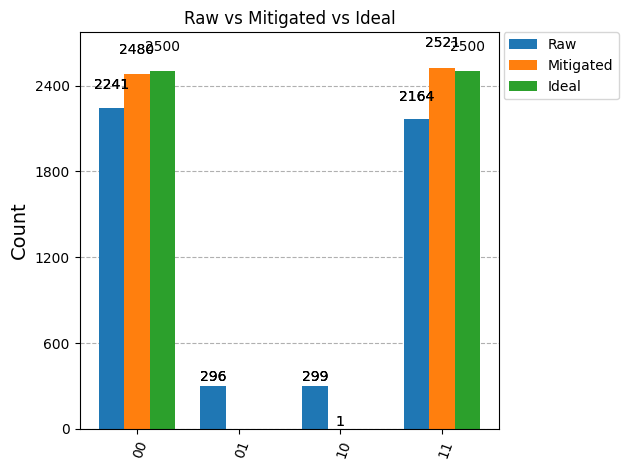
M3로 완화한 결과가 이상적인 분포에 훨씬 더 가깝다는 것을 분명히 알 수 있으며, 그 이유도 확인할 수 있습니다.
M3를 더 현실적인 워크플로에 적용하는 것은 훨씬 더 복잡합니다. 다음을 고려해 보세요.
- 실제 양자 컴퓨터에는 많은 물리 큐비트가 있고, 각 큐비트마다 고유한 판독 오류 특성이 있습니다. 이러한 오류를 모델링하고 적절히 결합해야 합니다.
- 전체 할당 행렬 는 큐비트 수에 따라 지수적으로 커지므로 명시적으로 구성하기가 금방 비현실적이 됩니다. 이것이 M3가 전체 할당 행렬을 구성하는 대신 관측된 분포에 크게 기여하는 결과의 부분집합에 집중하는 이유입니다.
- 관심 있는 실제 문제에서는 이상적인 분포를 알 수 없을 수도 있습니다.
이러한 모든 이유로, 전체 완화 워크플로는 mthree Qiskit 애드온에 캡슐화되어 있습니다.
더 큰 M3 예제
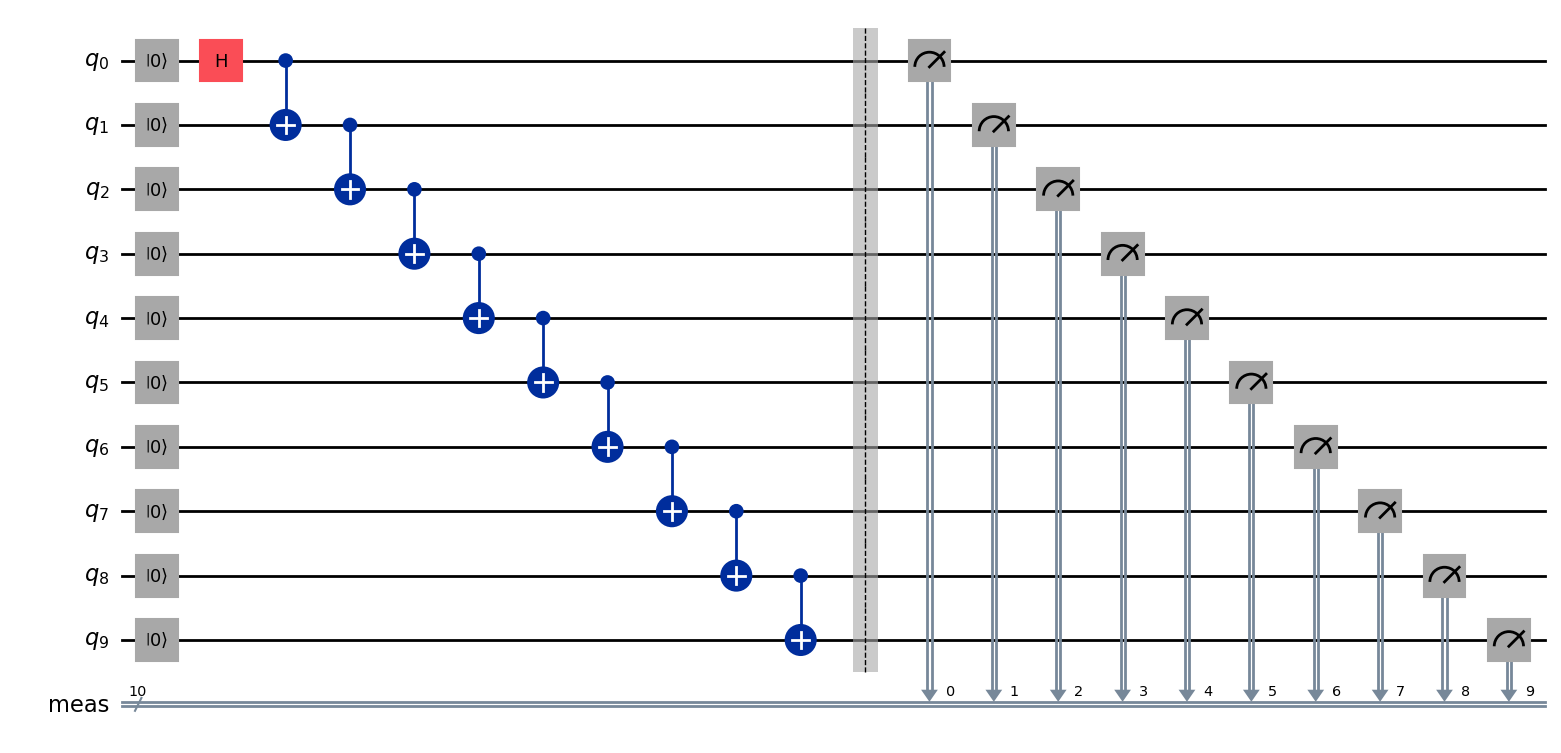
이제 M3를 더 큰 회로에 적용합니다. 이 회로는 의 관련 부분공간을 직접 결정하기에는 번거롭지만, 이상적인 분포를 알 수 있을 만큼은 단순한 GHZ 상태입니다. 먼저 mthree 패키지를 가져오고 GHZ 양자 회로를 정의합니다.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
이를 실제 양자 컴퓨터에서 실행하기 위해 qiskit_ibm_runtime과 필요한 다른 패키지를 가져옵니다. 출력 분포를 얻기 위해 SamplerV2를 사용합니다.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
이제 회로를 백엔드에 맞게 트랜스파일합니다. 추가 도구를 더하지 않고 M3의 효과에 집중하기 위해 여기서는 최적화 수준을 0으로 설정합니다. 이는 최종 충실도가 사용 가능한 모든 도구를 활용하는 IBM Quantum® 하드웨어에서 달성할 수 있는 값을 대표하지 않는다는 뜻이지만, M3의 유용성에 구체적으로 집중할 수 있게 해 줍니다.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
이제 Sampler를 구성합니다. 여기서도 동적 디커플링과 트월링 같은 추가적인 오류 억제 기법은 비활성화합니다.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
마지막으로 작업을 실행합니다.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
위 회로에서 원시 카운트를 추출할 수 있습니다.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
이제 백엔드에서 mthree를 실행하여 측정 완화에 사용되는 할당 모델을 규명합니다. 그 정보를 사용해 원시 분포의 크기를 다시 조정합니다. 이 과정에서 때때로 아주 작은 음의 확률이 나타날 수 있다는 점에 유의하세요(그래서 준확률이라는 용어를 사용합니다).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
mthree 보정은 카운트가 아닌 준확률을 만들어 냅니다. 이를 직접 카운트로 환산할 수 있습니다. 아래의 도우미 함수는 카운트로 변환한 뒤 정수 값으로 반올림합니다. 또한 큰 회로에서는 카운트가 매우 적은 잘못된 문자열이 많이 생겨 히스토그램을 어지럽힙니다. 아래의 두 번째 도우미 함수는 우리가 정한 임곗값보다 카운트가 적은 문자열을 제거하여, 분포에서 지배적인 항을 명확하게 볼 수 있게 해 줍니다.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
비교를 위해, 모두 0인 상태와 모두 1인 상태가 같은 확률을 갖고 다른 모든 결과의 확률은 0인 이론적이고 이상적인 분포도 쉽게 만들 수 있습니다.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
마지막으로 결과를 시각화할 수 있습니다.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
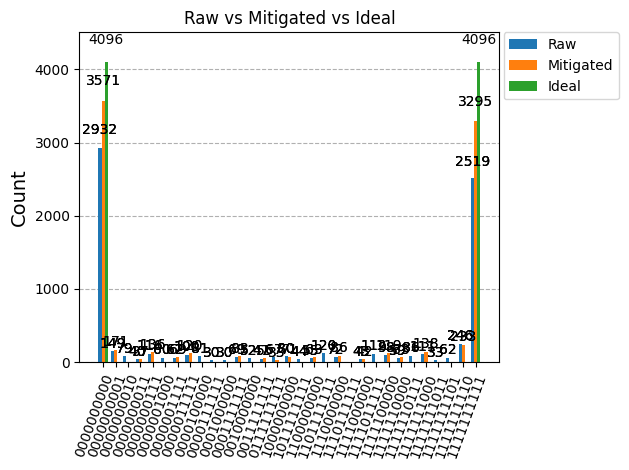
완화된 결과가 완화되지 않은 결과보다 이상적인 분포에 더 가깝습니다. 이상적인 비트열의 카운트를 사용하면 이를 더 잘 정량화할 수 있습니다.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
이 간단한 도구는 비교적 낮은 오버헤드로, 완화되지 않은 충실도에 비해 충실도를 26% 향상시켰습니다. M3가 매우 유용할 수 있음이 분명합니다. 하지만 GHZ 회로는 두 출력 상태에 크게 집중되어 있기 때문에 좋은 사용 사례로 선택되었습니다. 어떤 문제는 카운트가 더 고르게 분포된 결과(고엔트로피 상태)를 만들어 냅니다. 큐비트가 많은 매우 깊은 회로에서는 게이트 오류와 측정 오류와 무관한 잡음 때문에 고엔트로피 상태가 되는 경우가 많습니다. 이러한 경우 M3는 상당히 큰 상태 공간에서 작동합니다. 이에 대한 접근법은 세 가지가 있습니다.
(1) 이것이 M3의 한계임을 받아들입니다.
(2) M3가 구성하는 행렬 공간의 상한은 이 아니라 num_shots num_shots이며, 큐비트 수 이 클 때는 전자가 훨씬 작다는 점에 유의하세요.
(3) 아주 신중하게, M3에 입력되는 원시 카운트에서 확률이 매우 낮은 비트열을 제거합니다. 이로 인해 편향이 생길 수 있고, 상태의 지지집합(support)을 제한하면 Krylov 방법 같은 접근법에서 수렴을 방해할 수 있습니다. 이 작업은 왜 그렇게 하는지 정확히 알고 있고 모든 영향을 예상할 수 있을 때만 해야 합니다. 이것이 이러한 제거가 M3의 내장 기능이 아닌 이유입니다.
mthree Qiskit 애드온에 대한 더 자세한 내용은 문서에서 예제, 설치 방법, 배경 설명, API 레퍼런스를 참고하세요.
트월링된 판독 오류 소거(TREX)
트월링된 판독 오류 소거(TREX)는 최신 양자 컴퓨터에서 사용되는 측정 오류 완화 기법입니다. 측정 할당 행렬 전체를 규명하거나 역행렬을 구하지 않고도 고전적인 판독 오류로 인한 편향을 제거하는 것이 목표입니다.
TREX는 오류 정정이 아니며 상태 충실도를 향상시키지도 않습니다. 대신 무작위화된 측정 기저에 대해 평균을 내고 크기를 다시 조정함으로써, 기댓값 추정기가 통계 오차 범위 내에서 판독 잡음에 대해 편향되지 않도록 합니다. IBM Quantum 하드웨어에서 TREX는 기댓값 추정의 기본 완화 방법이며, IBM Quantum Estimator 프리미티브의 resilience_level = 1에 해당합니다.
초전도 하드웨어에서 판독 오류의 특성
IBM 초전도 큐비트에서 판독 오류는 주로 다음 요인에 의해 좌우됩니다.
-
비대칭적인 비트 반전 확률(예: 이 그 반대보다 더 자주 발생)
-
측정 자체 중에 일어나는 상태 의존적 이완
-
이웃한 판독 공진기 사이의 약하지만 무시할 수 없는 크로스토크
중요한 점은 이러한 오류를 측정 결과에 작용하는 고전적인 확률 과정으로 모델링할 수 있는 경우가 많다는 것입니다. TREX는 잡음 맞춤화(noise tailoring)의 표준적인 아이디어인 측정 절차의 무작위화(트월링)를 활용합니다. TREX는 일반적으로 두 단계로 진행됩니다.
-
트월링과 고전적인 "언트월링"
-
보정 회로를 사용한 기댓값의 크기 재조정
관측량 의 기댓값이 다음과 같이 잡음이 있는 추정값과 관련되어 있다고 가정합니다.
여기서 는 추정값의 크기를 조정하는 고정 계수이고 는 위에서 설명한 요인들로 인한 편향입니다. 여기서는 판독 오류만 다루고 있고 게이트 오류는 여전히 고려해야 한다는 점을 상기시키기 위해 를 사용했습니다.
측정 직전에 각 큐비트는 Pauli 연산자(I 또는 X 등)로 무작위로 켤레 변환됩니다. 측정 결과는 이후에 고전적으로 언트월링됩니다.
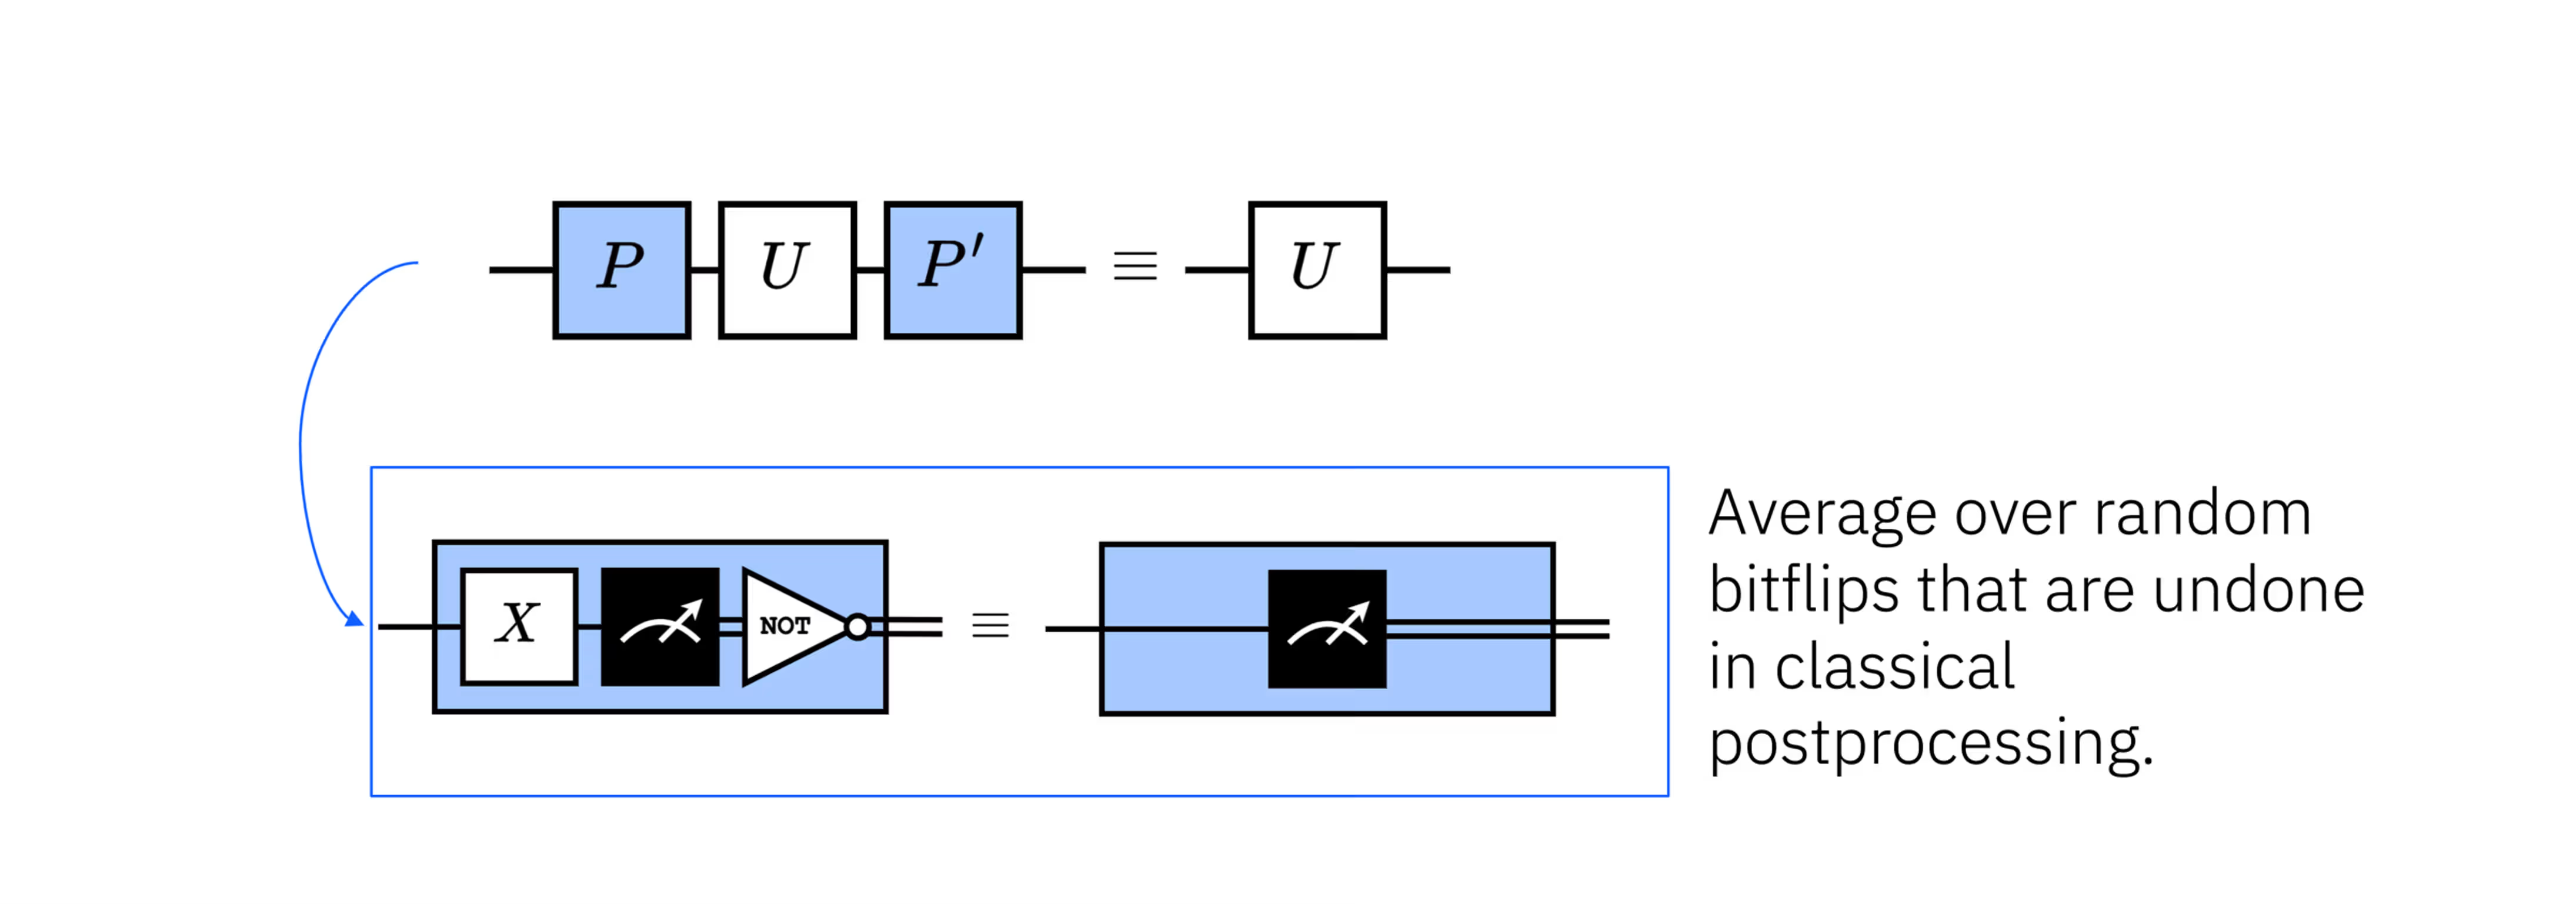
이러한 무작위화에 대해 평균을 내면 판독 채널이 대칭화됩니다. 그 결과 판독 과정의 체계적인 비대칭성이 더 대칭적인 오류 채널로 바뀌고, 남은 영향은 보정과 크기 재조정을 통해 처리할 수 있습니다. 쉽게 말해, 예를 들어 상태로 치우친 편향이 있다면 측정 일부가 누락될 것입니다. 측정을 트월링하면 어떤 논리적 결과가 물리적 판독 과정과 연결되는지를 무작위로 서로 바꾸고, 이후 고전적으로 그 교환을 되돌립니다. 이렇게 무작위화된 많은 측정에 대해 평균을 내면 한 보고 결과를 다른 결과보다 체계적으로 선호하는 경향이 제거됩니다. 이로써 TREX 모델의 가정 아래에서 지배적인 측정 편향이 제거되어 다음과 같이 됩니다.
그러나 기댓값의 크기를 다시 조정해야 할 수도 있습니다. 두 번째 단계는 보정 회로(결과를 알고 있는 회로)를 사용하여 크기 계수 를 추정하는 것입니다. 이를 사용하면 크게 향상된 추정값을 얻을 수 있습니다.
Pauli 관측량의 기댓값은 이상적인 값의 비편향 추정기가 됩니다. 명시적인 잡음 모델을 학습하거나 역변환하지 않으므로 TREX는 수치적으로 안정적이고 비용이 적게 듭니다. 다시 말하지만 여기서는 게이트 오류를 다루지 않았습니다.
관측량 의 기댓값 을 추정할 때 유한 샘플링으로 인한 분산, 여러 유형의 비간섭성 및 간섭성 오류, 그리고 판독 오류로 인한 편향 가 있을 수 있습니다. 이 편향은 앞서 논의한 비대칭적인 전이와 같은 요인에서 비롯됩니다. 실제로 이 편향은 양자 발전 이후에 작용하는 고전적인 확률 채널로 잘 모델링되는 것이 일반적입니다. TREX는 유효 측정 채널을 변환하여 의 추정기가 판독 오류에 대해 편향되지 않도록 합니다. 가장 단순한 트월링 게이트인 X를 예로 들면 이를 비교적 쉽게 알 수 있습니다. 이 에 비해 비대칭적이더라도, 어떤 상태를 읽을지 무작위로 바꾸고(나중에 고전적으로 되돌리면) 체계적인 비대칭성이 분명히 제거됩니다(다만 유한 샘플링 때문에 측정에는 여전히 약간의 확률적 비대칭이 있을 수 있습니다). 실제로 TREX를 위한 트월링 게이트는 I와 X에 한정되지 않지만, 설명에는 이것으로 충분합니다.
TREX를 사용하면 판독 오류로 인한 편향이 없는 기댓값 추정값을 얻을 수 있습니다. 간섭성 과회전 같은 다른 원인에서 비롯된 편향은 여전히 남아 있을 수 있으며, TREX는 판독만을 대상으로 합니다. TREX는 체계적인 편향을 무작위화된 대칭화로 대체하기 때문에, 일반적으로 편향을 추가적인 확률적 분산으로 바꾸어 고정된 샘플링 비용에서 추정기의 분산을 증가시킵니다.
이해도 확인
상태 를 준비한 회로에서 을 추정하는 데 Estimator를 사용한다고 가정합니다. 또한 측정 오류 때문에 에 해당하는 결과가 10%의 확률로 으로 보고되고, 에 해당하는 결과는 1%의 확률로만 로 보고된다고 가정합니다. 이러한 보고 오류 사이의 비대칭성은 측정 편향을 일으킵니다.
(a) 이러한 측정 오류가 전혀 없다면 관측량 의 이상적인 기댓값은 얼마일까요?
(b) 비대칭적인 측정 또는 판독 오류가 있을 때 관측량 의 기댓값은 얼마일까요?
(c) 제한된 Pauli 트월링 게이트 집합인 I와 X를 고려합니다. 여러 샷에서 I와 X가 각각 50%의 확률로 무작위 적용된다고 가정합니다. 동일한 측정 오류율이 여전히 적용됩니다. 그런 다음 Pauli 게이트(I 또는 X)를 고전적으로 되돌립니다. 초기 중첩, 비대칭적인 측정 오류, 무작위로 할당된 Pauli 게이트로 인해 가능한 모든 결과와 그 확률을 표로 만드세요.
(d) 이 표를 사용하여 트월링 전략을 적용했을 때의 기댓값 를 구하세요.
(e) 이상적인 경우, 트월링이 없는 경우, 트월링이 있는 경우의 기댓값을 비교하세요.
(f) 전체 TREX 적용에는 있지만 이 설명에서 빠진 것은 무엇일까요?
정답
(a) 직관과 대칭성만으로 이라고 말할 수 있습니다. 명시적으로 보이면 다음과 같습니다.
(b) 측정하면 상태는 각각 50%의 확률로 또는 로 붕괴할 수 있습니다. 그러나 상태로 붕괴한 50% 중 1%(전체 경우의 0.5%)는 로 잘못 보고됩니다. 로 붕괴한 50% 중 10%(전체 경우의 5%)는 로 잘못 보고됩니다. 그 결과는 다음과 같습니다.
- 54.5%
- 45.5% 가능한 다른 모든 유형의 오류를 무시하면 다음과 같은 추정값을 얻게 됩니다.
(c)
| Pauli | 이상적인 측정 결과 | Pauli 적용 후 결과 | 판독 오류 | Pauli 되돌리기 | 최종 보고 결과 | 확률 |
|---|---|---|---|---|---|---|
| I | 0 | 0 | None | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | None | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | None | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | None | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) 앞선 부분에서 각 최종 상태에서의 Z 기댓값을 알고 있습니다. 가중 평균만 구하면 됩니다.
(e) 이 매우 단순한 경우에는 트월링을 적용하여 이상적인 기댓값을 정확히 복원했습니다. 이는 일반적인 결과가 아닙니다. 일반적으로는 트월링이 비대칭적인 전이로 생긴 것과 같은 편향을 제거하고 이상적인 값에 더 가까운 기댓값을 돌려줍니다.
(f) 이것은 장난감 모델 적용입니다. 빠진 것이 여러 가지 있을 수 있습니다. 특히 여기서는 크기 조정 계수 를 추정하기 위한 보정 회로를 실행하지 않았습니다. 이는 보통 필요합니다.
구현 세부 사항
TREX는 EstimatorV2 프리미티브를 resilience_level = 1(기본값)로 사용할 때 자동으로 적용됩니다. Sampler는 기댓값이 아니라 전체 확률 분포를 반환하므로, Sampler 프리미티브에는 자동으로 적용되지 않는다는 점에 유의하세요.
TREX가 활성화되면 런타임은 측정 직전에 무작위 단일 큐비트 Pauli를 삽입하여 측정 트월링된 회로 변형을 생성합니다. 고전적인 후처리 단계에서 이 Pauli들을 되돌립니다. 이러한 회로 변형은 샷마다, 그리고 한 샷 안에서도 큐비트마다 무작위입니다. 모든 회로 변형은 이후 하나의 추정기로 결합됩니다.
TREX는 확장성이 매우 좋습니다. 추가 보정 회로가 필요하므로 샘플링 오버헤드는 보통 작은 상수 배(대개 2-4배)입니다. 하지만 이 완화는 관측량에 특화되어 있으며 분포를 보존하지 않습니다.
TREX는 다음을 포함한 많은 오류 억제 및 오류 완화 방법과 깔끔하게 통합되도록 설계되었습니다.
-
동적 디커플링(DD) - 유휴 시간 동안 작용하며 판독 완화와는 직교합니다.
-
게이트 또는 Pauli 트월링 - 서로 보완적인 경우가 많습니다. TREX는 이미 트월링에 의존하지만 판독 잡음만을 대상으로 합니다.
-
영잡음 외삽(ZNE) - ZNE는 게이트 잡음을 대상으로 하고 TREX는 측정 편향을 처리합니다. 이 조합은 복원력 수준 2에서 사용됩니다.
-
Estimator 워크플로에서의 확률적 오류 증폭과 확률적 오류 상쇄.
그러나 TREX와 결합할 수 없거나 결합해서는 안 되는 방법도 있습니다.
-
Sampler 수준의 확률 보정: TREX는 보정된 비트열 확률을 반환하지 않습니다.
-
이미 TREX로 완화된 데이터에 대한 사후 완화: 이중 보정은 편향을 다시 유발할 수 있습니다.
TREX를 M3와 같은 할당 행렬 기반 판독 완화와 결합하는 것은 까다롭습니다. M3는 측정 채널이 고정되어 있다고 가정합니다. TREX는 측정을 의도적으로 무작위화하므로 M3가 사용하는 가정이 성립하지 않게 됩니다. 이런 의미에서 두 기법을 단순히 결합할 수는 없습니다. 하지만 M3에 사용되는 보정 과정에서 측정 트월링(twirling)을 적용하면, 할당 행렬과 유사한 접근법과 트월링 완화 접근법을 동시에 활용할 수 있을 수도 있습니다(다만 이 트월링 접근법은 TREX와 완전히 같지는 않습니다). 이는 완화 기법과 억제 기법을 결합할 때 반복해서 나타나는 주제입니다. 기법을 무작정 더하면 실패하지만, 서로를 "인식"하도록 신중하게 더하면 효과가 있고 매우 유익할 수 있습니다.
TREX는 판독 오류로 인한 편향이 없는 기댓값만을 보장합니다. 분산을 줄여 주지도 않고, 다른 종류의 편향을 막아 주지도 않습니다. 모든 오류를 보정하는 것도 분명 아닙니다. 하지만 대개 상당한 개선을 가져오며, 전체 노이즈 모델을 학습해야 하는 다른 방법보다 훨씬 낮은 오버헤드로 달성할 수 있습니다. TREX는 흔히 사용 가능한 판독 완화 기법 중 비용이 가장 낮고 가장 견고하므로, 실험에서 기본값으로 쓰기에 훌륭합니다.
Qiskit에서의 TREX
여기서는 간단한 2큐비트 회로를 만들고, Estimator를 사용해 매우 단순한 관측량 ZX의 기댓값을 추정합니다. 이상적인 기댓값은 1입니다. TREX를 사용한 경우와 사용하지 않은 경우의 기댓값을 비교해 보겠습니다.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
간단한 양자 회로를 만듭니다.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

패스 매니저를 사용해 회로를 트랜spile합니다.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
트랜스파일 과정에서 얻은 레이아웃을 관측량에도 동일하게 적용합니다.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
실제 양자 컴퓨터에서 실험을 실행합니다. 먼저 reslience_level = 1로 진행합니다. 이것이 기본값이지만, 두 경우를 구분하기 위해 명시적으로 지정했습니다.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
이제 resilience_level을 0으로 설정해 TREX 없이 실행합니다.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
예상대로 TREX를 사용했을 때 기댓값이 이상적인 값(1)에 훨씬 가깝습니다. 물론 이것은 단일 큐비트에 대한 하나의 기댓값이었습니다. 이제 비클리퍼드 게이트와 많은 큐비트를 사용하는 회로를 준비하여, TREX의 개선 효과가 다른 환경에서도 견고하게 유지되는지 확인해 보겠습니다.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
여기서 회전각 에는 특별한 의미가 없습니다. 비대칭적인 오류 전이의 영향과 TREX가 이를 어떻게 처리하는지 살펴보기 위해, 과 이 동일하지 않게 중첩된 임의의 상태를 골랐을 뿐입니다. 이 상태에서 (판독 오류든 다른 오류든) 어떤 오류도 없을 때 모든 큐비트에서 Z의 이상적인 기댓값은 다음과 같습니다.
따라서 모든 큐비트에서 -0.924에 가까운 기댓값을 얻기를 기대합니다. TREX가 각 기댓값을 개별적으로 개선하는지, 그리고 모든 큐비트에 대한 평균도 개선하는지 확인해 보겠습니다.
이해도 확인
위의 기댓값을 직접 계산으로 확인해 보세요.
정답
패스 매니저를 사용해 트랜스파일합니다.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
이제 단일 워크플로에서 스무 개의 기댓값을 모두 추정할 수 있도록 큐비트마다 관측량을 하나씩 구성합니다. 즉, 큐비트에 대해 위치만 이고 나머지는 모두 항등 연산 인 관측량을 만들어야 합니다. 트랜스파일된 레이아웃을 관측량에도 적용해야 한다는 점을 잊지 마세요.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
이제 실행할 수 있습니다. 아래 코드 셀은 session mode를 사용합니다. 세션에 접근할 수 없다면 batch mode로 바꿔 같은 워크플로를 실행할 수 있지만, 회로 사이에 대기열 대기 시간이 생길 수 있습니다.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
여기서는 TREX를 사용한 경우와 사용하지 않은 경우의 평균 절대 오차를 비교합니다.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
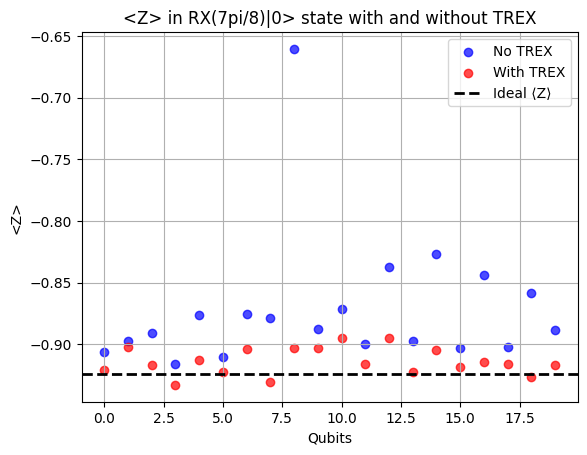
TREX가 분명히 도움이 된 것으로 보입니다. 16번 큐비트를 제외한 모든 큐비트의 기댓값이 개선되었습니다. 이러한 이상치는 충분히 예상할 수 있습니다. 평균값을 구하면 이 회로에 대한 TREX 적용의 전반적인 효과를 정량화할 수 있습니다.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
평균적으로 TREX는 결과를 이상적인 결과에 약 2.9% 더 가깝게 만들었고, 결과적으로 이론적 이상값과의 평균 차이는 불과 0.4%였습니다. 훌륭한 결과이며, 이처럼 오버헤드가 낮은 개선이 바로 TREX가 Estimator의 기본 오류 완화 기법인 이유입니다. 그러나 TREX는 모든 오류를 보정하는 것이 아니라 판독 오류의 편향을 제거하는 것이라는 점을 다시 한번 강조해야 합니다. 여기서는 판독 비대칭의 영향을 받을 가능성이 높은 초기 상태를 선택했습니다. 각 큐비트를 다른 상태로 준비했다면 효과도 달랐을 것입니다. 이것이 당연한 이유를 간단히 설명하자면, 각 큐비트를 바닥 상태 로 그대로 두었다고 생각해 보세요. 상태와 상태 사이의 판독 오류 비대칭을 관찰할 (또는 보정할) 기회가 전혀 없을 것입니다.
영 잡음 외삽법(ZNE)
영 잡음 외삽법(ZNE)은 가장 널리 사용되는 오류 완화 기법 중 하나입니다. 구현의 세부 사항은 복잡하지만 전반적인 전략은 이해하기 쉽습니다. ZNE는 다음과 같이 동작합니다.
-
대상 회로를 여러 "노이즈 수준"에서 실행합니다. 노이즈 수준이란 회로의 노이즈가 예측 가능한 방식으로 증가하도록 회로를 수정한 것입니다 —
-
각 노이즈 배율에 대해 관심 있는 관측량을 추정합니다.
-
피팅 모델(선형, 다항식, 지수 등)을 사용해 노이즈가 0인 지점으로 외삽합니다.
그 결과는 외삽 모델이 암시하는 영 잡음 극한에서 관측량이 어떤 값이었을지에 대한 추정치입니다.
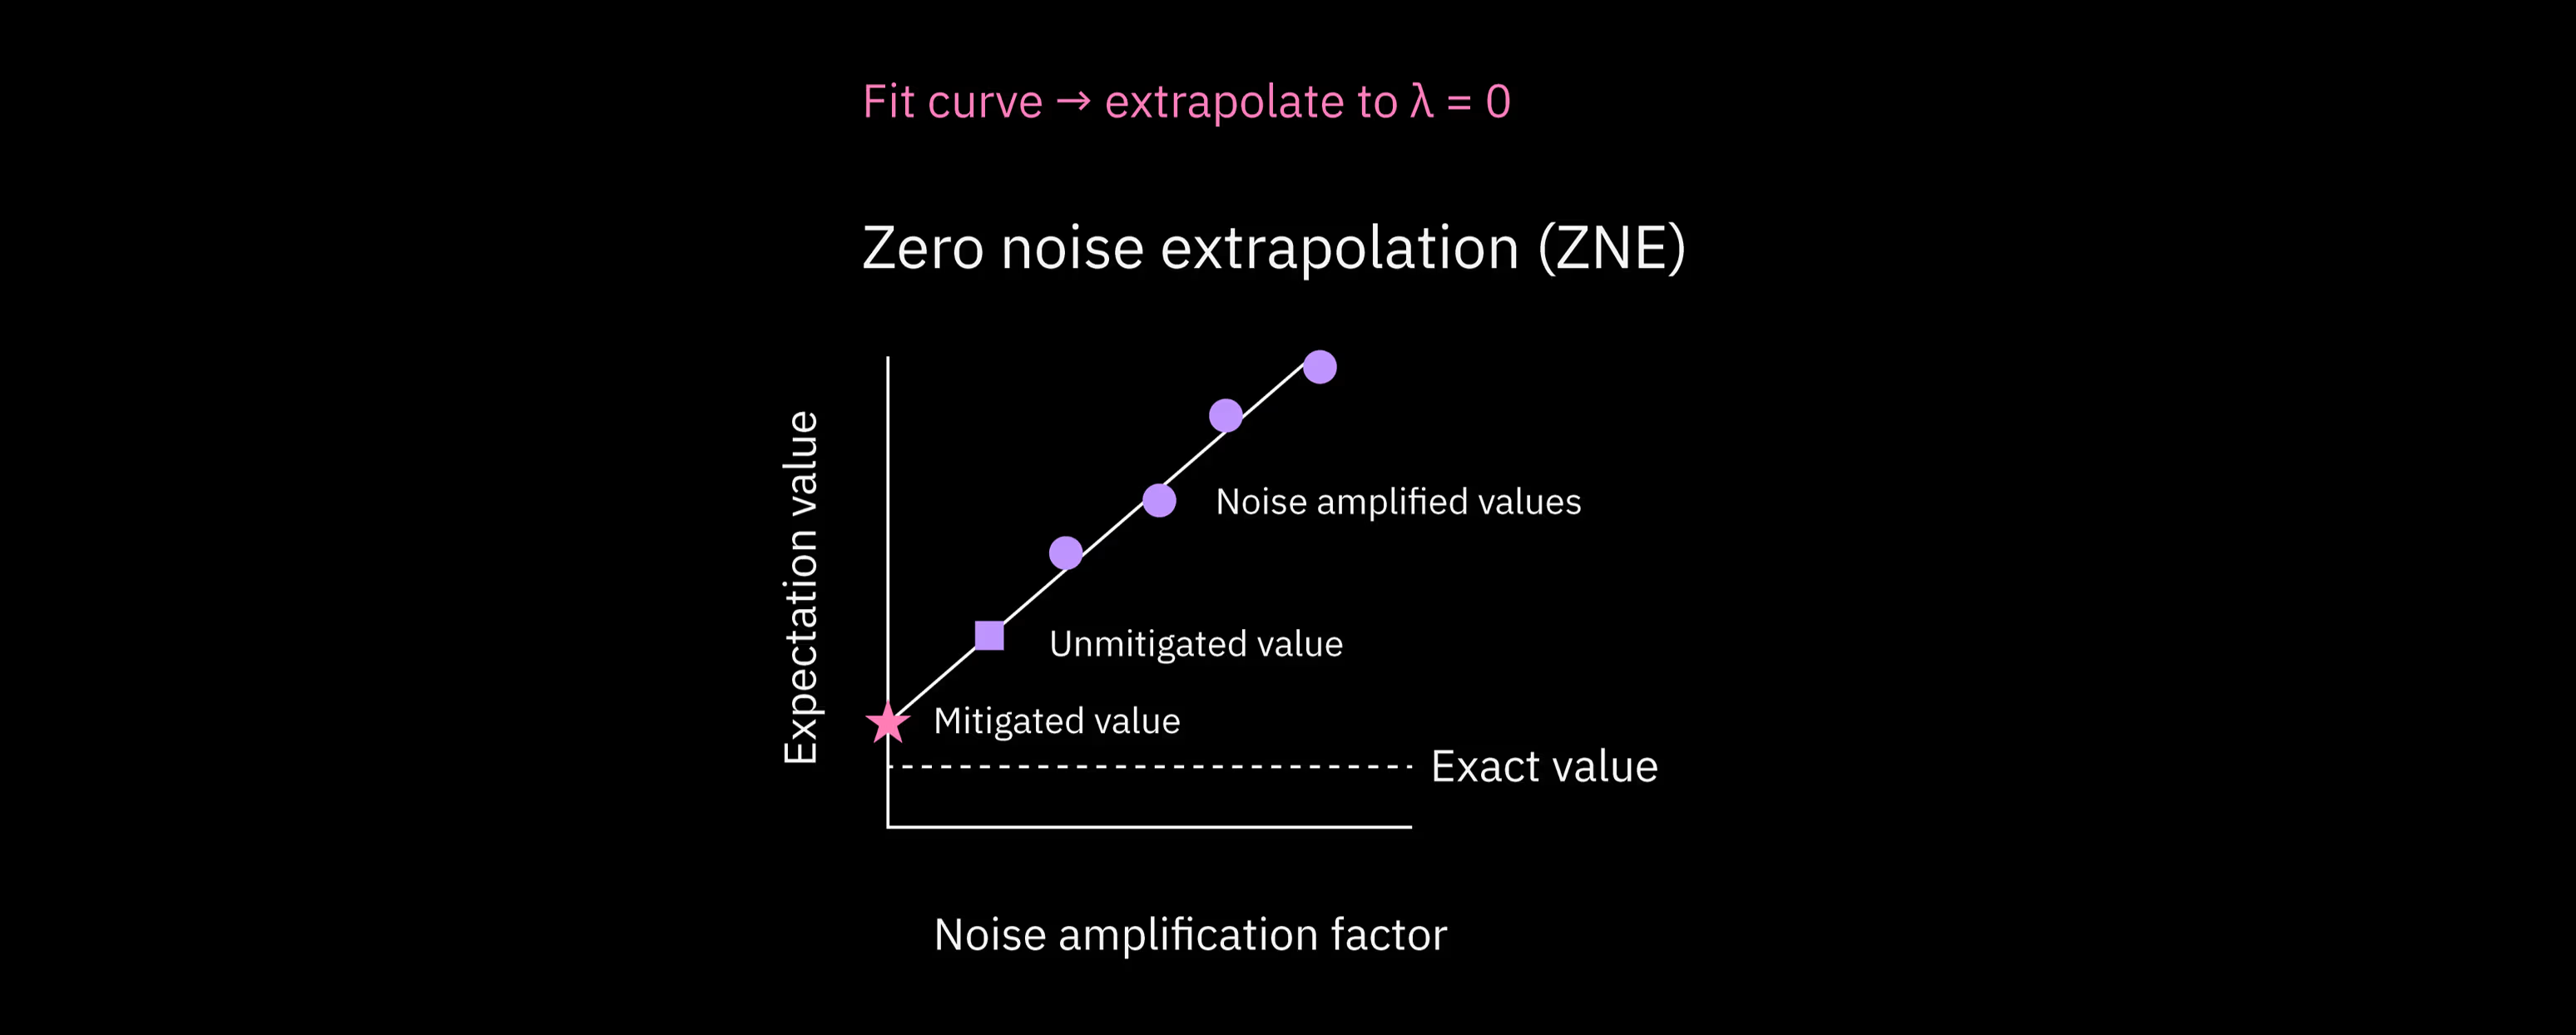
ZNE는 회로를 수정함에 따라 노이즈가 매끄럽게 또는 선형적으로 증가한다고 보장하지 않습니다. 대신 노이즈 배율이 외삽을 허용할 만큼 충분히 양호하게 동작한다고 가정합니다. ZNE의 복잡성은 이 가정을 최대한 잘 만족하도록 회로를 수정하는 방법에 있습니다. 이 수업에서 몇 가지 접근법을 살펴보겠습니다.
ZNE의 자원 스케일링
ZNE에서 오버헤드는 대부분 양자 오버헤드입니다. 즉, 개의 노이즈 수준에서 기댓값을 얻으려면 개의 회로에서 각각 많은 샷으로 실험을 수행해야 합니다. 통계적 정밀도를 일정하게 유지하려면, 노이즈가 조정된 회로가 추가될수록 전체 샘플 수는 일반적으로 늘어납니다.
살펴볼 노이즈 수준의 개수 는 노이즈를 조정하는 방법에 따라 달라집니다. 단순한 노이즈 조정 기법 하나(아래에서 설명할 "게이트 폴딩")의 경우, 는 보통 3에서 5 사이입니다. 다른 방법인 확률적 노이즈 증폭(PNA)은 정수가 아닌 노이즈 배율을 허용하며, 일반적으로 게이트 폴딩보다 낮은 노이즈 수준을 만들어 냅니다. 전체 오버헤드는 대략 다음과 같이 증가합니다.
여기서 는 기준 샷 수입니다. 또 하나 염두에 둘 점은, 노이즈 조정에 게이트 반복이 포함되면 회로 깊이가 노이즈 조정 값에 비례하는 배수만큼 늘어날 수 있다는 것입니다. 깊이 증가에 따라 노이즈가 커지는 것이 목적이지만, 전체 깊이는 염두에 두어야 합니다.
ZNE는 다음 사항이 해당되는 문제에 잘 맞습니다.
-
여러 유형의 오류에 효과적인 범용 완화 방법이 필요합니다.
-
회로 깊이가 너무 크지 않습니다. 조정된 회로가 외삽하기에 너무 노이즈가 많아지면 ZNE는 실패합니다.
-
정확도를 높이기 위해 어느 정도의 실행 시간 오버헤드를 감수할 수 있습니다.
실제로 이 때문에 ZNE는 많은 변분 회로, 기댓값 추정, 그리고 기타 근미래 양자 알고리즘에 이상적입니다. ZNE는 Estimator에서 resilience_level = 2를 사용하여 구현됩니다. ZNE는 회로 전반의 노이즈에 대한 함수로서 단일 결과를 갖는 공간에서 외삽한다는 점에 유의하세요. 즉, 추정 문제에는 적합하지만 샘플링 문제에는 적합하지 않습니다. 비트열의 분포에 대해 동작하도록 설계되지 않았습니다.
노이즈 배율
회로의 노이즈 수준을 정확히 어떻게 높일 수 있을까요? 다양한 변형이 있지만 주된 방법은 두 가지입니다.
-
게이트 또는 게이트 블록 를 로 대체합니다. 양자 컴퓨터의 게이트는 유니터리이므로 임을 알 수 있고, 따라서 논리적으로 입니다. 하지만 또는 를 반복할 때마다 비슷하거나 동일한 오류가 추가되므로 노이즈/오류 수준을 키울 수 있습니다. 위의 대체는 게이트 의 원래 노이즈(노이즈 수준 1)에서 의 세 배 노이즈 수준(노이즈 수준 3)으로 올라간다는 점에 유의하세요. 실제로는 마지막 두 게이트를 번 반복하여 로 노이즈 수준 을 얻을 수 있습니다. 이를 게이트 폴딩이라 하며, 매우 일반적인 노이즈 조정 기법입니다.
-
확률적 오류 증폭(PEA)과 같이 노이즈 수준을 높이는 다른 방법도 있습니다. PEA에서는 먼저 회로에 적합한 노이즈 모델을 학습하며, 이는 보통 파울리 채널로 표현됩니다. 그런 다음 학습된 이 노이즈 채널의 배율을 조정한 버전에서 샘플링하여 노이즈를 증폭합니다. 샘플링을 조정하면 정수가 아닌 값을 포함해 유효 노이즈 강도를 연속적으로 조정할 수 있습니다.
실제로 게이트 폴딩은 오류를 매우 안정적으로 조정할 수 있지만, 회로가 매우 깊어질 수도 있습니다. 노이즈 수준이 세 개(1, 3, 5)만 필요하더라도 회로 깊이를 5배로 늘리면서 합리적인 결과를 얻어야 한다는 뜻입니다. 따라서 대상 회로의 트랜스파일된 2큐비트 깊이가 60 이상이라면, 게이트 폴딩보다 PEA가 더 적합할 가능성이 높습니다.
게이트는 국소적으로 폴딩할 수 있고(즉, 2큐비트 게이트가 나타나는 즉시 각각에 대해 를 반복), 게이트 블록으로 묶어 그 블록을 반복할 수도 있습니다(예: 게이트 ). ZNE의 가정에는 대개 국소 폴딩이 더 바람직하지만, 둘 다 가능합니다.
ZNE에서 노이즈가 조정된 결과를 통계적으로 처리하는 데는 많은 미묘한 점이 있습니다. 예를 들어 노이즈 수준이 다섯 배일 때 결과는 분산이 더 크고 신뢰도가 낮을 것이 확실합니다. 이를 노이즈가 더 낮은 데이터 포인트와 같은 가중치로 다뤄야 할까요? 아니요. 하지만 ZNE가 동작하는 모습을 보여 주기 위해, 간단한 모의 실험에서는 이러한 복잡성 중 일부를 무시하겠습니다. 이 실험에서는 폴딩된 회로를 직접 만들고, 핵심 단계를 보여 주기 위해 동일한 가중치로 단순하게 외삽합니다. 그런 다음 Qiskit에 내장된 ZNE 기능을 사용한 실험을 이어서 진행하고, 우리가 건너뛴 복잡성을 훨씬 더 잘 처리한다는 것을 확인하겠습니다.
직접 수행하는 ZNE
먼저 노이즈와 오류가 없을 때의 이상적인 기댓값을 계산할 수 있는 양자 회로와 관측량을 선택합니다. 큐비트 수가 짝수인 GHZ 상태 를 선택하고, 관측량은 으로 합니다. 여러 이유로 이것을 선택했습니다.
- 이상적인 경우 기댓값 은 계산하기 쉽습니다. 큐비트 수가 짝수이므로, 모든 에서
1이 나와 곱해지거나, 모든 에서-1이 나와 짝수 번 곱해집니다. - 한 큐비트에서 오류가 하나만 생겨도 해당 샷의 전체 결과가 +1에서 -1로 뒤집힐 수 있으므로, 오류와 노이즈에 상당히 민감합니다.
- 기댓값이 0과 멀리 떨어져 있습니다. 이상적인 기댓값이 0에 매우 가까우면 ZNE에 어려움이 생길 수 있습니다. 높은 노이즈 수준에서는 결과가 무작위화되어 양수와 음수가 비슷한 빈도로 나오기 때문입니다. 그 결과 높은 노이즈 값에서도 이상적인 값에 가까운 값이 나오게 되어 외삽이 매우 까다로워질 수 있습니다.
이러한 동기를 염두에 두고 회로를 만들어 보겠습니다.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
여기서는 라는 미묘한 점에 유의하세요. 게이트 폴딩이 형태의 연산자로 이루어진다고 설명했지만, 여기서는 같은 구조가 CNOT CNOT CNOT으로 보입니다.
회로가 실제로 일반적인 GHZ 회로인지 확인해 보겠습니다.
ghz_amp[0].draw("mpl")
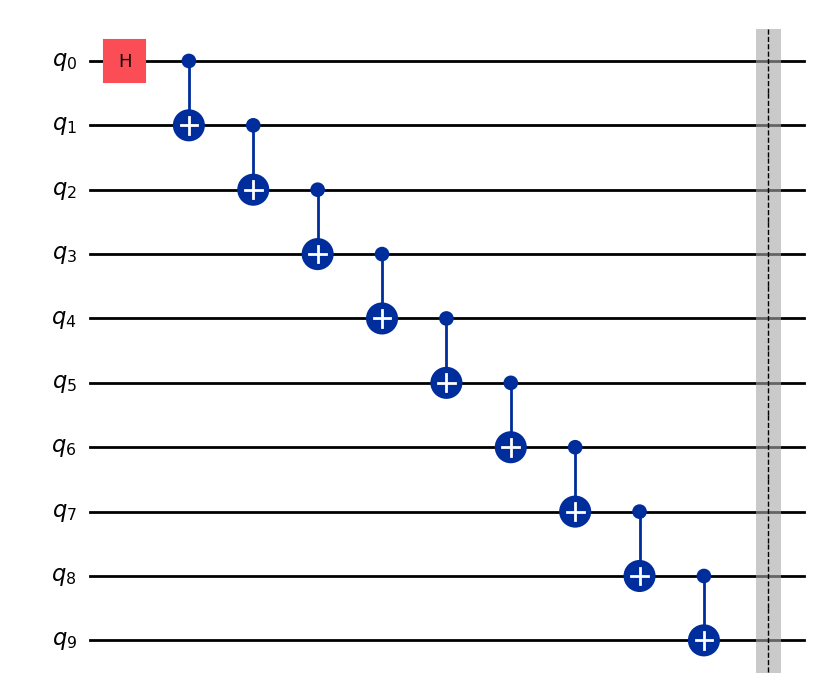
다른 회로들도 살펴보면서 예상한 구조인지 확인해 볼 수 있습니다.
이제 관측량을 만듭니다.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
패스 매니저를 만들어 회로에 적용합니다. 그런 다음 레이아웃을 가져와 관측량에 적용합니다.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
pubs를 구성합니다.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
이제 Estimator를 실행합니다. ZNE의 역할에 집중하고 싶으므로, 트월링의 효과와 ZNE의 효과가 뒤섞이지 않도록 resilience_level = 0으로 설정하는 편이 좋을 수 있습니다. 하지만 트월링을 포함하는 Qiskit 내장 ZNE 설정과 우리의 "직접 수행하는" ZNE를 비교하고 싶기도 합니다. 따라서 여기서는 resilience_level = 1로 설정합니다. resilience_level = 2로 설정하면 Qiskit ZNE 설정이 호출되며, 곧 이를 사용할 것입니다.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
이제 노이즈 수준과 기댓값을 출력합니다.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
이 부분이 가장 무심하게 진행하는 부분입니다. 얻은 각 값의 분산에는 전혀 주의를 기울이지 않고, 피팅이 선형이어야 하는지 이론적으로 예측하려는 시도도 하지 않은 채 이 데이터에 선형 피팅을 수행합니다. 다시 말하지만 내장 ZNE는 우리가 직접 하는 것보다 훨씬 더 잘 처리합니다.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
해석에 앞서 먼저 그래프를 그려 봅니다.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
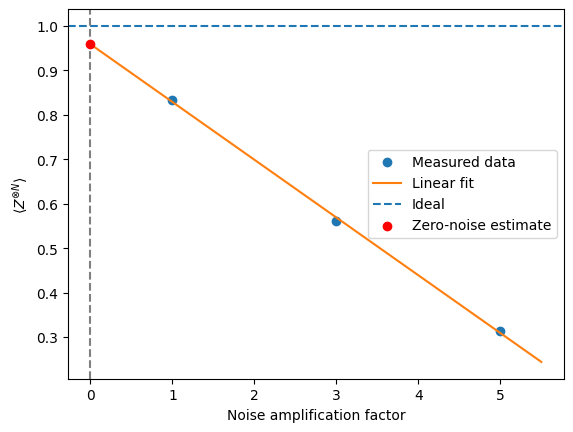
이 수업을 만들 당시, 영 잡음 경우로 외삽하여 얻은 기댓값은 0.959였습니다. 여러분의 값은 다를 수 있습니다. 이는 원본 회로의 기댓값 0.83보다 상당히 개선된 값으로, 이상적인 값에 약 13% 더 가깝습니다. 하지만 기댓값이 0.31까지 내려간 데이터 포인트 하나를 사용하고 있다는 점도 볼 수 있습니다. 이 데이터 포인트는 분명히 품질이 더 낮습니다. 선형 근사에서 이 데이터 포인트에 더 낮은 가중치를 주고 직선을 처음 두 데이터 포인트에 더 맞추었다면, 영 잡음으로 외삽한 추정치가 더 높았을 것(이상적인 값에 더 가까웠을 것)임을 알 수 있습니다. 이러한 고려는 Estimator에 내장된 ZNE에서 자동으로 처리됩니다.
Estimator에 내장된 ZNE
이제 Estimator에 내장된 ZNE 기능을 사용하면 어떻게 되는지 살펴보겠습니다. 게이트 폴딩이 없는 간단한 GHZ 회로를 정의하는 것으로 시작합니다.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
앞에서와 같은 관측량을 정의합니다.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
optimization_level = 1을 사용하여 패스 매니저를 다시 정의합니다. 이 선택에 대해서는 아래에서 다시 다루겠습니다.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
회로를 트랜스파일하고 레이아웃을 관측량에 적용합니다.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
ZNE와 트월링을 사용해 Estimator를 실행하고, 그 결과를 직접 구현한 ZNE와 비교합니다. 특히 ZNE를 사용하지 않은 결과(value_no_zne)와 비교합니다.
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
job_zne.result()[0].data.evs_noise_factors 구문을 사용해 각 노이즈 배율에서의 값을 가져올 수 있습니다. 앞에서처럼 이 결과로 단순하게 선형 피팅을 하여 영 잡음 경우로 외삽할 수도 있지만, resilience_level = 2인 Estimator는 분산과 기타 고려 사항을 반영하여 이미 더 나은 결과를 냈습니다. 아래에서는 선형 외삽이 어떤 결과를 내는지와 내장 ZNE가 실제로 낸 결과를 함께 보여 줍니다.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
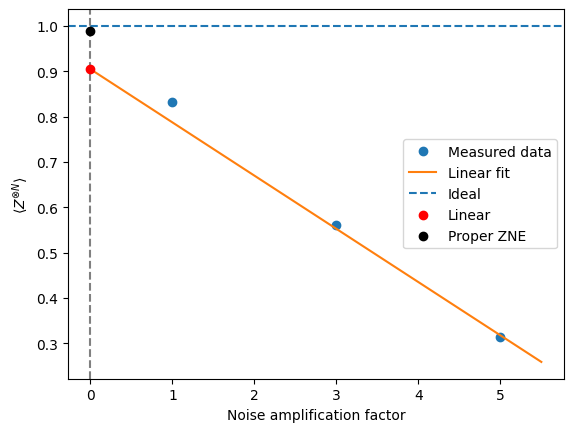
내장 ZNE가 추정치를 15% 넘게 개선했고, 직접 수행한 시도보다 상당히 더 잘 동작했음을 알 수 있습니다.
넘어가기 전에, 이 ZNE 탐구 내내 패스 매니저에서 optimization_level = 1로 설정했다는 점에 유의하세요. 최적화 수준이 높을수록 오류가 줄어들지만, 때로는 오류 감소 때문에 오류가 덜 예측 가능하게 증가할 수 있습니다. 흔히 그렇듯 균형이 필요합니다. 오류를 줄이되, 알려진 배율로 의도적으로 늘리는 경우는 예외입니다.
방법 결합하기
ZNE는 다음에 의존합니다.
-
명확하게 정의된 노이즈 조정 매개변수
-
에 따라 기댓값이 충분히 매끄럽고 예측 가능하게 변화함
-
세기만 다른 동일한 유효 노이즈 채널
-
에 따라 변하지 않는 편향이 도입되지 않음
ZNE는 변하지 않는 편향을 제거하는 기법(M3 등)이나 노이즈를 더 규칙적으로 만드는 기법(트월링 등)과는 깔끔하게 결합되지만, 노이즈를 완전히 상쇄하려는 기법(PEC)이나 노이즈를 동적으로 재구성하는 기법(DD)과는 충돌합니다.
특히 M3는 측정/판독 오류만 다루며, 실제로 이는 게이트 오류(ZNE의 오류 조정 과정이 초점을 두는 대상)와 별개로 취급할 수 있습니다. M3는 게이트 폴딩과 대체로 무관하므로 ZNE와 깔끔하게 결합할 수 있습니다. TREX도 매우 비슷하며 ZNE와 결합할 수 있습니다.
파울리 트월링은 M3나 TREX와 달리 게이트에 초점을 둡니다. 하지만 파울리 트월링은 오류/노이즈를 직접 완화하는 것이 아니라, 더 예측 가능하도록 바꾸는 것임을 기억하세요. 파울리 트월링은 게이트 오류가 더 선형적으로 증가하게 하여 외삽을 더 정확하게 만든다는 점에서 ZNE 과정에 실제로 도움이 될 수 있습니다.
동적 디커플링(DD)은 좀 더 미묘합니다. DD는 게이트 시퀀스를 추가하여 특정 오류를 부분적으로 상쇄함으로써 노이즈 동작을 동적으로 바꿉니다. 게이트나 블록이 폴딩되어도 DD가 똑같이 동작하도록 회로를 구성할 수 있다면 원칙적으로 ZNE와 DD를 결합할 수 있지만, 실제로는 DD가 배율 조정을 방해하는 경우가 있습니다. 둘을 결합하려면 다음 사항을 고려해야 합니다.
- 모든 노이즈 수준에서 DD가 일관되게 적용되는가?
- 폴딩이 DD 구조를 보존하는가?
- 그 결과 노이즈 배율이 여전히 단조롭게 동작하는가?
독립적인 접근법으로 논의할 마지막 오류 완화 방법은 ZNE와 호환되지 않습니다. 바로 확률적 오류 상쇄입니다.
확률적 오류 상쇄(PEC)
ZNE나 측정 완화와 달리, PEC는 기댓값 차원에서 이상적인 채널을 재구성하여 게이트 수준에서 노이즈를 상쇄하려고 합니다. 확률적 오류 상쇄(PEC)는 이 수업에서 다루는 오류 완화 기법 중 가장 강력하고 가장 비용이 많이 드는 기법입니다. PEC는 노이즈 채널의 명시적 역변환을 중심으로 구성되며, 이 역변환은 물리적으로 수행되는 것이 아니라 통계적으로 수행됩니다. PEC는 다음과 같이 동작합니다.
-
"오류 연산"의 기저로 노이즈 모델을 특성화합니다.
-
노이즈 채널의 역을 물리적 연산에 대한 준확률 분포로 표현합니다.
-
회로를 실행하는 동안 이 분포에서 샘플링하여, 이상적인 계산에 대한 비편향 추정치를 통계적으로 구성합니다.
개념적으로 PEC는 가상의 오류 정정과 같습니다 — 노이즈가 있는 연산을 신중하게 가중치를 준 무작위 패턴으로 결합하여 노이즈를 "되돌립니다". 하지만 절차적으로 PEC는 오류 정정이나 오류 검출 코드와 밀접한 관련이 없습니다. 이상적이고 노이즈가 없는 기댓값에 대한 PEC의 비편향 추정은 매우 큰 샘플링 오버헤드와 정확한 노이즈 특성화에 대한 강한 의존이라는 대가를 치릅니다.
IBM 양자 컴퓨터에서 PEC는 범용 완화 계층이라기보다 정밀 도구로 보는 것이 가장 적절합니다. 작은 회로나 더 큰 회로의 일부 작은 부분, 벤치마킹 작업, 그리고 높은 양자 오버헤드를 감수할 수 있는 고정밀 연구에 가장 적합합니다.
노이즈 채널 특성화
PEC에서는 양자 회로의 각 이상적인 게이트를 이상적인 유니터리 채널과 그 뒤를 잇는 노이즈 과정으로 모델링합니다. 를 양자 상태의 밀도 행렬이라고 하겠습니다. 이상적인 게이트는 유니터리 행렬 로 표현되며, 이는 다음과 같은 양자 채널을 유도합니다.
실제 하드웨어에서는 이 이상적인 time 발전이 노이즈로 인해 손상됩니다. 게이트의 물리적 구현을 유효 노이즈 채널로 모델링합니다.
여기서 은 게이트와 관련된 확률적 오류를 나타내는 노이즈 채널입니다. 이 논의 전반에서 , , 는 밀도 연산자에 작용하는 선형 사상입니다. 이상적인 채널 는 유니터리이며 가역적인 반면, 노이즈 채널 (따라서 도)은 완전 양의 대각합 보존(CPTP) 사상입니다.
PEC는 노이즈 채널 을 알고 있거나 대략적으로 알고 있다고 가정합니다. IBM Quantum 하드웨어에서 이 정보는 일반적으로 장치 보정 데이터, 벤치마킹 실험에서 추론한 오류율, 그리고 작은 게이트 집합에 대한 파울리 또는 탈분극 근사와 같은 단순화된 노이즈 모델에서 얻습니다. PEC는 완벽하게 정확한 노이즈 모델을 요구하지는 않지만, 가정한 노이즈 채널이 실제 하드웨어 동작과 달라질수록 성능이 급격히 저하됩니다.
역 노이즈 채널의 준확률 분해
PEC의 핵심 아이디어는 노이즈 채널의 역에 대한 확률적 근사를 구성하여 기댓값 차원에서 노이즈의 영향을 상쇄하는 것입니다. 형식적으로 목표는 을 대략적으로 되돌리는 선형 사상을 적용하여 다음이 성립하게 하는 것입니다.
이는 많은 회로 실행에 대한 기댓값에서 성립합니다.
여기서 역변환 은 연산자에 작용하는 선형 초연산자로 취급한 의 대수적 역으로 정의됩니다. 이 역은 이 최대 계수(full-rank)일 때만 존재하며, 역이 존재하지 않는 노이즈 과정은 PEC로 정확하게 완화할 수 없습니다.
역변환이 가능할 때 PEC는 역 노이즈 채널을 물리적으로 구현 가능한 연산들의 선형 결합으로 표현합니다.
여기서 각 는 하드웨어에서 실행할 수 있는 노이즈가 있는 연산(보통 네이티브 게이트나 짧은 게이트 시퀀스)이며, 실수 계수 는 준확률 분포를 이룹니다. 일반적인 확률과 달리 계수 는 음수이거나 1을 초과할 수 있습니다.
준확률 노름:
은 노이즈 역변환의 비용을 정량화합니다. 자명하지 않은 모든 노이즈 채널에서 입니다. IBM Quantum 하드웨어에서 이 분해는 일반적으로 다음과 같이 수행됩니다.
- 게이트별 또는 작은 게이트 집합별로,
- 제한된 노이즈 모델(주로 파울리 대각 근사)을 가정하여,
- 백엔드별 네이티브 연산과 스케줄링 제약을 사용하여.
이상적인 회로의 몬테카를로 재구성
관측량 의 기댓값을 추정하기 위해 PEC는 위의 분해를 바탕으로 몬테카를로 샘플링을 사용합니다. 회로에서 노이즈가 있는 게이트가 나타날 때마다 다음 절차를 적용합니다.
-
다음 확률로 연산 를 무작위로 선택합니다.
-
고전적 가중치를 부여합니다.
-
그렇게 만들어진 무작위화된 노이즈 회로를 양자 백엔드에서 실행합니다.
-
측정된 결과에 누적된 모든 가중치의 곱을 곱합니다.
-
많은 회로 실행에 걸쳐 가중 결과를 평균합니다.
결과로 얻은 추정량 는 다음을 만족합니다.
단, 노이즈 모델 이 하드웨어를 정확하게 기술한다는 조건이 필요합니다. 따라서 PEC는 기댓값에서 체계적 편향이 없지만, 편향을 큰 통계적 분산으로 대체합니다. 각 실행은 노이즈가 있지만 가중치가 부여된 추정치를 만들며, 이러한 실행을 많이 평균한 후에야 이상적인 기댓값이 나타납니다.
개념적 해석
PEC는 때때로 가상 오류 정정이라고 설명됩니다. 이 표현이 전적으로 틀린 것은 아니지만, 진정한 양자 오류 정정과 혼동해서는 안 됩니다. PEC에는 논리적 인코딩도, 신드롬 추출도, 실시간 피드백도 없습니다. 회로를 실행하는 동안 오류는 예방되거나 정정되지 않습니다.
대신 PEC는 노이즈가 있는 여러 회로 실현을 부호 있는 고전적 가중치와 결합하여, 고전적 후처리 이후에야 오류가 상쇄되도록 통계적으로 노이즈를 상쇄합니다. 실행 중에는 정보가 보호되지 않으며, 이상적인 결과는 사후에 재구성됩니다.
자원 스케일링과 비용
PEC의 주된 비용은 분산 증폭에서 비롯됩니다. PEC 추정량의 분산은 다음과 같이 증가합니다.
이는 다음을 의미합니다.
이 스케일링은 근본적인 것이며 고전적 후처리로는 개선할 수 없습니다.
노이즈가 있는 게이트가 많은 회로에서는 각 게이트가 인수 을 더하여, 전체 준확률 노름이 대략 곱셈적으로 증가합니다.
여기서 는 회로 깊이입니다. IBM Quantum 하드웨어에서는 이로 인해 일반적으로 회로 깊이에 따라 샘플링 비용이 지수적으로 증가하며, 특히 2큐비트 게이트 오류에 매우 민감합니다. 이러한 스케일링은 PEC의 실용적 적용 가능성에 한계를 둡니다.
PEC는 현재 다음 조건 중 하나 이상 또는 모두가 충족될 때만 실용적입니다.
-
회로가 매우 작거나 얕습니다(보통 개 게이트).
-
노이즈 모델이 단순하고 충분히 검증되어 있습니다(예: 파울리 노이즈).
-
높은 통계적 비용을 감수할 수 있습니다.
-
목표가 처리량이 아니라 정확도입니다.
이러한 이유로 PEC는 흔히 다음에 적용됩니다.
-
더 큰 워크플로 내의 독립된 부분 회로,
-
짧은 시간 발전 단계,
-
상태 준비 또는 측정 루틴,
-
벤치마킹 및 검증 실험.
IBM 소프트웨어 스택(IBM Quantum 컴퓨트 및 오류 완화 도구)은 PEC를 기본 완화 계층이 아닌 특화된 옵션으로 취급함으로써 이를 반영합니다.
일반적인 PEC 사용 사례는 다음과 같습니다.
-
양자 하드웨어의 정밀 벤치마킹,
-
소규모 양자 알고리즘의 검증,
-
축소된 시스템에 대한 고정밀 양자 화학 계산,
-
ZNE 또는 다른 완화 방법의 교차 검증.
PEC와 다른 완화 방법의 관계
다른 많은 완화 기법은 확장성을 위해 정확도를 희생하지만, PEC는 정반대로 무엇보다 정확도에 집중합니다.
PEC는 부분 회로에만 사용될 수도 있으므로, 어떤 다른 완화 방법과 함께 사용할 수 있는지 묻는 것이 특히 중요합니다. PEC와의 호환성을 명확하게 따져 보려면, 기법이 노이즈에 어떤 작용을 하는지에 따라 분류하는 것이 도움이 됩니다. 다음과 같은 일반적인 범주를 생각해 보세요.
-
노이즈 상쇄 - 오류 채널을 역변환하려고 시도합니다
-
노이즈 스케일링 - 외삽을 위해 의도적으로 노이즈를 증가시킵니다
-
노이즈 재구성 - 노이즈의 구조나 스펙트럼을 변경합니다
-
편향 제거 - 게이트 노이즈에 비례하여 증가하지 않는 오류를 보정합니다
PEC는 정확히 범주 (1)에 속합니다. 노이즈 채널을 변경하거나 재조정하는 모든 방법은 신중하게 검토해야 합니다.
요약 표 (상위 수준)
| 기법 | PEC와 호환 여부 | 참고 |
|---|---|---|
| ZNE | 아니요 | 오류를 되돌리는 것과 스케일링하는 것, 그리고 때로는 오류를 맞춤 조정하는 것의 차이 |
| Pauli twirling | 예 (주의 필요) | 오류 동작에 영향을 주지만 학습을 더 쉽게 만들 수 있음 |
| TREX | 예 | 워크플로에서 겹치는 부분이 없습니다. 완전히 호환됩니다. |
| Dynamical decoupling | 대체로 아니요 | 오류 채널을 변경함 |
PEC와 ZNE는 동일한 오류 원인(게이트 오류)을 다루지만, 서로 양립할 수 없는 가정이나 작업 흐름(또는 둘 다)을 사용합니다. 예를 들어 ZNE에서는 오류를 매개변수 로 전개할 수 있다고 가정합니다.
그리고 이 전개를 모델링하기 위해 오류를 효과적으로 스케일링할 수 있다고 가정합니다. PEC는 스케일링에 의존하는 바로 그 오류를 없애 버립니다. 그러면 매개변수 는 의미가 없어집니다. 다른 방식으로 생각해 보면 다음과 같습니다.
-
PEC보다 먼저 ZNE를 적용하면 역변환하려는 노이즈 채널이 바뀝니다.
-
ZNE보다 먼저 PEC를 적용하면 ZNE가 외삽에 의존하는 바로 그 노이즈가 제거됩니다.
PEC와 ZNE는 조합 가능한 계층이 아니라 서로 대안이 되는 오류 완화 패러다임으로 간주해야 합니다. 둘을 나란히 비교하는 것은 유익하지만, 결합하는 것은 그렇지 않습니다.
PEC와 Pauli twirling은 일반적으로 호환되며 종종 도움이 됩니다. Twirling은 코히런트 오류를 확률적 Pauli 오류로 변환하므로 PEC에 도움이 될 수 있습니다. 이는 노이즈 채널을 단순화하여 표현하고 역변환하기 쉽게 만듭니다. PEC에게 이는 다음과 같은 이유로 매우 가치 있습니다.
-
Pauli 채널의 경우 준확률 분해가 훨씬 단순합니다
-
준확률 노름 가 대개 상당히 더 작습니다
-
샘플링 분산이 감소합니다
많은 PEC 시연은 Pauli-twirled 노이즈를 가정하거나 내장하고 있습니다. Pauli twirling이 그 자체로 오류를 완화하는 것은 아니며, 확률적 오류 상쇄가 더 효율적으로 처리할 수 있는 형태로 노이즈를 재구성한다는 점을 분명히 하는 것이 중요합니다.
PEC는 TREX와 결합할 수 있으며 결합해야 합니다. 이 두 접근법은 완전히 호환되며 서로 직교하는 역할을 합니다. TREX는 측정 단계에서만 작동하고, 측정 채널의 무작위 twirl을 통해 판독 편향을 제거하며, 게이트 노이즈나 회로 동역학에는 영향을 주지 않습니다. PEC는 게이트 노이즈를 대상으로 합니다. 측정 오류는 합성적이 아니라 가산적이므로 게이트 시퀀스와 무관합니다. PEC와 함께 TREX를 적용하는 것은 안전하며 종종 바람직합니다.
이 방법들의 적용 순서는 예상하시는 대로입니다.
- PEC로 무작위화된 회로를 실행합니다
- TREX를 적용하여 판독 오류를 완화합니다
- PEC 가중치를 적용하고 평균을 냅니다
PEC와 DD는 PEC에 사용되는 노이즈 특성화를 DD를 활성화한 상태에서 수행하지 않는 한 일반적으로 호환되지 않습니다. PEC는 이 정상(stationary)적이고 반복 가능하며 정확하게 특성화할 수 있다고 가정합니다. DD는 시스템-환경 상호작용을 변조하고 자명하지 않은 펄스 타이밍 효과를 도입하여 노이즈 채널을 시간에 따라 명시적으로 재구성합니다. 그 결과 DD를 적용했을 때의 유효 노이즈는 적용하지 않았을 때와 같은 채널이 아닙니다. 노이즈 채널이 회로 스케줄링에 민감하게 의존할 수 있다는 점 때문에 상황은 더욱 복잡해집니다. 결국 노이즈 역변환이 잘 정의되지 않거나 유효하지 않게 됩니다.
이론적으로는 DD를 활성화한 상태에서 노이즈를 특성화하고 그에 맞게 PEC 모델을 구축하는 것이 가능하지만, 이는 매우 고급 작업이며 현재 권장되는 워크플로가 아닙니다.
PEC를 직접 적용하기
PEC는 복잡하므로 직접 구현하는 것은 권장되지 않습니다. 그래도 이 과정에 어떤 단계가 포함되는지 이해하기 위해 단일 큐비트에 대한 기본 적용 사례의 수학을 따라가 보겠습니다. 수치적 효과를 분명히 볼 수 있도록 혼합되어 있지만 자명하지 않은 상태를 선택합니다.
순수 상태에 있어야 하는 큐비트를 생각해 봅시다.
이상적인 밀도 행렬은 다음과 같습니다.
이 밀도 행렬은 대각 행렬이 아니면서 단일 큐비트에 대한 것이라 "직접" 살펴보기에 다루기 쉽기 때문에 선택했습니다.
이제 매우 단순하지만 현실적인 노이즈 모델을 적용합니다. 작은 세기 를 갖는 단일 큐비트 탈분극 채널입니다.
계산을 편하게 하기 위해 로 둡니다. 이 채널은 반드시 그래야 하듯이 완전 양(completely positive)이고 대각합 보존(CPTP)입니다. 실제 하드웨어에 대한 현실적인 노이즈 채널이며, 적어도 노이즈의 일부를 설명하는 데는 현실적입니다. 또한 이 노이즈 채널은 선형 사상으로서 해석적으로 역변환이 가능합니다. 다시 말해 역행렬이 존재하지만, 그렇다고 그 행렬이 CPTP 물리 채널에 해당한다는 뜻은 아니며, 하드웨어에서 구현할 수 있는 유니터리에 해당하는 것은 더욱 아닙니다.
이제 탈분극 노이즈 채널을 단일 큐비트 밀도 행렬에 적용하면 다음을 얻습니다.
일 때 이고 입니다.
So:
이를 우리의 상태에 적용하면 다음과 같습니다.
명시적으로 계산하면 다음과 같습니다.
이것은 여전히 물리적인 밀도 행렬이며 대각합도 여전히 1이지만 — 이제 더 혼합된 상태입니다.
이제 이상적인 역채널을 계산하되, 그것이 물리적이지 않을 가능성에 대비하겠습니다. 실제로 물리적인지 확인해 볼 것입니다. 수학적으로 역선형 사상은 다음과 같습니다.
이 역변환이 그 자체로 유효한 물리 채널이라면 정확히 구현해 보고 싶을 것입니다. 물론 유니터리 연산과 고전적 단계를 사용해 어떻게 구현할지는 여전히 알아내야 하지만, 이를 구현하는 것이 목표가 될 것입니다. 그러나 이것은 CPTP가 아니며, 일반적으로 이러한 역사상이 CPTP라는 보장은 없습니다. 이는 PEC가 존재하는 이유이므로 현재 논의에서 매우 중요합니다.
겉보기만으로도 CPTP가 아님을 알 수 있을 수도 있습니다. 확실한 확인 방법은 밀도 행렬에 적용해서 물리적인 결과가 나오는지 보는 것입니다. 이는 이해도를 확인하는 연습 문제로 남겨 둡니다.
이해도 확인
위의 역사상 를 새로운 밀도 행렬에 적용하여 CPTP인지 확인해 보세요.
결과가 물리적인지 비물리적인지 해석해 보세요.
정답
물리적인 밀도 행렬로 보면, 이는 시스템이 상태 에 있을 고전적 확률이 1보다 크고 상태 에 있을 확률이 음수라는 뜻입니다. 이 사상이 무의미한 밀도 행렬을 낼 수 있음이 분명합니다. 또한 살펴보면 결과 밀도 행렬의 고윳값이 1.0625와 -0.0625이므로 모든 고윳값이 양수는 아닙니다. 따라서 이 사상은 CPTP의 "CP"인 "완전 양(completely positive)"이 아닙니다.
이해도 확인
위의 역연산 가 노이즈 채널을 되돌려 노이즈 없는 상태를 복원하는지 명시적인 계산으로 확인해 보세요.
정답
노이즈가 있는 상태에 적용하면 다음과 같습니다.
이는 (반올림 오차를 제외하면) 원래 상태와 정확히 일치합니다.
분명히 하기 위해 다시 말씀드립니다. 노이즈 채널을 정확히 역변환할 수는 없습니다. 역변환은 CPTP가 아니며 유효한 물리 채널도 아닙니다. 하지만 물리 채널들의 선형 결합으로서 이 채널을 효과적으로 역변환할 수는 있습니다.
탈분극 채널의 경우 다음과 같습니다.
여기서 등입니다.
역변환은 다음과 같이 쓸 수 있습니다.
with:
-
= 물리적으로 구현 가능한 Clifford 채널
-
= 준확률
-
Some
이것이 PEC의 핵심 아이디어입니다.
-
∣에 따라 채널을 샘플링합니다
-
측정 결과에 부호를 붙입니다
-
기댓값이 노이즈 없는 값으로 수렴합니다
밀도 행렬 를 사용하여 추정에 PEC를 "직접" 적용하고, 에 대한 결과를 복원할 수 있는지 확인합니다. 의 경우 다음을 기대합니다.
또한 노이즈가 있는 밀도 행렬에서는 다음을 얻는다는 점에 유의하세요.
올바른 자릿수이긴 하지만 이상적인 경우와는 상당히 차이가 있습니다.
이제 PEC 과정을 통해 노이즈가 있는 밀도 행렬로부터 편향 없는 기댓값을 어떻게 재구성할 수 있는지 단계별로 살펴봅니다. 실제 워크플로에서는 이 과정이 확률적이며 자동화됩니다. 이 "직접" 계산 워크플로에서는 현실적이면서도 설명에 편리한 확률 값을 선택하겠습니다. 이를 PEC가 완벽하다는 주장으로 받아들여서는 안 됩니다. PEC 패키지 내부에서 일어날 수 있는 그럴듯한 시나리오를 보여 드리기 위한 것일 뿐입니다.
우리의 노이즈 채널이 다음 형태였음을 떠올려 보세요.
역변환은 (정확히) 다음과 같이 쓸 수 있습니다.
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
이 소개에서는 채널이 밀도 행렬에 미치는 효과에 집중하는 것이 더 간단합니다. 이렇게 하면 밀도 행렬과 기댓값 같은 익숙한 대상을 다룰 수 있습니다. 이를 위해, 이 역연산이 추정 과정에 미치는 효과에 대해 무엇이 참이어야 하는지 생각해 보세요. PEC가 만드는 추정량은 정규화되어 있고 편향이 없어야 합니다. 이는 두 가지 조건에 해당합니다.
-
정규화: 이 연산이 관측량의 스케일을 바꾸지 않도록 이 필요합니다. 그 이유를 이해하려면 역변환이 밀도 행렬에 작용하는 방식을 고려하거나, 자체처럼 자명한 것의 기댓값에 작용하는 방식을 고려하면 됩니다.
-
보정: 실제 워크플로에서는 보정 회로를 사용해 게이트 수준에서 노이즈 동작을 학습합니다. 그런 다음 노이즈 동작에 대한 게이트 수준의 지식과 기댓값의 선형성을 이용하여 학습된 노이즈 모델을 더 큰 회로에 적용합니다. 여기서는 이상적인 기댓값이 라는 인위적인 지식에서 출발했습니다. 하지만 이론적으로 이것이 이상적인 값임을 아는 상태를 만들어 내고, 실제 측정을 보정에 사용하는 것은 아주 쉽습니다. 핵심은 PEC에서는 보통 전체 회로의 완전한 노이즈 모델을 학습하지 않는다는 점입니다. 대신 개별 게이트나 회로 층에 대한 국소 노이즈 모델을 학습하고, 이를 이용하여 준확률 분해를 구성합니다.
이 조건들을 사용하여 와 를 결정합니다. 다음 가정(ansatz)을 생각해 봅니다.
and apply it to an arbitrary single-qubit density matrix .
Pauli 채널은 켤레 연산으로 작용함을 떠올려 보세요.
를 에 적용하면 다음과 같습니다.
대각합을 취하면 다음을 얻습니다.
각 Pauli 연산자는 유니터리이므로 켤레 연산은 대각합을 보존합니다.
Therefore,
PEC 추정량이 정규화되려면 유효 역사상이 모든 밀도 행렬의 대각합을 보존해야 합니다. 즉 다음이 필요합니다.
이는 다음 정규화 제약 조건을 의미합니다.
그러나 우리의 경우 이는 다음 조건을 제공합니다.
이제 보정 정보를 사용하여 관측된 기댓값을 알려진 이상적인 값과 연관시킵니다.
Or equivalently,
두 조건을 와 에 대해 풀면 다음을 얻습니다.
이 계수들의 합은 1이지만, 그중 하나는 음수입니다.
회로를 무작위로 수정하고, 측정하고, 결과에 부호 있는 가중치를 곱한 뒤 평균을 내면 이상적인 기댓값을 복원할 수 있습니다. 특히 밀도 행렬을 재구성하지 않으며 역채널을 물리적으로 구현하지도 않습니다.
핵심 단계: 이것이 바로 PEC입니다
노이즈 세기 에 대해 역채널은 다음과 같이 쓸 수 있습니다.
중요한 사실:
-
계수의 합은 1입니다
-
계수 하나는 음수입니다
-
각 항은 물리적으로 구현 가능합니다
-
음수 부분은 고전적 후처리로 옮겨집니다
가중치의 절댓값으로 샘플링 분포를 구성합니다.
(X, Y, Z 각각에 대해)
총 가중치:
샘플링 확률은 W로 나누어 구합니다.
| 연산 | 확률 | 부호 |
|---|---|---|
| 아무것도 하지 않음 () | 1.1875 / 1.375 ≈ 0.864 | + |
| X 적용 | 0.0625 / 1.375 ≈ 0.045 | - |
| Y 적용 | 0.0625 / 1.375 ≈ 0.045 | - |
| Z 적용 | 0.0625 / 1.375 ≈ 0.045 | - |
부호는 확률이 아니라 원래 계수에서 가져옵니다.
각 샷은 다음 단계로 구성됩니다.
-
상태를 준비합니다
-
하드웨어가 노이즈가 있는 회로를 적용하도록 합니다
-
위 표에서 해당 확률에 따라 연산을 무작위로 선택합니다
-
Apply it
-
를 측정하여 을 얻습니다
-
결과에 를 곱합니다
-
그 숫자를 기록합니다
이제 몇 번의 샷에 대한 예를 살펴봅니다.
샷 1 (항등 연산의 경우)
무작위로 선택된 연산이 항등 연산 (또는 같은 의미로, 아무것도 하지 않음)라고 가정해 봅시다. 위의 논의와 표에 따르면 이런 일은 86.4%의 확률로 일어납니다. 노이즈 채널의 역변환에서 의 계수는 양수이므로 부호를 선택합니다. Z 측정은 중 어느 쪽이든 쉽게 나올 수 있습니다. 이 나왔다고 가정해 봅시다.
이 샷의 PEC 보정 기여분은 다음과 같습니다.
샷 2 (다시 항등 연산)
무작위 연산으로 다시 가 나왔다고 가정해 봅시다(따라서 항의 부호는 여전히 입니다). 하지만 이번에는 Z 측정에서 이 나왔습니다. 이번 기여분은 다음과 같습니다.
샷 3 (X가 선택된 경우)
이번에는 무작위 연산이 X입니다. 역변환에서 이 항은 음수이므로 부호를 유지합니다. X를 적용한 다음 Z를 측정합니다. 이번에도 어느 쪽 고윳값이든 나올 수 있는데, 이 나왔다고 해 봅시다. 이 항의 기여분은 다음과 같습니다.
샷 4 (Z가 선택된 경우)
무작위 연산은 Z입니다. 표에 따라 부호를 갖습니다. Z를 측정하여 을 얻었다고 가정해 봅시다. 기여분은 다음과 같습니다.
샷 5 (Y가 선택된 경우)
무작위 연산은 Y입니다. 표에 따라 부호를 갖습니다. Z를 측정하여 을 얻었다고 가정해 봅시다. 기여분은 다음과 같습니다.
결과 평균 내기
이러한 PEC 가중 결과를 많이 수집한다고 상상해 봅시다.
구성상 항등 연산은 86.4%의 확률로 적용하고, 나머지 각 게이트는 4.5%의 확률로 적용합니다. 실제 워크플로에서는 정확한 기저 상태도, 전체 노이즈 채널도 알지 못합니다. 하지만 위에서 구한 가중 인자 와 각 연산을 적용하는 상대적 확률은 알고 있습니다. 실제 워크플로에서는 알려지지 않은 밀도 행렬이 측정 결과를 제공합니다. 여기서는 이 절차가 올바른 결과를 낸다는 것을 검증하겠습니다.
측정 전에 Pauli 연산자 를 적용한 경우를 포함하여, 모든 가중 및 부호 있는 측정값의 평균을 계산하려고 합니다. 전체 샷 수를 라고 합시다. Pauli 가 적용된 모든 샷의 집합을 라 하고, 이 샷들을 로 인덱싱합니다. 번째 Pauli를 적용했을 때 번째 샷의 측정 결과를 라고 합시다. 이 평균은 다음과 같이 쓸 수 있습니다.
Pauli 연산자 는 확률 로 확률적으로 적용됩니다. 샷 수가 충분히 많은 극한에서는 다음이 성립합니다.
이를 사용하여 다음과 같이 쓸 수 있습니다.
여기서 는 가 적용된 샷들의 앙상블에 대해서만 구한 Z의 기댓값입니다. 각 기댓값이 무엇이어야 하는지 밀도 행렬로부터 알 수 있으므로 이는 유용합니다. 다시 말하지만 실제 워크플로에서는 이것이 알려진 밀도 행렬이 아니라 측정에서 나옵니다.
이해도 확인
위의 기댓값 를 계산이나 논리적 추론으로 검증해 보세요.
정답
Y와 Z도 위와 똑같은 방식으로 진행됩니다.
이제 전체 기댓값을 다음과 같이 다시 쓸 수 있습니다.
게이트 노이즈에 대한 매개변수 와 (더 복잡한 노이즈 채널이라면 더 많은 매개변수)를 알고 있다면, (1) 전체 가중치 계수와 (2) 파울리 연산자를 적용해야 하는 확률을 결정하기에 충분합니다. 위 결과가 보여 주는 것은, 이렇게 하면 노이즈를 완화하고 편향되지 않은 기댓값을 복원할 수 있다는 점입니다. 다음과 같은 상황임에도 모든 샷의 평균은 로 수렴했습니다.
-
개별 샷의 기여도가 ±1보다 큽니다
-
일부 샷은 음의 통계적 가중치를 가집니다
-
모든 양자 연산은 물리적으로 구현 가능했습니다
PEC 워크플로 개요
PEC에서 양자 컴퓨터에서 수행하는 모든 단계는 다음과 같습니다.
-
노이즈 학습
-
대상 회로를 위한 상태 준비
-
위에서 설명한 대로 파울리 게이트를 확률적으로 적용
-
Measurement
유효 역(逆) 노이즈 맵은 고전적 후처리에서 통계적으로 구현됩니다. 이를 통해, 그렇지 않으면 음의 확률과 같은 비물리적 단계가 필요했을 노이즈 채널을 더 일반적으로 역변환할 수 있습니다.
이에 대한 대가는 분산입니다. 이전에는 각 샷의 "크기"가 가능한 측정 결과의 크기 과 같았습니다. 가중치 계수 로 스케일링한 뒤에는 크기가 (위 예시에서는 1.375)가 됩니다.
이것이 PEC의 샘플링 오버헤드가 생기는 원인입니다.
내장 PEC
이제 IBM Quantum 프리미티브에 내장된 PEC를 사용해 보겠습니다. 여기서는 전체 게이트 수준 PEC와, IBM Quantum 프리미티브가 사용하는 더 확장성 있는 PEC를 위한 국소 노이즈 학습 모델을 구분하는 것이 중요합니다. 전체 PEC를 사용할 때의 오버헤드 때문에 적용 대상은 작은 회로로 제한됩니다. 그것도 괜찮지만, 양자 컴퓨팅이 실제 문제에서 가치를 갖는 규모까지 확장할 수 있는 도구가 더 유용합니다. 이 때문에 IBM Quantum 프리미티브는 학습된 파울리-린드블라드(Pauli-Lindblad) 노이즈 모델을 사용하는 계층별 PEC를 적극적인 확장성 보호 장치와 함께 사용합니다. 이 PEC 구현에서는 노이즈를 게이트 인스턴스별이 아니라 반복되는 회로 계층별로 학습하며, 노이즈 모델은 파울리 트월링(Pauli-twirled)되고, 국소적이며, 마르코프(Markovian) 특성을 가집니다. 클리포드 게이트는 노이즈 모델에 흡수되고, 비클리포드 게이트가 완화 비용을 좌우합니다. 샘플링 오버헤드는 지수적 폭증을 막기 위해 상한이 설정됩니다.
IBM Quantum 프리미티브에 내장된 PEC를 작은 규모(6큐비트)와 중간 규모(30큐비트)의 두 가지 규모에 적용하여, 이 버전의 PEC에서 비용이 어떻게 관리되는지 살펴보겠습니다. 각 규모의 실험에서 PEC 결과를 완화를 적용하지 않은 결과, ZNE 결과, 이상적인 값과 명시적으로 비교하겠습니다.
먼저 필요한 패키지 몇 가지를 가져옵니다.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
추정할 관측량을 선택합니다. 아래 관측량은 이징(Ising) 유사 스핀 사슬의 해밀토니언으로, 상호작용의 성분에는 최근접 이웃 결합만 있고, 방향의 외부 자기장 때문인 것처럼 에 단일 큐비트 항이 있습니다.
이 해밀토니언을 선택한 데에 특별한 이유는 없습니다. 오류 완화가 효과를 발휘할 수 있도록 자명하지 않은 관측량과 회로의 조합이 필요할 뿐입니다. 큐비트 수를 늘려도 에너지가 같은 자릿수로 유지되도록, 계수를 사용해 큐비트 수로 나누어 해밀토니언의 크기를 명시적으로 조정합니다. 처음에는 6큐비트로 시작합니다.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
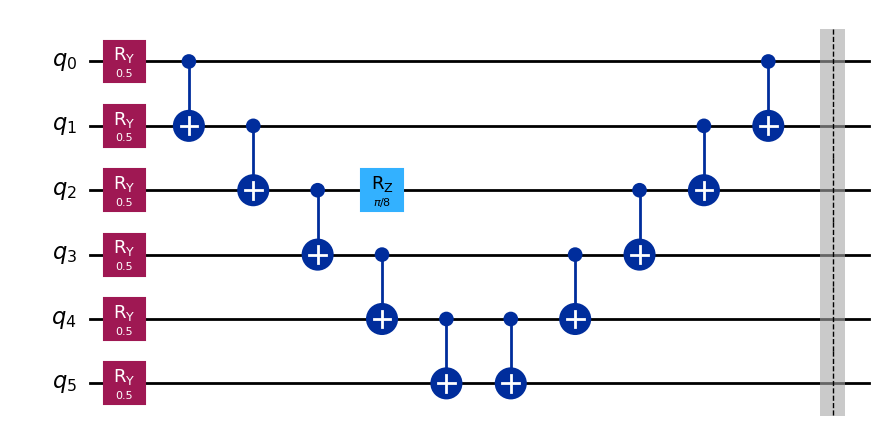
해밀토니언을 선택할 때와 마찬가지로, 아래 상태 준비 회로도 어떤 물리적인 이유로 선택한 것이 아닙니다. 오히려 PEC가 유용할 만큼 충분한 2큐비트 깊이와 충분히 많은 비클리포드 게이트를 갖도록 선택했습니다. 예를 들어 이 회로가 이 스핀 사슬의 바닥 상태를 잘 근사한다고 볼 이유는 없습니다.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
회로를 트랜spile하고 그 결과 레이아웃을 관측량에 적용합니다.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Statevector 시뮬레이터를 사용해 이상적인 기댓값을 구합니다.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
다른 이상적인 값도 크기가 비슷할 것으로 예상합니다. 이제 이것을 오류 완화 없이 실제 IBM 양자 컴퓨터에서 실행합니다.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
이제 같은 문제에 ZNE를 적용합니다.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
마지막으로 PEC를 적용합니다.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
아래에서 결과를 그래프로 그려 비교합니다.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
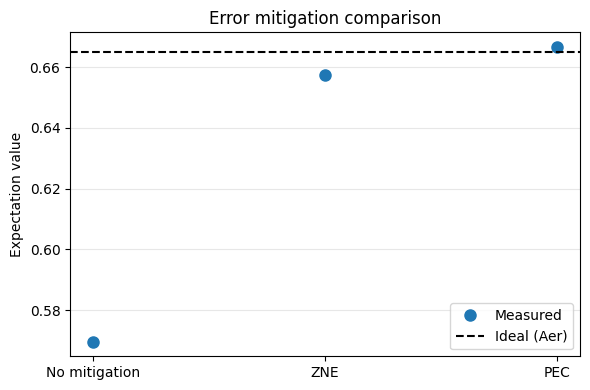
매우 잘 작동했습니다. PEC를 사용한 추정값은 이상적인 값과 불과 0.2%밖에 차이 나지 않습니다.
하지만 양자 오버헤드가 지수적으로 증가한다는 점을 기억하세요. 우리는 최대 오버헤드를 max_overhead = 100으로 제한했습니다. 소요 시간과 결과의 품질로 볼 때 이 최댓값에는 도달하지 않았던 것으로 보입니다. 그러나 계산 규모를 키우면서 이 최댓값을 그대로 두면 상한에 도달하게 되고 결과가 나빠집니다.
회로를 30큐비트로 키우면 어떻게 되는지 볼 수 있습니다. 흥미롭게도 많은 노트북 컴퓨터에서 Statevector 시뮬레이터는 24~28큐비트 즈음에서 시간 초과가 발생하기 시작합니다. 이를 우회하는 계산적 방법을 찾을 수도 있겠지만, 대신 양자 컴퓨터가 고전 컴퓨터가 따라갈 수 없는 규모에서 일부 문제를 풀 수 있게 될 것이라는 사실을 받아들이겠습니다. 그것이 핵심입니다. 그렇다면 그런 경우에 양자 컴퓨팅 결과를 검증하려면 어떻게 해야 할까요? 몇 가지 가능한 답이 있습니다.
- 어떤 문제는 풀기는 어렵지만 확인하기는 쉽습니다(쇼어 알고리즘의 소인수분해처럼).
- 어떤 문제는 복잡도가 줄어들어 고전적으로, 심지어 해석적으로 풀 수 있는 매개변수 영역이나 변형이 있어서, 몇몇 지점을 비교할 수 있습니다. 이 경우에는 (큐비트 수로 나누었으므로) 시스템 크기에 무관한 해밀토니언을 선택했습니다. 따라서 이상적인 기댓값은 상당히 안정적이어야 합니다. 이상적인 기댓값이 큐비트 수에 따라 어떻게 달라지는지 살펴보고, 30큐비트에서의 값을 고전적으로 예측할 수 있는지 확인해 보겠습니다.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
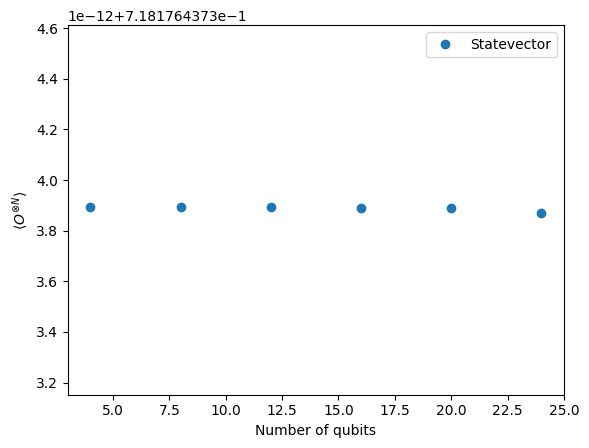
실제로 우리가 선택한 해밀토니언과 상태는 큐비트 수에 따라 변하지 않음을 확인할 수 있습니다. 양자 컴퓨팅의 연구 응용으로는 매우 부적절하지만, 오류 완화 기법을 벤치마킹하기에는 훌륭한 선택입니다. 오류 완화 테스트를 위해 큐비트 수를 늘려 가더라도, 이 고정된 기댓값을 이상적인 결과로 확신을 갖고 사용할 수 있습니다.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
이제 이 더 큰 회로를 ZNE로 실행합니다.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
마지막으로 30큐비트 예제를 PEC로 실행합니다.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
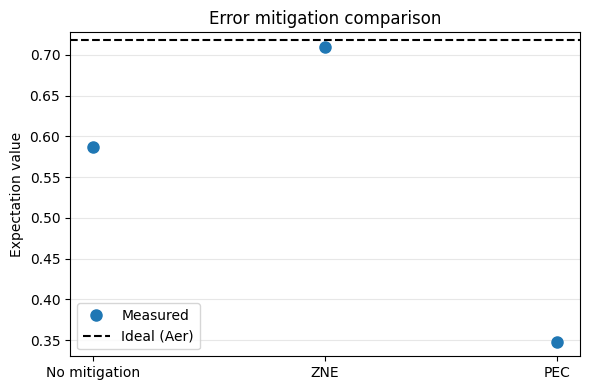
PEC는 다른 옵션보다 훨씬 오래 걸렸을 뿐만 아니라, 최대 오버헤드 임계값에 분명히 도달했습니다. PEC 결과는 오버헤드 비용을 치렀지만, 오버헤드 상한 때문에 학습된 노이즈 모델을 충분히 정확하게 상쇄하지 못했습니다. 이것은 매우 중요합니다. 6큐비트에서는 양자 오버헤드를 소폭(약 5배) 늘리는 것만으로 PEC를 활용해 더 나은 결과를 얻을 수 있었습니다. 30큐비트에서는 훨씬 큰 비용(약 60배)을 치렀음에도 결과는 완화하지 않은 추정값보다도 나빴습니다. 이것이 30큐비트에서 PEC가 결코 작동할 수 없다는 뜻은 아닙니다. 회로에 따라 달라질 수 있습니다. 요점은 양자 오버헤드의 지수적 증가 때문에 큰 회로에서 실행하기가 어렵다는 것입니다.
핵심 요약:
-
측정 완화는 흔히 도움이 되며 보통 오버헤드가 낮습니다. 회로 깊이에 따라 커지지 않는 편향을 제거하며, 거의 모든 기법과 깔끔하게 조합됩니다.
-
일부 기법은 조합할 수 없습니다. 조합할 수 있는 경우에도, 한 기법이 다른 기법을 되돌리지 않도록 일관된 방식으로 조합해야 합니다. 좋은 예로, M3와 조합하려면 M3 보정 중에 트월링을 켜 두어야 합니다.
-
PEC와 ZNE는 서로의 대안으로 생각해야 합니다. 두 기법은 같은 문제를 반대되는 트레이드오프로 해결합니다.
-
PEC: 지수적인 분산을 대가로 편향되지 않은 기댓값을 제공합니다.
-
ZNE는 일반적으로 외삽 모델에 따라 달라지는 잔여 편향이 남지만, 비용은 적당합니다.
-
-
DD는 긴 유휴 시간에 도움이 될 수 있지만 노이즈 모델을 바꾸며, 외삽 또는 역변환 가정을 무효로 만들 수 있습니다.
-
파울리 트월링은 노이즈를 줄이지 않습니다. 노이즈의 형태를 바꾸며, 다른 기법(ZNE와 PEC)이 더 잘 작동하도록 해 주는 경우가 많습니다.