페르미온 회로 활용하기
이 가이드의 개념은 현재 Python API에서만 사용할 수 있습니다. 동등한 기능은 향후 릴리스에서 C API로도 제공될 예정입니다.
이 가이드에서는 FermionicCircuit을 사용해 큐비트로 먼저 매핑하지 않고 페르미온 공간에서 직접 양자 알고리즘을 구현하는 방법을 설명합니다.
페르미온 회로를 사용하는 이유
큐비트 기반 아키텍처에서 페르미온 해밀토니안의 시간 발전을 구현하는 기존 워크플로를 생각해 보세요.
-
페르미온 해밀토니안을 정의합니다(예: ).
-
이를 큐비트 연산자로 매핑합니다(예: Jordan-Wigner 매핑 사용).
-
큐비트 공간에서 시간 발전을 구현합니다(Trotter 분해 또는 다른 방법 사용).
이 접근 방식에는 근본적인 한계가 있습니다. 큐비트로 일찍 매핑하면 페르미온 구조에 대한 문제 인지 정보가 사라집니다. 표준 최적화 패스는 페르미온 대칭성이나 허용되는 항 재정렬을 활용할 수 없으므로, 불필요한 깊이와 게이트 수를 가진 최적이 아닌 회로가 만들어집니다.
FermionicCircuit은 더 나은 워크플로를 가능하게 합니다.
-
페르미온 해밀토니안을 정의합니다(예: ).
-
페르미온 게이트를 사용해 페르미온 공간에서 직접 시간 발전을 구현합니다.
-
트랜스파일 과정의 일부로 큐비트 공간에 매핑합니다.
이 접근 방식은 문제 인지 정보를 페르미온 공간에 유지함으로써 한계를 해결합니다. 페르미온 공간에서는 최적화 패스가 페르미온 구조와 교환 관계를 활용해 회로 깊이를 줄일 수 있습니다. 페르미온 회로는 어떤 계산을 수행할지를 기술하고, 트랜스파일은 이를 큐비트에 어떻게 매핑할지를 처리하므로, 관심사가 더 깔끔하게 분리됩니다.
일반 모드 인덱싱
operators 모듈과 FermionicCircuit은 모두 모드의 성격에 대해 어떤 가정도 하지 않는 일반적인 모드 기반 인덱싱을 사용합니다. 모드는 고유한 의미 없이 페르미온 자유도를 가리키는 추상적인 인덱스일 뿐입니다. 이러한 설계는 operators 모듈의 방식을 그대로 따르며 최대한의 유연성을 보장합니다. 예를 들어 OperatorTrait 프로토콜을 구현하는 모든 연산자에 대해, 수학적 표현과 관계없이 시간 발전을 구현할 수 있습니다.
페르미온 회로 만들기
아래 예제는 이전 섹션에서 설명한 시간 발전을 구현합니다. 페르미온 모드의 수를 지정해 FermionicCircuit을 만든 다음, qiskit_fermions.circuit.library의 페르미온 게이트를 추가해 시간 발전을 구현합니다.
또한 이 예제는 연산자 항 그룹화를 사용해 연산자에 도메인 지식을 담는 방법도 보여 줍니다. 해밀토니안 항에 그룹 인덱스를 할당하면, 트랜스파일 스택 전반에서 최적화 패스가 활용할 수 있는 구조 정보를 보존할 수 있습니다.
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.operators import FermionOperator, cre, ann
>>>
>>> # Create a circuit with 4 fermionic modes
>>> circuit = FermionicCircuit(4)
>>>
>>> # Define a simple fermionic Hamiltonian
>>> hamiltonian = FermionOperator.from_terms([
...     ([cre(0), ann(2)], 0.5),
...     ([cre(2), ann(0)], 0.5),
...     ([cre(1), ann(3)], 0.5),
...     ([cre(3), ann(1)], 0.5),
... ])
>>> # Add some problem structure by grouping our Hamiltonian terms
>>> hamiltonian.groups = [0, 0, 1, 1]
>>>
>>> # Add an evolution gate to implement exp(-i * t * H)
>>> evolution = Evolution(4, hamiltonian, time=1.0)
>>> circuit.append(evolution, circuit.register)


분해와 같은 간단한 연산에서도 연산자 항 그룹화가 보존되는 것을 확인해 보세요. 이는 구조 정보가 회로 스택을 따라 어떻게 전달되는지를 보여 줍니다. 큐비트로의 전체 트랜스파일 과정을 이해하려면 페르미온 회로 트랜스파일하기 가이드를 참고하세요.
배리어로 게이트 분리하기
최적화 패스는 가능한 경우 인접한 게이트를 융합합니다. 예를 들어 MergeOrbitalRotations는 연속된 OrbitalRotation 게이트 묶음을 하나로 합치고, MergeSlaterDeterminantPreparation는 InitializeModes를 뒤따르는 회전에 흡수시킵니다.
이를 막고 싶다면 FermionicCircuit.barrier()를 사용하세요. 배리어는 유니터리 효과가 없으므로 회로가 준비하는 상태를 바꾸지 않으며, 패스가 그 지점을 넘어 융합하지 않도록 표시만 합니다. 인수 없이 호출하면 모든 모드에 걸쳐 적용되고, 모드를 전달하면 해당 모드로 제한됩니다.
>>> from qiskit_fermions.circuit.library import OrbitalRotation
>>> import numpy as np
>>>
>>> rotations = FermionicCircuit(4)
>>> rotations.append(OrbitalRotation(np.eye(4, dtype=complex)), rotations.register)
>>> rotations.barrier()
>>> rotations.append(OrbitalRotation(np.eye(4, dtype=complex)), rotations.register)

배리어는 페르미온-큐비트 트랜스파일 이후에도 유지되므로, 이어지는 큐비트 수준 최적화에도 제약을 줍니다. 이 단계는 페르미온 회로 트랜스파일하기 가이드에서 다룹니다.
회로 반복하기
많은 알고리즘이 같은 게이트 블록을 여러 번 반복해서 적용합니다. 시간 발전이 대표적인 경우입니다. Trotter 스텝을 한 번 만든 뒤 목표 시간에 도달할 때까지 반복합니다. 반복된 회로를 만들려면 repeat()를, 이를 상태 준비 접두 회로에 이어 붙이려면 compose()를 사용하세요.
아래 예제는 Fermi-Hubbard 모델의 2차 Trotter 스텝을 만듭니다. 이 스텝은 대칭적입니다. 호핑 항을 절반 길이의 OrbitalRotation 게이트 두 개로 나누어 온사이트 상호작용을 감쌉니다.
>>> import scipy.linalg
>>> from qiskit_fermions.circuit.library import InitializeModes, OrbitalRotation
>>>
>>> norb, reps, time = 2, 3, 1.0
>>> num_modes = 2 * norb
>>> dt = time / reps
>>>
>>> hopping = np.zeros((norb, norb))
>>> hopping[0, 1] = hopping[1, 0] = -1.0
>>> interaction = FermionOperator.from_dict(
...     {(cre(p), ann(p), cre(p + norb), ann(p + norb)): 2.0 for p in range(norb)}
... )
>>>
>>> def rotation(duration):
...     propagator = scipy.linalg.expm(-1j * duration * hopping)
...     # the same rotation acts on the alpha and beta halves of the register
...     return scipy.linalg.block_diag(propagator, propagator)
>>>
>>> trotter_step = FermionicCircuit(num_modes)
>>> trotter_step.append(OrbitalRotation(rotation(dt / 2)), trotter_step.modes)
>>> trotter_step.append(
...     Evolution(num_modes, interaction, dt, atomic=True), trotter_step.modes
... )
>>> trotter_step.append(OrbitalRotation(rotation(dt / 2)), trotter_step.modes)
이 스텝을 반복하고 Hartree-Fock 기준 상태 뒤에 이어 붙이면 전체 시간 발전이 만들어집니다.
>>> evolution = FermionicCircuit(num_modes)
>>> evolution.append(InitializeModes([True, False, True, False]), evolution.modes)
>>> evolution.compose(trotter_step.repeat(reps), inplace=True)
>>> evolution.count_ops()["OrbitalRotation"]
6
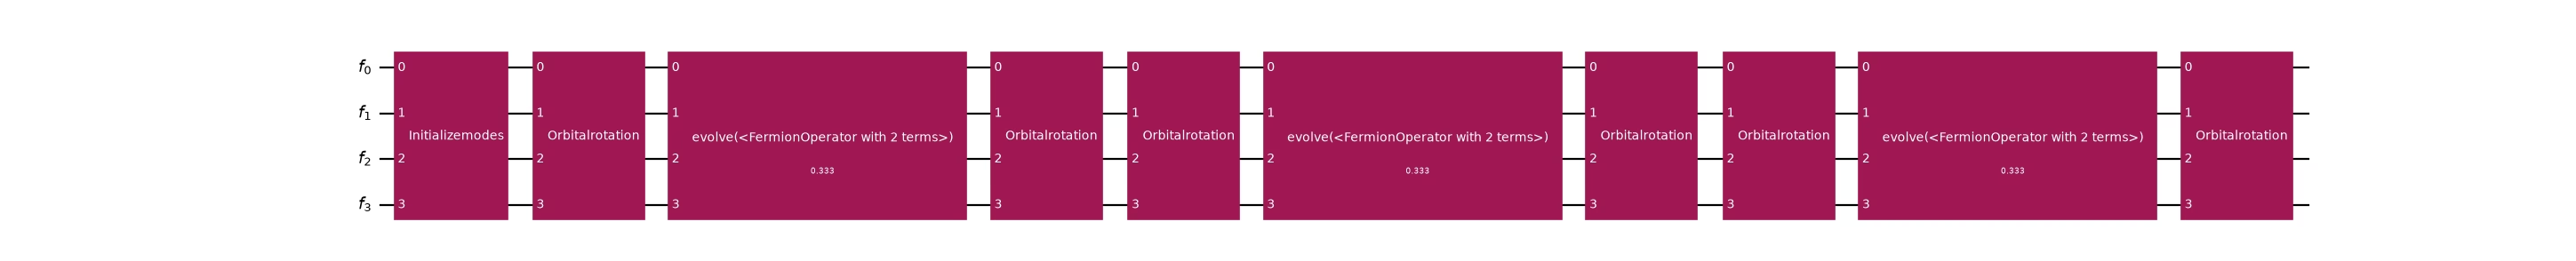
반복된 스텝은 하나의 게이트로 감싸지 않고 반환되는 회로에 펼쳐지므로, count_ops()는 스텝마다 회전을 두 개씩 셉니다. 이렇게 펼쳐져 있기 때문에 트랜스파일러가 스텝 경계의 중복을 볼 수 있습니다. 한 스텝의 마지막 절반 길이 회전과 다음 스텝의 첫 절반 길이 회전이 서로 인접하므로, MergeOrbitalRotations가 이를 하나의 회전으로 합칩니다.
>>> from qiskit_fermions.transpiler import FermionicPassManager
>>> from qiskit_fermions.transpiler.passes import MergeOrbitalRotations
>>>
>>> merged = FermionicPassManager([MergeOrbitalRotations()]).run(evolution)
>>> merged.count_ops()["OrbitalRotation"]
4
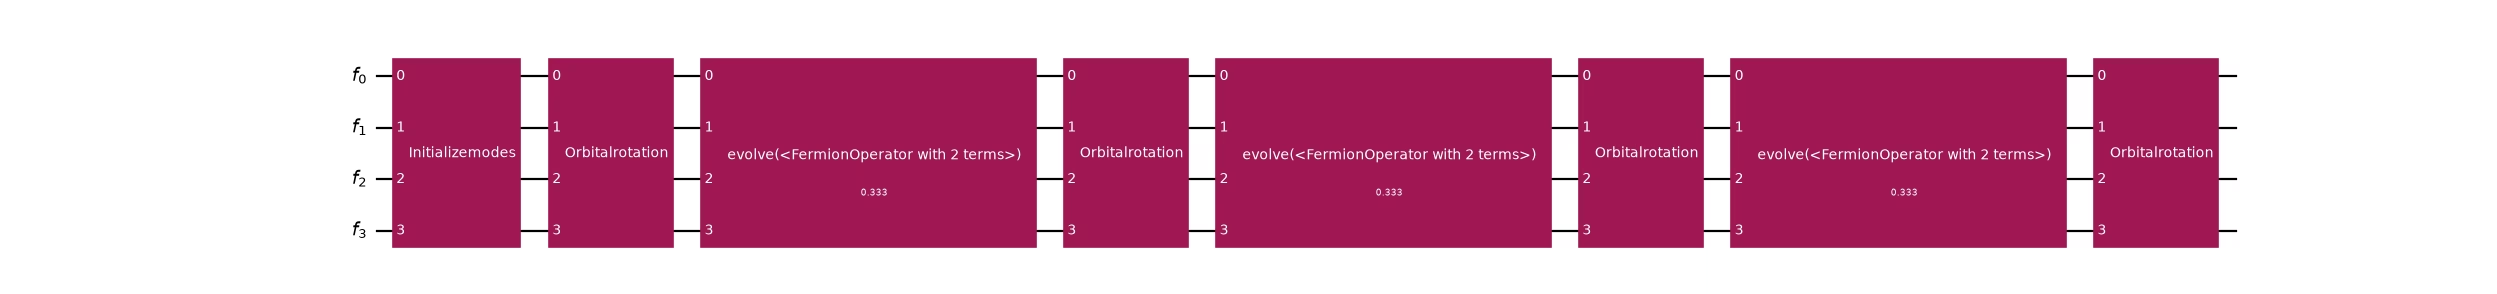
그 결과 스텝당 회전 하나에 하나를 더한 비용이 드는데, 이는 이 절반 스텝들을 직접 융합했을 때와 같습니다. 스텝을 자연스러운 대칭 형태로 작성해 반복하면 같은 회로가 만들어지므로, 융합은 최적화 단계에 맡깁니다.
반복된 스텝을 서로 분리해 두어야 한다면 insert_barriers=True를 전달해 그 사이에 barrier()를 배치하세요. 최적화 패스는 배리어를 넘어 게이트를 융합하지 않으므로 모든 회전이 유지됩니다.
>>> separated = trotter_step.repeat(reps, insert_barriers=True)
>>> FermionicPassManager([MergeOrbitalRotations()]).run(separated).count_ops()[
...     "OrbitalRotation"
... ]
6
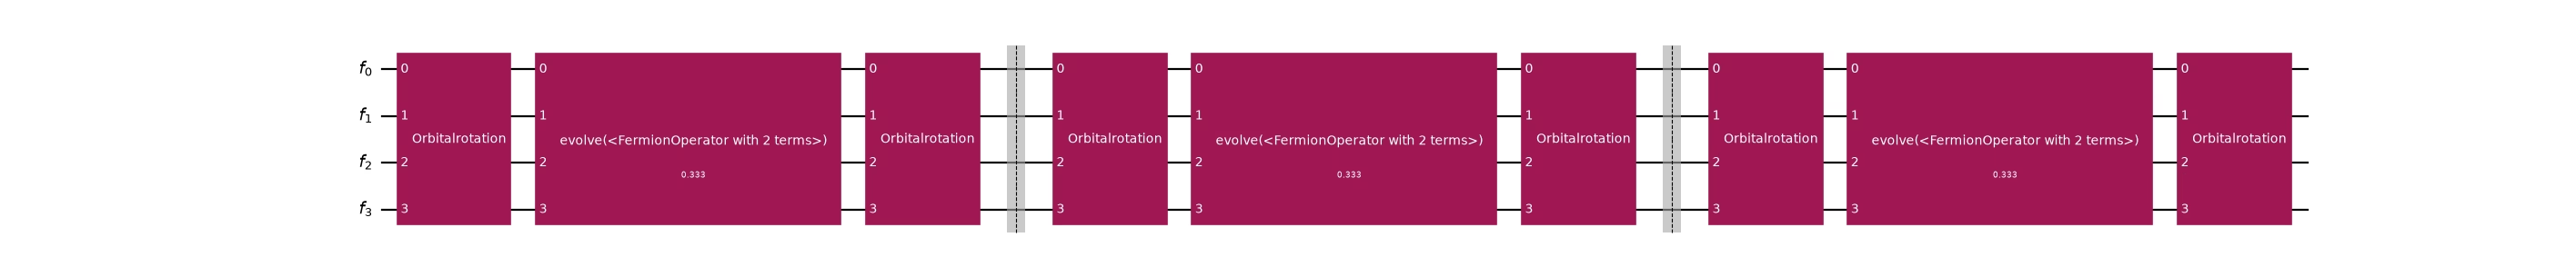
FermionicSuzukiTrotter의 reps 인수는 다른 개념입니다. 이는 하나의 Evolution 게이트를 더 많고 더 짧은 인자로 세분화하는 반면, repeat()는 회로 전체를 복제합니다. Evolution 하나를 담은 회로를 반복하면 전체 발전 시간만 배가됩니다.
페르미온 모드 측정하기
measure_all()은 모드 i를 비트 i와 짝지어 모든 모드를 각각의 고전 비트로 읽어 냅니다. 일부 모드만 읽으려면 직접 만든 ClassicalRegister와 함께 measure()를 사용하세요.
>>> measured = trotter_step.measure_all(inplace=False)
>>> measured.count_ops()["measure"]
4
inplace=False를 전달하면 원본은 그대로 두고 측정이 추가된 복사본을 반환합니다. 측정은 유니터리가 아니어서, 측정이 포함된 회로는 더 이상 상태 벡터에 적용할 수 없기 때문에 이 점이 중요합니다. 시뮬레이션도 하고 싶다면 측정하지 않은 회로를 따로 보관해 두세요.
트랜스파일된 QuantumCircuit이 아니라 여기에서 측정하면 샘플링된 비트열을 읽기 쉽게 유지할 수 있습니다. 페르미온 측정은 읽어 내는 모드를 이름으로 지정하므로, 모드를 옮기는 모든 단계(페르미온 수준의 RelabelModes, 큐비트 수준의 레이아웃과 라우팅)에서 측정이 함께 따라가고, 비트열은 사용자가 지정한 모드를 기준으로 인덱싱된 상태로 유지됩니다.
measure_all()과 달리, 측정 앞에 barrier()가 삽입되지 않습니다. 배리어가 필요하면 먼저 직접 barrier()를 호출하세요.
측정된 비트가 기대한 의미를 갖는지는 여기가 아니라 트랜스파일 중에 선택되는 페르미온-큐비트 인코딩에 따라 달라집니다. Jordan-Wigner와 같은 점유 기저 인코딩에서는 각 모드가 큐비트 하나로 표현되고 비트는 해당 모드의 점유 상태가 됩니다. 자세한 내용은 FermionicMeasure를 참고하세요.
페르미온 회로 트랜스파일하기
FermionicCircuit이 나타내는 양자 알고리즘을 구현하려면 이를 QuantumCircuit으로 트랜스파일해야 합니다. 방법은 페르미온 회로 트랜스파일하기 가이드에서 확인할 수 있습니다.
다음 단계
-
사용 가능한 페르미온 게이트는
qiskit_fermions.circuit.library문서에서 알아보세요. -
페르미온 회로와 함께 사용할 수 있는 페르미온 해밀토니안을 구성하는 방법은 연산자 설명 가이드에서 살펴보세요.
-
실용적인 엔드투엔드 예제는 SQDRIFT 시작 가이드를 참고하세요.
-
FermionicCircuit을 직접 시뮬레이션하는 방법과, 이러한 일반 모드 인덱스가 시뮬레이션 시점에만 스핀 의미를 갖게 되는 과정은 ffsim 관계 가이드에서 확인하세요.