LUCJ ansatz 트랜spile
이 가이드의 개념은 Python API에서만 사용할 수 있습니다.
국소 유니터리 클러스터 Jastrow(LUCJ) ansatz는 상관된 전자 파동함수를 간결하고 하드웨어 효율적으로 매개변수화한 것입니다. 더 일반적인 유니터리 클러스터 Jastrow(UCJ) 계열의 일원이며 다음 형태를 가집니다.
여기서 는 (보통 Hartree-Fock인) 기준 상태이고, 각 는 오비탈 회전이며, 각 는 대각 쿨롱 연산자입니다.
는 스핀 를 가진 공간 오비탈 의 수 연산자입니다.
ffsim이 ansatz 연산자를 만들고, 이 패키지는 그것을 회로로 바꾼 다음 그 회로를 큐비트로 내립니다. 이 가이드는 그 문장의 후반부를 다룹니다. 이 과정을 거치는 이유는 바로 이 내리는 과정 때문입니다. ffsim 자체의 Qiskit Gate는 Jordan-Wigner 변환에 특화되어 있는 반면, FermionicCircuit은 페르미온-큐비트 인코딩에 대한 가정이 없으므로, 대상 디바이스에 맞는 어떤 인코딩으로든 같은 ansatz를 합성할 수 있습니다.
따라서 ansatz 연산자는 이미 만들어진 상태로 여기에 도착하며, 아래의 모든 내용은 그 이후에 일어나는 일입니다. Gate가 무엇으로 분해되는지, Jordan-Wigner를 통해 어떻게 내려가는지, 디바이스 커플링 맵에 어떻게 맞춰지는지, 그리고 Jordan-Wigner가 아닌 방식으로 내리려면 무엇이 더 필요한지를 다룹니다. UCJ ansatz를 처음부터 구성, 매개변수화 또는 시뮬레이션하는 방법은 ffsim의 자체 가이드를 참고하세요.
두 패키지가 작업을 어떻게 나누는지는 ffsim 관계 가이드를, 아래에서 사용하는 파이프라인 단계는 트랜spile 가이드를 참고하세요.
1. ffsim에서 LUCJ 연산자 가져오기
ansatz는 결합 클러스터 단일 및 이중 여기(CCSD) 계산의 진폭으로 초기화됩니다. 양자화학 계산에는 PySCF를 사용하여 6-31g 기저에서 수소 분자에 대해 제한 Hartree-Fock에 이어 CCSD를 실행한 다음, 그 진폭을 ffsim의 from_t_amplitudes()에 전달합니다. 이 함수는 진폭에 대해 이중 인수분해를 수행하여 층별 대각 쿨롱 행렬과 오비탈 회전을 얻고, 진폭으로부터 선택적인 마지막 오비탈 회전을 도출합니다. 반복 횟수 은 이 인수분해가 내놓는 값이며, n_reps는 이를 잘라 내어 정확도를 희생하는 대신 더 얕은 회로를 얻습니다.
>>> import ffsim
>>> import pyscf
>>> import pyscf.cc
>>>
>>> # build the molecule and run Hartree-Fock
>>> mol = pyscf.gto.Mole()
>>> mol.build(
...     atom=[["H", (0, 0, 0)], ["H", (0, 0, 0.74)]],
...     basis="6-31g",
...     symmetry="Dooh",
...     verbose=0,
... )
<pyscf.gto.mole.Mole object at ...>
>>> scf = pyscf.scf.RHF(mol).run()
>>>
>>> norb = scf.mo_coeff.shape[1]
>>> nelec = (mol.nelec[0], mol.nelec[1])
>>>
>>> # run CCSD for the t-amplitudes, then factorize them into an ansatz operator
>>> ccsd = pyscf.cc.CCSD(scf).run()
>>> t1, t2 = ccsd.t1, ccsd.t2
>>>
>>> ucj_op = ffsim.UCJOpSpinBalanced.from_t_amplitudes(t2, t1=t1, n_reps=2)
여기서부터는 ansatz가 더 이상 ffsim의 관심사가 아닙니다. ffsim은 이 패키지가 보지도 알 필요도 없는 선택지를 제공합니다. 예를 들어 optimize=True의 기반이 되는 변분 최적화된("압축된") 인수분해나, 변분 최적화기가 구동하는 파라미터 벡터 패킹 등이 그렇습니다. 이들은 모두 같은 종류의 연산자를 만들어 내며, 아래의 모든 내용은 그중 어느 것에든 변경 없이 동작합니다.
2. 연산자를 페르미온 회로로 바꾸기
UCJ Gate는 연산자를 감싸 페르미온 모드 위의 회로로 표현합니다. 이 Gate는 자체 기준 상태가 없는 순수 유니터리이므로, ansatz가 적용될 Hartree-Fock 기준 상태를 제공하기 위해 (from_hartree_fock()로 만든) InitializeModes Gate를 앞에 추가하세요.
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import InitializeModes, UCJ
>>>
>>> ansatz = UCJ(ucj_op)
>>>
>>> circuit = FermionicCircuit(2 * norb)
>>> circuit.append(InitializeModes.from_hartree_fock(norb, nelec), circuit.modes)
>>> circuit.append(ansatz, circuit.modes)
회로를 분해하면 그 구조가 드러나며, 가이드의 나머지 부분은 이 표현을 기반으로 동작합니다. InitializeModes Gate는 기준 행렬식을 준비하고, 각 ansatz 층은 OrbitalRotation , 이어서 (대각 쿨롱 연산자 의 Evolution), 그다음 를 차례로 기여하며, 마지막에 최종 OrbitalRotation이 옵니다. 오비탈 회전은 스핀 섹터별로 작용하므로, 각각 알파 모드 0..norb와 베타 모드 norb..2*norb에 독립적으로 배치됩니다.
>>> circuit.decompose().draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
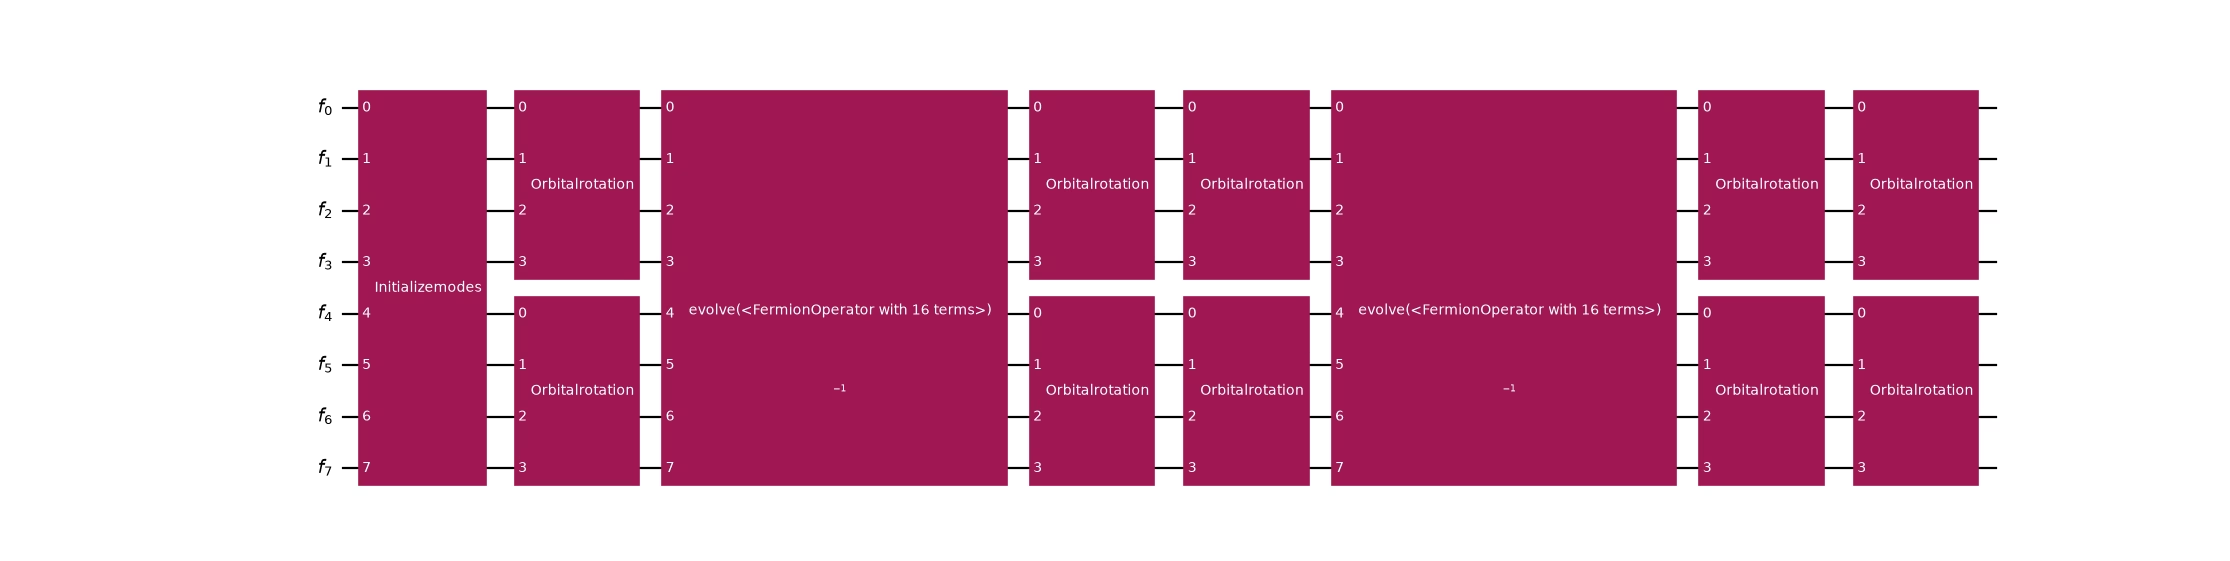
그 분해의 모든 Gate는 여전히 페르미온 Gate입니다. OrbitalRotation과 Evolution은 모드 위에 정의되며, 아직 큐비트나 Pauli 연산자는 등장하지 않았습니다. 이것이 인코딩을 열어 두는 이유이며, 합성 단계에서 하나를 선택하기 전까지 ansatz는 이 상태로 남아 있습니다.
각 층은 로 끝나고 다음 층은 로 시작하므로, 인접한 OrbitalRotation Gate들은 하나의 회전으로 병합할 수 있습니다. 이러한 융합을 수행하는 트랜spile 패스는 향후 개발 계획에 있습니다.
3. 페르미온-큐비트 인코딩 선택
회로는 여전히 페르미온 회로이며, 바로 이 지점에서 이 패키지가 워크플로에서 제 역할을 합니다. FermionicCircuit은 모드가 어떻게 큐비트가 되는지에 대한 가정이 없으므로, 인코딩은 ansatz에 내장된 것이 아니라 합성 단계의 선택입니다. 이것이 Jordan-Wigner 변환에 특화된 ffsim 자체 Qiskit Gate 대비 이 패키지가 더하는 점입니다.
Jordan-Wigner만 필요하다면 이렇게 우회할 필요가 없습니다. ffsim은 UCJOpSpinBalancedJW와 그 계열 클래스를 제공하여 UCJ 연산자를 단독으로 큐비트 회로로 바꿀 수 있습니다. ansatz를 페르미온 회로를 거치게 하는 이유는 인코딩이 제공할 수 있는 그 밖의 모든 것 때문입니다. 예를 들어 국소 인코딩은 추가 큐비트를 사용해 각 항의 Pauli 무게를 제한하며, 1D 및 2D 플로 집합 가이드는 이를 활용해 Trotter 단계의 2큐비트 깊이를 시스템 크기와 무관하게 만듭니다.
UCJ ansatz의 경우, 합성 단계는 두 종류의 Gate를 다뤄야 합니다.
-
대각 쿨롱 발전.
Evolution은 이미 인코딩에 구애받지 않습니다.MapperFnEvolutionSynthesis가 매퍼 함수를 받으므로, 층은 매퍼 함수로 표현할 수 있는 어떤 인코딩으로든 내려갑니다. 플로 집합 가이드에서 매퍼 함수를 작성하는 방법을 보여 줍니다. -
오비탈 회전과 Slater 행렬식 준비.
OrbitalRotation도, 선두의InitializeModes와 회전이 융합되어 만들어지는(아래 참고)PrepareSlaterDeterminant도 그 자체로는 큐비트에 매핑되지 않습니다.F2FSynthesis패스가 먼저 이들을 페르미온 공간에서 각각 하나 또는 두 모드에 대한EvolutionGate(그리고 준비의 경우 기준 상태의InitializeModes)로 분해하므로,Evolution을 매핑할 수 있는 인코딩이라면 모두 이를 처리할 수 있습니다. Jordan-Wigner에서는 인접한 모드 사이의 인자가 큐비트 단계에서XXPlusYYGate객체가 됩니다. -
초기화.
InitializeModes용 플러그인은 인코딩으로 매개변수화되어 있지 않습니다. 모드와 큐비트가 1대1로 대응하는 점유 기저 인코딩을 가정한다고 문서화되어 있으며, 그 기저에서 직접 Gate를 내보냅니다. 다른 인코딩에는 전용 플러그인이 필요하지만 아직 제공되는 것은 없습니다.
Jordan-Wigner가 아닌 인코딩에서 UCJ 회로를 트랜spile하는 방법은 아직 열린 연구 과제이며, 이 패키지는 그러한 파이프라인을 개발할 수 있는 프레임워크를 제공합니다. 이 가이드의 나머지 부분에서는 예시로 generate_preset_jw_pass_manager()가 만드는 것과 동등한, Jordan-Wigner 인코딩용 트랜spile 파이프라인을 구성합니다.
4. Jordan-Wigner를 통해 내리기
내리는 작업은 F2QSynthesis에서 일어나며, Qiskit의 HighLevelSynthesis처럼 동작합니다. 페르미온 명령어를 순회하며 각각을 해당 Gate 이름에 등록된 플러그인에 넘깁니다. F2QSynthesis.methods 속성은 Gate 이름마다 F2QSynthesisPlugin을 하나씩 가지므로, 이 단계를 만든다는 것은 회로에 포함된 모든 페르미온 Gate에 대해 플러그인을 선택한다는 의미입니다.
>>> from qiskit_fermions.mappers.library import jordan_wigner
>>> from qiskit_fermions.transpiler.passes import F2QSynthesis
>>> from qiskit_fermions.transpiler.passes.synthesis import (
...     MapperFnEvolutionSynthesis,
...     TrivialOccupationInitializeModesSynthesis,
... )
>>>
>>> synthesis = F2QSynthesis()
>>> synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(jordan_wigner)
>>> synthesis.methods["InitializeModes"] = TrivialOccupationInitializeModesSynthesis()
이처럼 인스턴스를 할당하는 방식은 직접 작성한 플러그인을 먼저 어딘가에 등록할 필요 없이 파이프라인에 넣는 방법이기도 합니다.
여기서 인코딩이 확정되며, 3절에서 설명한 두 가지 방식으로 이루어집니다. 명시적으로는 jordan_wigner()를 MapperFnEvolutionSynthesis에 전달하는 것이고, 암묵적으로는 다른 플러그인이 이미 이를 가정하고 있는 것입니다.
이 단계는 고정된 순서로 실행되는 단계들로 구성된 MultiStagePassManager에 들어갑니다.
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit.transpiler import generate_preset_pass_manager
>>> from qiskit.transpiler.passes.synthesis.high_level_synthesis import HLSConfig
>>>
>>> from qiskit_fermions.transpiler import (
...     FermionicCircuitToDAG,
...     FermionicPassManager,
...     QuantumDAGToCircuit,
... )
>>> from qiskit_fermions.transpiler.passes import (
...     F2FSynthesis,
...     HopEvolutionSynthesis,
...     MergeOrbitalRotations,
...     MergeSlaterDeterminantPreparation,
...     TrivialF2QLayout,
... )
>>>
>>> pm = MultiStagePassManager(
...     input=FermionicCircuitToDAG(),
...     optimization=FermionicPassManager(
...         [
...             MergeOrbitalRotations(),
...             MergeSlaterDeterminantPreparation(),
...             F2FSynthesis(
...                 {"OrbitalRotation": "Givens", "PrepareSlaterDeterminant": "Givens"}
...             ),
...         ]
...     ),
...     layout=FermionicPassManager(TrivialF2QLayout()),
...     synthesis=synthesis,
...     qubit=generate_preset_pass_manager(
...         hls_config=HLSConfig(PauliEvolution=[HopEvolutionSynthesis(), "default"])
...     ),
...     output=QuantumDAGToCircuit(),
... )
최적화 단계는 합성 이전에 페르미온 회로에서 실행되며, 바로 이 점이 이 단계의 가치입니다. Gate가 아직 페르미온 상태이고 인코딩에 구애받지 않을 때 다시 쓰므로, 절감 효과가 이후의 어떤 인코딩에도 이어집니다. MergeOrbitalRotations는 연속된 OrbitalRotation Gate의 각 구간을 하나로 합치며, 모든 층이 로 끝나고 다음 층이 로 시작하는 UCJ ansatz에서 이것이 중요합니다. 그다음 MergeSlaterDeterminantPreparation이 선두의 InitializeModes와 그 뒤의 회전을 하나의 PrepareSlaterDeterminant로 융합하고, 합성은 이를 전체 정사각 회전 대신 더 저렴한 축소 Slater 분해로 내립니다. 순서가 중요합니다. 회전을 먼저 병합하면 초기화 바로 뒤에 단일 회전이 드러나고, Slater 융합이 이를 거기에 흡수합니다. F2FSynthesis는 남아 있는 회전을 분해하므로 마지막에 옵니다. 더 일찍 실행하면 두 병합 패스가 융합할 것이 남지 않게 됩니다.
나머지 단계는 배관 역할입니다. input과 output은 회로와 DAG 사이를 변환하고, layout은 페르미온 모드를 큐비트에 할당하며(TrivialF2QLayout은 모드 i를 큐비트 i에 매핑합니다), qubit은 페르미온 요소가 더 이상 남지 않았을 때 넘겨받는 일반 Qiskit 패스 매니저입니다.
실행하려면 준비 단계가 하나 필요합니다. 복합 UCJ Gate를 먼저 기본 Gate로 분해해야 최적화 단계에서 개별 회전과 발전을 볼 수 있습니다.
>>> transpiled = pm.run(circuit.decompose())
>>> print(dict(sorted(transpiled.count_ops().items())))
{'rz': 14, 'rzz': 12, 'x': 2, 'xx_plus_yy': 28}
대상 디바이스가 없으면 전연결(all-to-all)을 가정하고 2 * norb개의 큐비트에 매핑됩니다. 오비탈 회전은 XXPlusYYGate객체로, 대각 쿨롱 발전은 RZZGate객체로 합성됩니다.
>>> transpiled.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
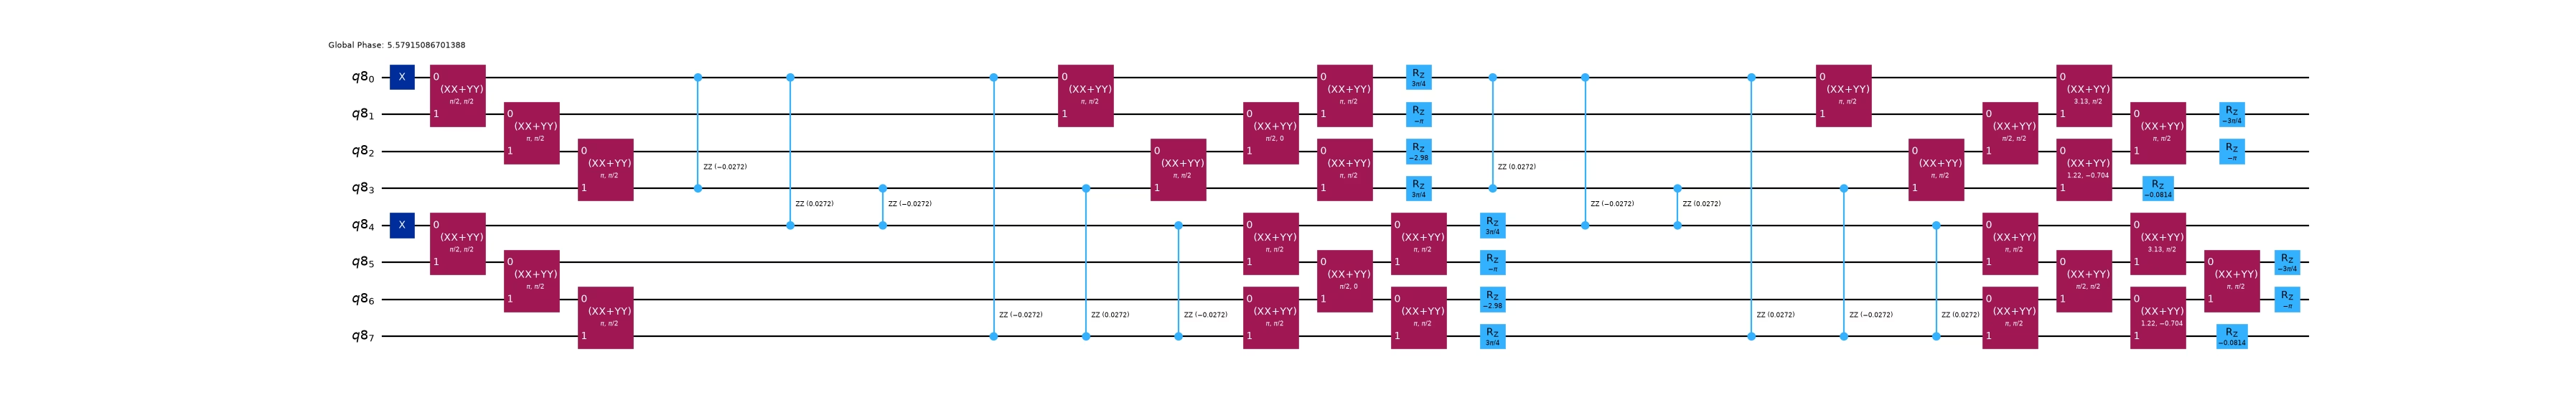
이 파이프라인은 generate_preset_jw_pass_manager()가 조립하는 것과 정확히 같으므로, 실제로는 프리셋을 사용하고 단계 중 하나를 바꿔야 할 때 직접 단계를 구성하세요.
>>> from qiskit_fermions.transpiler.presets import generate_preset_jw_pass_manager
>>>
>>> preset = generate_preset_jw_pass_manager()
>>> preset.run(circuit.decompose()).count_ops() == transpiled.count_ops()
True
5. 디바이스 토폴로지에 맞추기
실제 디바이스는 제한된 큐비트 커플링 맵을 가지며, LUCJ ansatz는 이에 맞도록 설계되어 있습니다. 같은 스핀(pairs_aa) 상호작용은 두 개의 선형 체인을 이루고, 알파-베타(pairs_ab) 상호작용은 이들을 잇는 다리가 됩니다. ffsim의 generate_lucj_pass_manager()는 이 구조를 위한 디바이스 인식 큐비트 파이프라인을 만들고, 하드웨어가 실제로 수용할 수 있는 pairs_ab의 부분집합을 반환합니다. 이 패키지 자체의 페르미온-큐비트 합성은 유지한 채, 그 파이프라인을 프리셋의 qubit 단계에 끼워 넣습니다.
>>> from ffsim.qiskit import generate_lucj_pass_manager
>>> from qiskit.providers.fake_provider import GenericBackendV2
>>> from qiskit.transpiler import CouplingMap
>>>
>>> # a heavy-hex device coupling map (any BackendV2 works, e.g. a real fake_provider backend)
>>> coupling_map = CouplingMap.from_heavy_hex(5)
>>> backend = GenericBackendV2(
...     num_qubits=coupling_map.size(),
...     basis_gates=["cp", "xx_plus_yy", "p", "x", "swap"],
...     coupling_map=coupling_map,
... )
>>>
>>> # nearest-neighbor same-spin chain; let the pass manager choose the alpha-beta pairs
>>> pairs_aa = [(p, p + 1) for p in range(norb - 1)]
>>>
>>> pm = generate_preset_jw_pass_manager()
>>> hls_config = HLSConfig(PauliEvolution=[HopEvolutionSynthesis(), "default"])
>>> pm.qubit, allowed_pairs_ab = generate_lucj_pass_manager(
...     backend,
...     norb,
...     "heavy-hex",
...     (pairs_aa, None),
...     optimization_level=3,
...     seed_transpiler=0,
...     hls_config=hls_config,
... )
>>>
>>> # the alpha-beta interactions the heavy-hex connectivity can implement
>>> print(allowed_pairs_ab)
[(0, 0)]
이 구성이 핵심입니다. qubit 단계는 디바이스를 인식하는 반면, 그 앞의 페르미온-큐비트 합성 단계는 이 패키지 자체의 것으로 남으므로 교체할 수 있습니다. qubit 단계를 교체하면 프리셋이 거기에 등록해 둔 것, 즉 오비탈 회전의 Givens 인자를 XXPlusYYGate객체로 바꾸는 HopEvolutionSynthesis가 사라집니다. 위와 같이 hls_config를 통해 전달하거나, 그것 없이 디바이스의 기저에 도달해야 합니다.
이제 pm.qubit이 디바이스 인식 파이프라인으로 설정되었으므로, 패스 매니저를 실행하면 회로를 백엔드의 큐비트에 배치하고 커플링 맵에 맞게 라우팅합니다. 1단계의 제한 없는 ansatz는 대각 쿨롱 연산자에 하드웨어가 직접 도달할 수 없는 알파-베타 항이 여전히 있으므로, 라우터가 이를 잇기 위해 많은 SWAP Gate를 삽입해야 합니다.
>>> naive = pm.run(circuit.decompose())
>>> naive.num_qubits  # laid out on the full heavy-hex device register
57
>>> naive_swaps = naive.count_ops()["swap"]
>>> naive_swaps  # many SWAPs to bridge the unreachable alpha-beta interactions
33
ansatz를 하드웨어에서 구현 가능한 상호작용으로 제한하기
해결책은 allowed_pairs_ab를 ansatz 구성에 다시 넣는 것입니다. from_t_amplitudes()의 interaction_pairs 인수를 통해 전달하면, 대각 쿨롱 연산자에는 커플링 맵이 직접 구현할 수 있는 알파-베타 항만 포함됩니다. 그러면 ansatz가 디바이스 토폴로지에 맞게 되어 라우터가 거의 손댈 필요가 없습니다.
>>> restricted = UCJ(
...     ffsim.UCJOpSpinBalanced.from_t_amplitudes(
...         t2, t1=t1, n_reps=2, interaction_pairs=(pairs_aa, allowed_pairs_ab)
...     )
... )
>>>
>>> circuit = FermionicCircuit(2 * norb)
>>> circuit.append(InitializeModes.from_hartree_fock(norb, nelec), circuit.modes)
>>> circuit.append(restricted, circuit.modes)
>>>
>>> transpiled = pm.run(circuit.decompose())
>>> restricted_swaps = transpiled.count_ops()["swap"]
>>> restricted_swaps  # far fewer routing SWAPs than the unrestricted ansatz
4
활성 큐비트만 그리면(idle_wires=False) 두 스핀 체인과 알파-베타 다리로 제한된 회로가 디바이스 기저 Gate로 표현되어 나타납니다. 레이아웃과 라우팅은 논리 모드를 디바이스의 물리 큐비트에 흩어 놓으므로, 회로의 최종 레이아웃에서 가져온 wire_order를 전달하여(final_index_layout()은 각 입력 큐비트가 위치한 물리 큐비트를 입력 큐비트 순서대로 나열합니다) 와이어를 원래 모드 순서로 되돌려 그립니다.
>>> wire_order = transpiled.layout.final_index_layout(filter_ancillas=False)
>>> transpiled.draw("mpl", idle_wires=False, fold=-1, wire_order=wire_order)
<Figure size ... with 1 Axes>
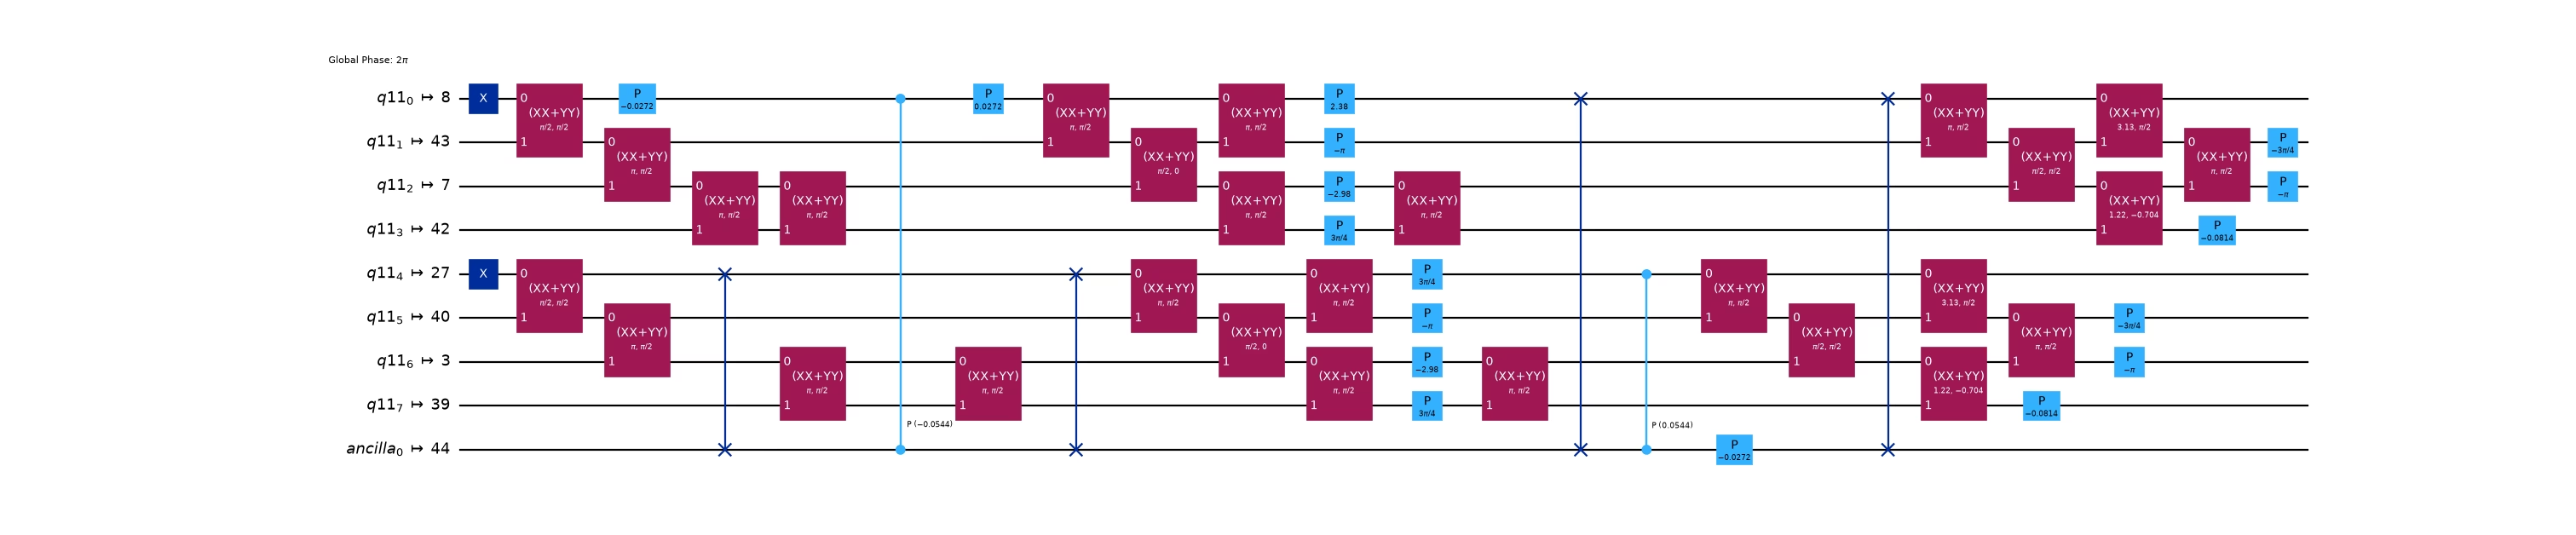
레이아웃 이후의 정확한 Gate 수와 깊이는 라우팅/최적화 패스와 선택한 디바이스에 따라 달라지므로 여기서는 제시하지 않습니다. 핵심은 공동 설계입니다. 최근접 이웃 pairs_aa 체인과 하드웨어로 걸러낸 pairs_ab 다리로 ansatz를 표현하면 합성된 회로가 디바이스 토폴로지에 가깝게 유지되어 라우팅 오버헤드(삽입되는 SWAP Gate)가 최소화됩니다. 2큐비트 Gate 수와 라우팅 후 깊이 사이의 균형을 맞추는 관련 합성 선택(minimize_2q_gate_count)은 FermionicSlaterGivensDecomposition을 참고하세요.
다음 단계
-
개별 Gate의 동작 방식은
qiskit_fermions.circuit.library문서와 페르미온 회로 가이드에서 알아보세요. -
페르미온 연산자와 해밀토니안을 직접 구성하는 방법은 연산자 설명 가이드에서 살펴보세요.
-
페르미온 회로가 큐비트에 매핑되는 방식은 트랜spile 가이드에서 확인하세요.
-
합성 단계를 구성하는 다른 방법은
F2QSynthesis문서를 읽어 보세요. 인스턴스가 아니라qiskit_fermions.transpiler.synthesis엔트리 포인트에 등록된 짧은 이름으로 플러그인을 선택하는config딕셔너리를 사용하는 방법입니다. -
두 패키지가 작업을 어떻게 나누는지, 그리고 어떤 프로토콜로 ffsim이 이 패키지의 회로를 시뮬레이션할 수 있는지는 ffsim 관계 가이드를 읽어 보세요.