Optimization Solver: A Qiskit Function by Q-CTRL Fire Opal
API 참조를 참조하세요
Qiskit Functions는 IBM Quantum® Premium Plan, Flex Plan, On-Prem(IBM Quantum Platform API 경유) Plan 사용자에게만 제공되는 실험적 기능입니다. 현재 미리 보기 출시 상태이며, 변경될 수 있습니다.
Package versions
이 페이지의 코드는 다음 요구 사항을 사용하여 개발되었습니다. 이 버전 이상을 사용하길 권장합니다.
qiskit-ibm-runtime~=0.47.0
sympy~=1.14.0
개요
Fire Opal Optimization Solver를 사용하면 양자 전문 지식 없이도 양자 하드웨어에서 유틸리티 규모의 최적화 문제를 해결할 수 있습니다. 고수준 문제 정의를 입력하기만 하면 Solver가 나머지를 처리합니다. 전체 워크플로는 노이즈를 인식하며, 내부적으로 Fire Opal의 성능 관리를 활용합니다. Solver는 가장 큰 IBM® QPU에서 전체 디바이스 규모로도 고전적으로 어려운 문제에 대해 지속적으로 정확한 해를 제공합니다.
Solver는 유연하며, 목적 함수 또는 임의의 그래프로 정의된 조합 최적화 문제를 푸는 데 사용할 수 있습니다. 문제를 디바이스 토폴로지에 매핑할 필요가 없습니다. 비제약 문제와 제약 문제 모두 풀 수 있으며, 제약 조건이 패널티 항이 아닌 하드 Hamming-weight-1 제약으로 적용됩니다. 이 가이드에 포함된 예시는 서로 다른 Solver 입력 유형을 사용하여 비제약 및 제약 유틸리티 규모 최적화 문제를 푸는 방법을 보여줍니다. 첫 번째 예시는 156개 노드의 3-정규 그래프에서 정의된 max-cut 문제이며, 두 번째 예시는 비용 함수로 정의된 50개 노드의 그래프 분할 문제입니다.
Optimization Solver에 대한 접근 권한을 얻으려면 Q-CTRL에 문의하세요.
함수 설명
Solver는 하드웨어 수준의 오류 억제부터 효율적인 문제 매핑 및 폐루프 고전 최적화까지 전체 알고리즘을 완전히 최적화하고 자동화합니다. 내부적으로 Solver의 파이프라인은 모든 단계에서 오류를 줄여, 의미 있는 확장에 필요한 향상된 성능을 가능하게 합니다. 기반 워크플로는 하이브리드 양자-고전 알고리즘인 QAOA(Quantum Approximate Optimization Algorithm)에서 영감을 받았습니다. 전체 Optimization Solver 워크플로에 대한 자세한 요약은 게재된 논문을 참조하세요.

Optimization Solver로 일반 문제를 풀려면:
- 문제를 목적 함수, 그래프, 또는
SparsePauliOp스핀 체인으로 정의합니다. - Qiskit Functions Catalog를 통해 함수에 연결합니다.
- Solver로 문제를 실행하고 결과를 가져옵니다.
허용된 문제 형식
-
목적 함수의 다항식 표현. Python에서 기존 SymPy Poly 객체로 생성하고 sympy.srepr을 사용하여 문자열로 포맷하는 것이 이상적입니다.
-
특정 문제 유형의 그래프 표현입니다. 그래프는 Python에서 networkx 라이브러리를 사용하여 생성해야 합니다. 그런 다음 networkx 함수
nx.readwrite.json_graph.adjacency_data를 사용하여 문자열로 변환해야 합니다. -
특정 문제의 스핀 체인 표현. 스핀 체인은
SparsePauliOp객체로 표현되어야 합니다. 자세한 내용은 문서를 참조하세요.
이 함수가 현재 지원하지 않는 Backend를 사용하려면 Q-CTRL에 문의하여 지원을 추가하세요.
벤치마크
성능은 문제 인스턴스와 이후의 처리 단계 모두에 따라 달라질 수 있습니다. 경우에 따라 고전적 샘플과 양자로 생성된 샘플은 동등한 후처리를 거친 후 유사한 최종 해 품질을 달성할 수 있습니다. 따라서 평가는 전체 최적화 워크플로우를 고려해야 합니다.
게재된 벤치마킹 결과에 따르면 Solver는 120개 이상의 Qubit을 가진 문제를 성공적으로 해결하며, 심지어 양자 어닐링 및 트랩된 이온 디바이스에 대한 이전에 게재된 결과를 능가합니다. 다음 벤치마크 지표는 몇 가지 예시를 기반으로 문제 유형의 정확도 및 확장성에 대한 대략적인 지표를 제공합니다. 실제 지표는 목적 함수의 항 수(밀도) 및 그 지역성, 변수 수, 다항식 차수 등 다양한 문제 특성에 따라 다를 수 있습니다.
표시된 "Qubit 수"는 엄격한 제한이 아니라 매우 일관된 해 정확도를 기대할 수 있는 대략적인 임계값을 나타냅니다. 더 큰 문제 규모도 성공적으로 해결되었으며, 이러한 한계를 넘어서는 테스트를 권장합니다.
임의의 qubit 연결성은 모든 문제 유형에서 지원됩니다.
| 문제 유형 | qubit 수 | 예시 | 정확도 | 총 시간(초) | 런타임 사용량(초) | 반복 횟수 |
|---|---|---|---|---|---|---|
| 희소 연결 이차 문제 | 156 | 3-정규 max-cut | 100% | 1764 | 293 | 16 |
| 고차 이진 최적화 | 156 | Ising 스핀 유리 모델 | 100% | 1461 | 272 | 16 |
| 밀집 연결 이차 문제 | 50 | 완전 연결 max-cut | 100% | 1758 | 268 | 12 |
| 하드 제약이 있는 제약 문제 | 50 | 8% 엣지 밀도의 가중 그래프 분할 | 100% | 1074 | 215 | 10 |
시작하기
먼저 IBM Quantum API 키를 사용하여 인증하세요. 그런 다음 아래와 같이 Qiskit Function을 선택합니다. (이 코드 조각은 이미 계정을 저장한 것을 가정합니다.)
# Added by doQumentation — required packages for this notebook
!pip install -q networkx numpy qiskit-ibm-catalog qiskit-ibm-runtime sympy
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
solver = catalog.load("q-ctrl/optimization-solver")
예시: 비제약 최적화
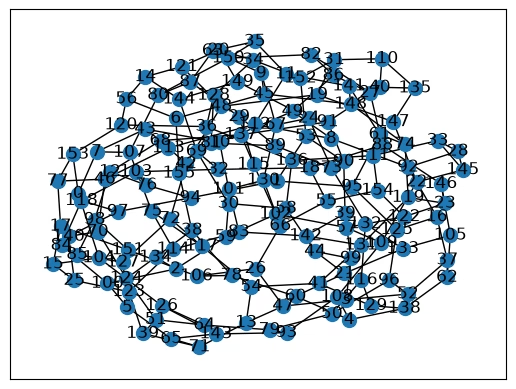
최대 컷 (Max-Cut) 문제를 실행합니다. 다음 예시는 156개 노드의 3-정규 비가중 그래프 Max-Cut 문제에서 Solver의 기능을 보여주지만, 가중 그래프 문제도 풀 수 있습니다.
qiskit-ibm-catalog 외에도 이 예시를 실행하려면 networkx와 numpy 패키지가 필요합니다. IPython 커널을 사용하는 노트북에서 이 예시를 실행하는 경우, 다음 셀의 주석을 해제하여 이 패키지들을 설치할 수 있습니다.
# %pip install networkx numpy
1. 문제 정의
그래프 문제를 정의하고 problem_type='maxcut'을 지정하여 Max-Cut 문제를 실행할 수 있습니다.
import networkx as nx
import numpy as np

# Generate a random graph with 156 nodes
maxcut_graph = nx.random_regular_graph(d=3, n=156, seed=8)
# Optionally, visualize the graph
nx.draw_networkx(
    maxcut_graph, nx.kamada_kawai_layout(maxcut_graph), node_size=100
)
Solver는 문자열을 문제 정의 입력으로 받습니다.
# Convert graph to string
problem_as_str = nx.readwrite.json_graph.adjacency_data(maxcut_graph)
2. 문제 실행
그래프 기반 입력 방법을 사용할 때는 문제 유형을 지정하세요.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy(n_qubits=156).name
# Solve the problem
maxcut_job = solver.run(
    problem=problem_as_str,
    problem_type="maxcut",
    backend_name=backend_name,  # E.g. "ibm_fez"
)
다음과 같이 Qiskit Function 워크로드의 상태를 확인하거나 결과를 가져올 수 있습니다:
# Print the ID so you can use it later, if necessary
print(maxcut_job.job_id)

# Get job status
print(maxcut_job.status())
34b53970-d95a-4e24-8763-fc6f3d112843
QUEUED
3. 결과 가져오기
결과 딕셔너리에서 최적 컷 값을 가져옵니다.
변수와 비트스트링 간의 매핑이 변경되었을 수 있습니다. 출력 딕셔너리에는 순서를 확인하는 데 도움이 되는 variables_to_bitstring_index_map 하위 딕셔너리가 포함되어 있습니다.
# Poll for results
maxcut_result = maxcut_job.result()

# Take the absolute value of the solution since the cost function is minimized
qctrl_maxcut = abs(maxcut_result["solution_bitstring_cost"])

# Print the optimal cut value found by the Optimization Solver
print(f"Optimal cut value: {qctrl_maxcut}")
Optimal cut value: 210.0
그래프가 밀집 연결되어 있지 않은 경우 PuLP와 같은 오픈 소스 솔버로 문제를 고전적으로 풀어 결과의 정확도를 확인할 수 있습니다. 밀도가 높은 문제는 해를 검증하는 데 고급 고전 솔버가 필요할 수 있습니다.
예시: 제약 최적화
이전의 최대 컷(max-cut) 예제는 흔히 볼 수 있는 이차 무제약 이진 최적화 문제입니다. Q-CTRL의 Optimization Solver는 목적 함수에 페널티 항으로 인코딩하는 대신 constraint 입력을 통해 하드 제약 조건을 Solver에 직접 전달함으로써 제약 최적화 문제도 해결할 수 있습니다. Solver는 현재 해밍 가중치 1 제약 조건을 지원합니다. 각 제약 조건은 정확히 하나의 변수가 1이 되어야 하고 나머지는 0이 되어야 하는 변수 그룹을 지정합니다.
다음 예제는 그래프 분할이라는 제약 최적화 문제에 대한 비용 함수와 하드 제약 조건 집합을 구성하는 방법을 보여줍니다. 이는 그래프의 모든 노드를 여러 그룹 중 정확히 하나에 할당하면서, 양 끝점이 같은 그룹에 속하는 간선의 총 가중치를 최소화하는 것입니다.
qiskit-ibm-catalog 및 qiskit 패키지 외에도, 이 예제를 실행하려면 numpy, networkx, sympy 패키지도 사용합니다. IPython 커널을 사용하는 노트북에서 이 예제를 실행하는 경우, 다음 셀의 주석을 해제하여 이 패키지들을 설치할 수 있습니다.
# %pip install numpy networkx sympy
1. 문제 정의
무작위로 가중된 노드를 가진 그래프를 생성하여 무작위 그래프 분할 문제를 정의합니다.
import networkx as nx
from sympy import Symbol, Poly, srepr

# To change the weights, change the seed to any integer.
rng_seed = 18
_rng = np.random.default_rng(rng_seed)
node_count = 50
edge_probability = 0.08
graph = nx.erdos_renyi_graph(
    node_count, edge_probability, seed=rng_seed, directed=False
)

# add node weights
min_weight = -1.0
max_weight = 1.0
for i in graph.nodes:
    weight = (max_weight - min_weight) * _rng.random() + min_weight
    graph.add_node(i, weight=weight)

# Optionally, visualize the graph
nx.draw_networkx(graph, nx.kamada_kawai_layout(graph), node_size=200)
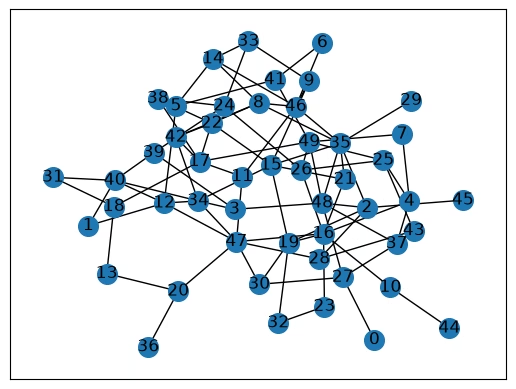
가중 그래프 분할에 대한 표준 최적화 모델은 다음과 같이 공식화할 수 있습니다. 그래프의 노드를 세 그룹 로 나누고, 노드 가 그룹 에 할당되면 , 그렇지 않으면 이라고 합니다. 목표는 양 끝점이 같은 그룹에 할당된 간선의 총 가중치를 최소화하는 것이며, 간선 의 가중치는 두 끝점의 결합 가중치인 입니다.
# Construct the cost function.
group_count = 3
variables = [
    Symbol(f"n[{i},{g}]")
    for i in range(node_count)
    for g in range(group_count)
]
node_group_var = {
    (i, g): variables[i * group_count + g]
    for i in range(node_count)
    for g in range(group_count)
}
cost_function = Poly(0, *variables)

for i, j in graph.edges():
    edge_weight = graph.nodes[i]["weight"] + graph.nodes[j]["weight"]
    for g in range(group_count):
        cost_function += (
            edge_weight * node_group_var[(i, g)] * node_group_var[(j, g)]
        )
모든 노드는 세 그룹 중 정확히 하나에 할당되어야 합니다. 이는 해밍 가중치 1 제약 조건입니다. 모든 노드 에 대해 중 정확히 하나가 1이 되어야 하고 나머지는 0이 되어야 합니다.
이 요구 사항을 비용 함수의 페널티 항으로 인코딩하는 대신, constraint 입력을 사용하여 하드 제약 조건으로 Solver에 직접 전달합니다.
# Build the hard constraint: exactly one group per node.
constraint_dict = {
    str(tuple(f"n[{i},{g}]" for g in range(group_count))): 1
    for i in range(node_count)
}
print(f"Problem constraints: {constraint_dict}")
Problem constraints: {"('n[0,0]', 'n[0,1]', 'n[0,2]')": 1, "('n[1,0]', 'n[1,1]', 'n[1,2]')": 1, "('n[2,0]', 'n[2,1]', 'n[2,2]')": 1, "('n[3,0]', 'n[3,1]', 'n[3,2]')": 1, "('n[4,0]', 'n[4,1]', 'n[4,2]')": 1, "('n[5,0]', 'n[5,1]', 'n[5,2]')": 1, "('n[6,0]', 'n[6,1]', 'n[6,2]')": 1, "('n[7,0]', 'n[7,1]', 'n[7,2]')": 1, "('n[8,0]', 'n[8,1]', 'n[8,2]')": 1, "('n[9,0]', 'n[9,1]', 'n[9,2]')": 1, "('n[10,0]', 'n[10,1]', 'n[10,2]')": 1, "('n[11,0]', 'n[11,1]', 'n[11,2]')": 1, "('n[12,0]', 'n[12,1]', 'n[12,2]')": 1, "('n[13,0]', 'n[13,1]', 'n[13,2]')": 1, "('n[14,0]', 'n[14,1]', 'n[14,2]')": 1, "('n[15,0]', 'n[15,1]', 'n[15,2]')": 1, "('n[16,0]', 'n[16,1]', 'n[16,2]')": 1, "('n[17,0]', 'n[17,1]', 'n[17,2]')": 1, "('n[18,0]', 'n[18,1]', 'n[18,2]')": 1, "('n[19,0]', 'n[19,1]', 'n[19,2]')": 1, "('n[20,0]', 'n[20,1]', 'n[20,2]')": 1, "('n[21,0]', 'n[21,1]', 'n[21,2]')": 1, "('n[22,0]', 'n[22,1]', 'n[22,2]')": 1, "('n[23,0]', 'n[23,1]', 'n[23,2]')": 1, "('n[24,0]', 'n[24,1]', 'n[24,2]')": 1, "('n[25,0]', 'n[25,1]', 'n[25,2]')": 1, "('n[26,0]', 'n[26,1]', 'n[26,2]')": 1, "('n[27,0]', 'n[27,1]', 'n[27,2]')": 1, "('n[28,0]', 'n[28,1]', 'n[28,2]')": 1, "('n[29,0]', 'n[29,1]', 'n[29,2]')": 1, "('n[30,0]', 'n[30,1]', 'n[30,2]')": 1, "('n[31,0]', 'n[31,1]', 'n[31,2]')": 1, "('n[32,0]', 'n[32,1]', 'n[32,2]')": 1, "('n[33,0]', 'n[33,1]', 'n[33,2]')": 1, "('n[34,0]', 'n[34,1]', 'n[34,2]')": 1, "('n[35,0]', 'n[35,1]', 'n[35,2]')": 1, "('n[36,0]', 'n[36,1]', 'n[36,2]')": 1, "('n[37,0]', 'n[37,1]', 'n[37,2]')": 1, "('n[38,0]', 'n[38,1]', 'n[38,2]')": 1, "('n[39,0]', 'n[39,1]', 'n[39,2]')": 1, "('n[40,0]', 'n[40,1]', 'n[40,2]')": 1, "('n[41,0]', 'n[41,1]', 'n[41,2]')": 1, "('n[42,0]', 'n[42,1]', 'n[42,2]')": 1, "('n[43,0]', 'n[43,1]', 'n[43,2]')": 1, "('n[44,0]', 'n[44,1]', 'n[44,2]')": 1, "('n[45,0]', 'n[45,1]', 'n[45,2]')": 1, "('n[46,0]', 'n[46,1]', 'n[46,2]')": 1, "('n[47,0]', 'n[47,1]', 'n[47,2]')": 1, "('n[48,0]', 'n[48,1]', 'n[48,2]')": 1, "('n[49,0]', 'n[49,1]', 'n[49,2]')": 1}
모든 변수를 constraint에 추가할 필요는 없습니다. 딕셔너리에서 제외된 변수는 제약이 없는 상태로 남으므로, 같은 문제 안에서 하드 제약이 있는 변수 그룹과 자유 변수를 혼합할 수 있습니다.
2. 문제 실행
# Solve the problem
partition_job = solver.run(
    problem=srepr(cost_function),
    constraint=constraint_dict,
    backend_name="ibm_marrakesh",  # E.g. "ibm_marrakesh"
)
다음과 같이 Qiskit Function 워크로드의 상태를 확인하거나 결과를 가져올 수 있습니다:
# Print the ID so you can use it later, if necessary
print(partition_job.job_id)

# Get job status
print(partition_job.status())
b8085944-f313-444e-be39-ea61b1b47ebd
QUEUED
3. 결과 가져오기
해를 검색하고 결과를 분석하세요. 해의 비용은 양 끝점이 같은 그룹에 속하게 된 간선의 총 가중치를 나타내므로, 비용이 낮을수록 그래프 분할이 더 우수함을 의미합니다.
partition_result = partition_job.result()
qctrl_cost = partition_result["solution_bitstring_cost"]
solution_bitstring = partition_result["solution_bitstring"]

# Print results
print(f"Total weight of same-group edges: {qctrl_cost}")
print(f"Solution bitstring: {solution_bitstring}")
Total weight of same-group edges: -36.5539
Solution bitstring: 100100100100100001100100100100100100100100100100100001010100010100100100100010001001100100100001100001100001010001001010100100100100100010100100100100
지원 받기
질문이나 문제가 있으면 Q-CTRL에 문의하세요.
Changelog
-
2026-08-10:
constraint입력을 통해 하드(해밍 가중치 1) 제약 조건에 대한 지원이 추가되었으며, 제약 최적화 예제가 이를 사용하도록 업데이트되었습니다. -
2026-02-11:
ibm_miami지원이 추가되었습니다.
다음 단계
-
Q-CTRL Optimization Solver에 대한 접근 권한을 요청하세요.
-
이 Qiskit Function의 API 참조를 방문하세요.
-
Q-CTRL의 Optimization Solver로 고차 이진 최적화 문제 풀기 튜토리얼을 시도해 보세요.
-
Mazda 사례 연구를 검토하세요.
-
Network Rail 사례 연구를 검토하세요.
-
Australian Army 사례 연구를 검토하세요.
-
Transport for New South Wales 사례 연구를 검토하세요.