주기적 경계 조건을 위한 Circuit Cutting
사용량 예상: ibm_boston에서 2분 (참고: 이 값은 추정치이며, 실제 실행 시간은 다를 수 있습니다.)
학습 목표
-
가상 연결을 사용하여 경계 게이트를 라우팅하지 않고 주기적 체인을 트랜스파일합니다.
-
해당 게이트를 회로 컷팅 실험으로 대체하고 Sampler 결과로부터 기댓값을 재구성합니다.
-
회로 깊이와 샘플링 비용을 고려하여 컷팅한 회로와 컷팅하지 않은 회로를 비교합니다.
사전 요구 사항
Qiskit 패턴, 트랜스파일, Sampler 프리미티브에 익숙해야 합니다.
배경
주기적 경계 조건은 체인의 마지막 큐비트를 첫 번째 큐비트에 연결합니다. 이 큐비트들이 양자 프로세서에서 멀리 떨어져 있으면, 둘의 상호작용을 구현하기 위해 라우팅이 필요하며, 이로 인해 2-큐비트 게이트가 늘어나고 회로 깊이가 증가할 수 있습니다.
게이트 컷팅은 2-큐비트 게이트를 단일 큐비트 연산과 측정의 가중 조합으로 대체합니다. 이러한 실험을 실행하고 그 결과를 결합하면 원래 회로의 기댓값을 재구성할 수 있습니다. 이렇게 하면 추가 샘플링이 필요한 대신 라우팅 오버헤드를 줄일 수 있습니다. 기반이 되는 준확률 분해에 대해서는 회로 컷팅 설명을 참조하세요.
먼저 6-큐비트 무잡음 시뮬레이터에서 이 워크플로를 검증합니다. 그런 다음 하드웨어에서 30큐비트 이상의 체인에 적용하고 컷팅한 결과와 컷팅하지 않은 결과를 비교합니다. 이 회로는 기댓값을 해석적으로 알 수 있는 매개변수를 사용하므로, 하드웨어 비교에 대규모 상태 벡터 시뮬레이션이 필요하지 않습니다.
요구 사항
이 튜토리얼을 시작하기 전에 다음을 설치하세요:
-
Qiskit SDK v2.3 이상, 시각화 지원 포함
-
Qiskit Runtime v0.46 이상 (
pip install 'qiskit-ibm-runtime~=0.46.1') -
Circuit cutting Qiskit 애드온 v0.10.0 (
pip install 'qiskit-addon-cutting~=0.10.0') -
Qiskit Aer v0.17.2 이상 (
pip install 'qiskit-aer~=0.17.2')
하드웨어 예제에는 120큐비트 이상의 QPU에 접근할 수 있는 IBM Quantum® Platform 계정과 저장된 자격 증명도 필요합니다. 시뮬레이터 예제는 계정 없이 실행됩니다.
설정
두 예제에서 사용하는 도구를 가져옵니다. Aer는 게이트 컷팅이 도입하는 중간 측정을 지원합니다.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_addon_cutting": "qiskit-addon-cutting", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "rustworkx": "rustworkx"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import rustworkx as rx

from qiskit.circuit.equivalence_library import SessionEquivalenceLibrary
from qiskit.circuit.library import n_local
from qiskit.providers.fake_provider import GenericBackendV2
from qiskit.quantum_info import SparsePauliOp, Statevector
from qiskit.result import sampled_expectation_value
from qiskit.transpiler import CouplingMap, PassManager
from qiskit.transpiler.passes import (
    BasisTranslator,
    GateDirection,
    Optimize1qGatesDecomposition,
)
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit_aer.primitives import SamplerV2 as AerSampler
from qiskit_addon_cutting import (
    cut_gates,
    generate_cutting_experiments,
    reconstruct_expectation_values,
)
from qiskit_ibm_runtime import (
    Batch,
    QiskitRuntimeService,
    SamplerOptions,
    SamplerV2,
)
소규모 시뮬레이터 예제
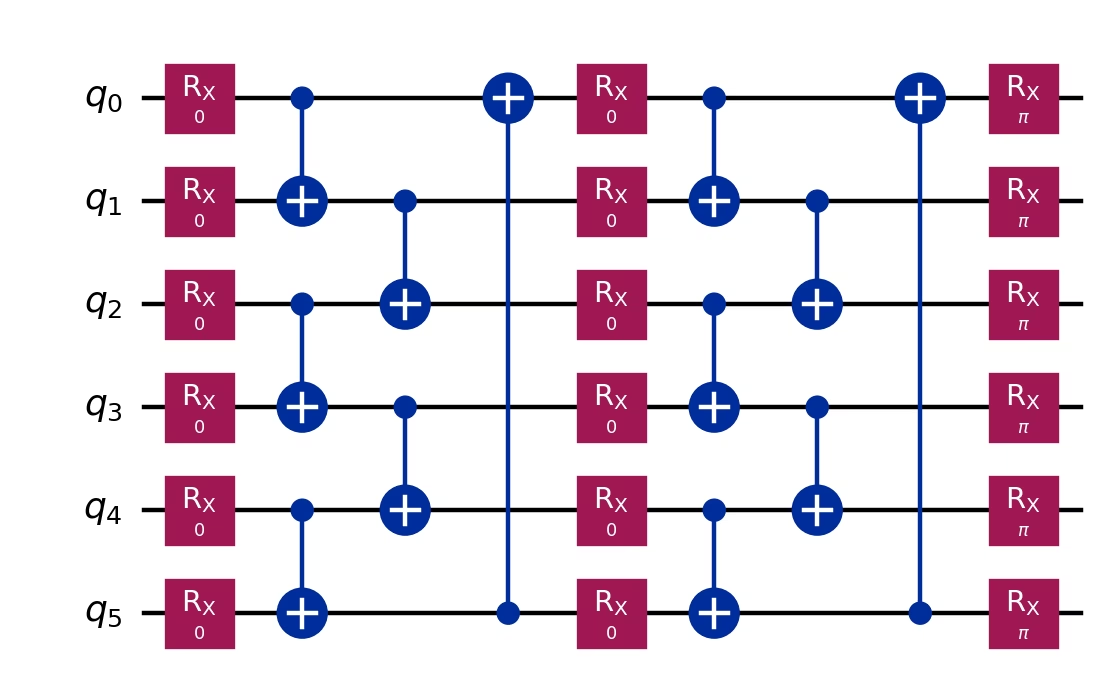
얽힘 게이트 층이 두 개인 6-큐비트 링을 사용합니다. 시뮬레이션되는 장치는 선형 연결성을 가지므로, 링을 닫는 간선은 컷팅하지 않으면 라우팅이 필요합니다.
1단계: 고전적 입력을 양자 문제로 매핑하기
다음 함수는 링의 번갈아 나타나는 간선에 CX 게이트를 끼워 넣은 RX 회전 층을 만듭니다. 두 번 반복하면 컷팅할 경계 게이트가 두 개 생깁니다. 처음 두 회전 층은 0으로, 마지막 층은 로 설정합니다. 이때 이상적인 출력은 전역 위상을 제외하고 입니다.
주기적 쌍을 포함하여 단일 큐비트 Z 기댓값의 평균과 인접한 ZZ 기댓값의 평균을 측정합니다:
이상적인 값은 각각 과 입니다. 이 매개변수들은 워크플로의 벤치마크를 제공할 뿐, 고전적으로 어려운 계산을 시연하는 것은 아닙니다.
def build_periodic_problem(num_qubits, num_reps=2):
    """Build a periodic benchmark circuit and its Z and ZZ observables."""
    edges = [(i, (i + 1) % num_qubits) for i in range(num_qubits)]
    circuit = n_local(
        num_qubits,
        rotation_blocks="rx",
        entanglement_blocks="cx",
        entanglement=edges[::2] + edges[1::2],
        reps=num_reps,
    )
    parameters = np.zeros(circuit.num_parameters)
    parameters[-num_qubits:] = np.pi
    circuit = circuit.assign_parameters(parameters)

    terms = [("Z", [i], 1) for i in range(num_qubits)]
    terms += [("ZZ", [i, (i + 1) % num_qubits], 1) for i in range(num_qubits)]
    observables = SparsePauliOp.from_sparse_list(terms, num_qubits)
    return circuit, observables

num_qubits = 6
circuit, observables = build_periodic_problem(num_qubits)
ideal_expvals = np.array(
    [
        Statevector(circuit).expectation_value(p).real
        for p in observables.paulis
    ]
)
print("Ideal averages:", ideal_expvals.reshape(2, num_qubits).mean(axis=1))
circuit.draw("mpl", style="iqp", fold=60)
Ideal averages: [-1. 1.]
2단계: 양자 하드웨어 실행을 위한 문제 최적화
선형 커플링 맵을 가진 장치 모델을 만듭니다. 이는 컴파일 대상을 제공하며, 3단계의 실행은 무잡음으로 진행됩니다.
simulation_backend = GenericBackendV2(
    num_qubits=num_qubits,
    basis_gates=["id", "rz", "sx", "x", "cx"],
    coupling_map=CouplingMap.from_line(num_qubits),
    seed=1234,
)
initial_layout = list(range(num_qubits))
체인 양 끝에 있는 물리 Qubit 사이에 가상 연결을 추가합니다. 이렇게 확장한 커플링 맵과 CX 기저를 사용해 한 번 트랜스파일합니다. 가상 연결 덕분에 Transpiler가 경계 Gate를 라우팅하지 않지만, 그 결과로 얻은 Circuit은 아직 실제 장치에서 실행할 수 없습니다.
두 경계 CX Gate를 찾아 절단하고, 관측량에 가상 레이아웃을 적용한 다음, num_samples=np.inf로 모든 분해 항을 생성합니다. 이렇게 하면 분해 계수가 정확해지지만, 측정에는 여전히 유한한 횟수의 shot이 사용됩니다.
마지막으로 실험을 장치의 네이티브 Gate로 변환하고 필요한 경우 방향을 보정합니다. 이 패스들은 물리 Qubit 레이아웃을 유지하며, 실험마다 레이아웃 선택과 라우팅을 반복하지 않도록 해 줍니다. 도우미 함수는 재구성에 필요한 매핑된 관측량을 반환합니다.
def prepare_cut_experiments(circuit, observables, backend, initial_layout):
    """Compile with a virtual edge, cut it, and translate to native gates."""
    boundary = {initial_layout[0], initial_layout[-1]}
    virtual_map = CouplingMap(list(backend.coupling_map.get_edges()))
    virtual_map.make_symmetric()
    virtual_map.add_edge(initial_layout[-1], initial_layout[0])
    virtual_map.add_edge(initial_layout[0], initial_layout[-1])

    virtual_pm = generate_preset_pass_manager(
        optimization_level=1,
        coupling_map=virtual_map,
        basis_gates=["rz", "sx", "x", "cx"],
        initial_layout=initial_layout,
        seed_transpiler=1234,
    )
    virtual_circuit = virtual_pm.run(circuit)
    cut_indices = [
        i
        for i, instruction in enumerate(virtual_circuit.data)
        if instruction.operation.name == "cx"
        and {virtual_circuit.find_bit(q).index for q in instruction.qubits}
        == boundary
    ]
    mapped_observables = observables.apply_layout(virtual_circuit.layout)
    qpd_circuit, bases = cut_gates(virtual_circuit, cut_indices)
    experiments, coefficients = generate_cutting_experiments(
        circuits=qpd_circuit,
        observables=mapped_observables.paulis,
        num_samples=np.inf,
    )
    native_pm = PassManager(
        [
            BasisTranslator(
                SessionEquivalenceLibrary,
                target_basis=backend.operation_names,
                target=backend.target,
            ),
            GateDirection(backend.coupling_map, target=backend.target),
            BasisTranslator(
                SessionEquivalenceLibrary,
                target_basis=backend.operation_names,
                target=backend.target,
            ),
            Optimize1qGatesDecomposition(target=backend.target),
        ]
    )
    isa_experiments = native_pm.run(experiments)
    print(f"Boundary gates cut: {len(cut_indices)}")
    print(f"Number of experiments: {len(isa_experiments)}")
    print(
        f"Sampling overhead: {np.prod([basis.overhead for basis in bases])}"
    )
    return isa_experiments, coefficients, mapped_observables

isa_experiments, coefficients, mapped_observables = prepare_cut_experiments(
    circuit, observables, simulation_backend, initial_layout
)
Boundary gates cut: 2
Number of experiments: 36
Sampling overhead: 81.0
각 CX 분해는 여섯 개의 항으로 이루어집니다. 절단이 두 번이고 Z 측정 기저를 하나로 공유하면 개의 실험이 만들어집니다. 샘플링 오버헤드는 이와 다른 양으로, 분해 계수의 절댓값 합을 제곱한 값이 입니다. 이는 준확률 재구성에서 정밀도를 유지하는 데 드는 샘플링 비용을 나타냅니다. 샘플링 오버헤드 설명을 참고하세요.
비교를 위해 절단하지 않은 Circuit에 측정을 추가한 사본을 실제 커플링 맵으로 트랜스파일합니다. measure_all()은 원래의 논리 Qubit을 meas 레지스터에 기록하며, 트랜스파일은 이 고전 비트 매핑을 보존하므로 그 카운트를 원래 관측량으로 평가할 수 있습니다.
uncut_pm = generate_preset_pass_manager(
    optimization_level=1,
    backend=simulation_backend,
    initial_layout=initial_layout,
    seed_transpiler=1234,
)
isa_uncut = uncut_pm.run(circuit.measure_all(inplace=False))
print("Uncut circuit depth:", isa_uncut.depth())
print("Cut circuit depths:", sorted({qc.depth() for qc in isa_experiments}))
Uncut circuit depth: 15
Cut circuit depths: [6, 7, 8, 9, 10, 11, 12, 15]
3단계: Qiskit 프리미티브를 사용한 실행
두 버전을 모두 Aer Sampler V2 프리미티브로 실행합니다. 절단 실험 각각에 10,000 shot을 할당하고, 절단하지 않은 단일 Circuit에도 같은 수를 할당합니다. 따라서 이 비교에서 절단 워크플로는 36배 많은 shot을 사용합니다. Circuit당 shot 수가 같다고 해서 전체 실행 예산이 같은 것은 아닙니다.
shots = 10_000
sampler = AerSampler(seed=1234)
cut_result = sampler.run(isa_experiments, shots=shots).result()
uncut_result = sampler.run([isa_uncut], shots=shots).result()
4단계: 후처리 및 원하는 고전적 형식으로 결과 반환
생성할 때 사용한 것과 동일한 매핑된 관측량과 실험 순서를 사용해 각 Pauli 기댓값을 재구성합니다. 그런 다음 처음 개 값을 평균해 를, 나머지 개 값을 평균해 를 구합니다. 절단하지 않은 Circuit은 측정된 카운트에서 직접 기댓값을 계산합니다.
cut_expvals = reconstruct_expectation_values(
    cut_result, coefficients, mapped_observables.paulis
)
uncut_counts = uncut_result[0].data.meas.get_counts()
uncut_expvals = [
    sampled_expectation_value(uncut_counts, p) for p in observables.paulis
]

def compare_results(cut_expvals, uncut_expvals, num_qubits):
    """Display average Z and periodic ZZ values against the ideal values."""
    cut_averages = np.asarray(cut_expvals).reshape(2, num_qubits).mean(axis=1)
    uncut_averages = (
        np.asarray(uncut_expvals).reshape(2, num_qubits).mean(axis=1)
    )
    print("Cut averages (Z, ZZ):", cut_averages)
    print("Uncut averages (Z, ZZ):", uncut_averages)
    print("Absolute cut errors:", np.abs(cut_averages - [-1, 1]))
    print("Absolute uncut errors:", np.abs(uncut_averages - [-1, 1]))

    fig, ax = plt.subplots(figsize=(7, 4))
    positions = np.arange(2)
    for offset, values, label, color in [
        (-0.25, [-1, 1], "Ideal", "#4589ff"),
        (0, cut_averages, "Cut", "#a56eff"),
        (0.25, uncut_averages, "Uncut", "#009d9a"),
    ]:
        ax.bar(
            positions + offset, values, width=0.25, label=label, color=color
        )
    ax.set_xticks(positions, ["Average Z", "Average periodic ZZ"])
    ax.set_ylabel("Expectation value")
    ax.axhline(0, color="black", linewidth=0.8)
    ax.legend()
    fig.tight_layout()
    plt.show()

compare_results(cut_expvals, uncut_expvals, num_qubits)
Cut averages (Z, ZZ): [-1.00100833  0.99778333]
Uncut averages (Z, ZZ): [-1.  1.]
Absolute cut errors: [0.00100833 0.00221667]
Absolute uncut errors: [0. 0.]

노이즈가 없는 결과는 이상적인 값에 가까워야 합니다. 유한한 shot 수로 재구성하면 값이 변동할 수 있고, 재구성된 추정값이 범위를 벗어날 수도 있습니다. 절단은 이미 노이즈가 없는 결과를 개선하지 않습니다. 이 예제는 하드웨어에서 실행하기 전에 분해, 레이아웃 매핑, 재구성을 검증하는 용도입니다.
대규모 하드웨어 예제
Qubit이 120개 이상인 운영 중 QPU 가운데 가장 한가한 것에서 같은 워크플로를 재사용합니다. 방향 없는 커플링 그래프에서 가장 긴 최단 경로를 선택합니다. 이 경로는 연속한 각 쌍이 연결되어 있으면서 양 끝점은 멀리 떨어져 있습니다. 이렇게 하면 고정된 Eagle 레이아웃에 의존하지 않고 선택한 장치에 맞게 체인이 조정됩니다. 코드는 체인에 Qubit이 30개 이상 포함되어 있는지, 그리고 양 끝점이 이웃이 아닌지 확인합니다.
다음 블록은 네 단계를 하나로 결합합니다. 두 버전 모두 Gate 트위링, 측정 트위링, 동적 디커플링을 비활성화합니다. 두 작업은 같은 batch에서 실행되며 튜토리얼 태그 TUT_CCPBC를 받습니다. 절단 실험은 여전히 전체 shot을 더 많이 사용하므로 정확도와 QPU 사용량을 모두 비교하세요.
service = QiskitRuntimeService()
backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=120
)

# ------------------------- Step 1 -------------------------
graph = backend.coupling_map.graph.to_undirected(multigraph=False)
paths = rx.all_pairs_dijkstra_shortest_paths(graph, lambda _: 1)
initial_layout = list(
    max(
        (
            path
            for source_paths in paths.values()
            for path in source_paths.values()
        ),
        key=len,
    )
)
num_qubits = len(initial_layout)
if num_qubits < 30:
    raise ValueError(
        "Select a backend with a shortest path of at least 30 qubits."
    )
if graph.has_edge(initial_layout[0], initial_layout[-1]):
    raise ValueError("The chain endpoints must not be directly connected.")
print(f"Backend: {backend.name}; chain length: {num_qubits}")
print("Initial layout:", initial_layout)
circuit, observables = build_periodic_problem(num_qubits)

# ------------------------- Step 2 -------------------------
isa_experiments, coefficients, mapped_observables = prepare_cut_experiments(
    circuit, observables, backend, initial_layout
)
uncut_pm = generate_preset_pass_manager(
    optimization_level=1,
    backend=backend,
    initial_layout=initial_layout,
    seed_transpiler=1234,
)
isa_uncut = uncut_pm.run(circuit.measure_all(inplace=False))
print("Uncut circuit depth:", isa_uncut.depth())
print("Cut circuit depths:", sorted({qc.depth() for qc in isa_experiments}))

# ------------------------- Step 3 -------------------------
options = SamplerOptions()
options.dynamical_decoupling.enable = False
options.twirling.enable_gates = False
options.twirling.enable_measure = False
options.environment.job_tags = ["TUT_CCPBC"]
shots = 10_000
with Batch(backend=backend) as batch:
    sampler = SamplerV2(mode=batch, options=options)
    cut_job = sampler.run(isa_experiments, shots=shots)
    uncut_job = sampler.run([isa_uncut], shots=shots)
print("Cut job ID:", cut_job.job_id())
print("Uncut job ID:", uncut_job.job_id())
cut_result = cut_job.result()
uncut_result = uncut_job.result()

# ------------------------- Step 4 -------------------------
cut_expvals = reconstruct_expectation_values(
    cut_result, coefficients, mapped_observables.paulis
)
uncut_counts = uncut_result[0].data.meas.get_counts()
uncut_expvals = [
    sampled_expectation_value(uncut_counts, p) for p in observables.paulis
]
compare_results(cut_expvals, uncut_expvals, num_qubits)
qpu_seconds = sum(
    job.metrics()["usage"]["quantum_seconds"] for job in [cut_job, uncut_job]
)
print(
    f"Total QPU usage: {qpu_seconds:.1f} seconds ({qpu_seconds / 60:.2f} minutes)"
)
Backend: ibm_boston; chain length: 33
Initial layout: [0, 1, 2, 3, 16, 23, 24, 25, 37, 45, 44, 43, 56, 63, 64, 65, 77, 85, 86, 87, 97, 107, 106, 105, 117, 125, 124, 123, 136, 143, 142, 141, 140]
Boundary gates cut: 2
Number of experiments: 36
Sampling overhead: 81.0
Uncut circuit depth: 375
Cut circuit depths: [20]
Cut job ID: dagp7fj9k43c73admp40
Uncut job ID: dagp7fj9k43c73admp5g
Cut averages (Z, ZZ): [-0.92305152  0.89586667]
Uncut averages (Z, ZZ): [-0.61106061  0.51606061]
Absolute cut errors: [0.07694848 0.10413333]
Absolute uncut errors: [0.38893939 0.48393939]
Total QPU usage: 102.0 seconds (1.70 minutes)

ibm_boston에서 기록된 실행에서 절단 추정값은 대략 , 이었고, 절단하지 않은 Circuit은 과 이었습니다. 두 절단 추정값 모두 이상적인 값인 과 에 더 가까웠습니다.
각 결과를 이상적인 값과 비교하고 Circuit 깊이와 전체 QPU 사용량을 살펴보세요. 절단하면 주기적 Gate를 라우팅할 필요가 없어지지만, 중간 연산과 추가적인 통계적 불확실성이 생깁니다. 하드웨어 노이즈와 보정 상태가 비교에 영향을 주므로 개선이 보장되지는 않습니다. 관찰된 차이가 통계적으로 유의한지 평가하려면 반복 실행이 필요합니다.
다음 단계
-
다른 비국소 상호작용에 대해서는 깊이 감소를 위한 Circuit 절단을 살펴보세요.
-
기댓값 추정을 위한 와이어 절단을 사용해 Circuit을 더 작은 부분 시스템으로 분할해 보세요.
-
Circuit 절단 설명 자료를 읽고 절단과 샘플링 오버헤드 사이의 트레이드오프를 이해하세요.