제약 양자 최적화기 - Aqarios의 Qiskit Function
API 참조를 참조하세요
Qiskit Functions는 IBM Quantum® Premium Plan, Flex Plan, On-Prem(IBM Quantum Platform API를 통한) Plan 사용자만 이용할 수 있는 실험적 기능이에요. 미리보기 릴리스 상태이며 변경될 수 있어요.
개요
Aqarios의 제약 양자 최적화기를 사용하면 수동 재정식화 및 회로 매핑 없이 IBM® 양자 하드웨어에서 제약 이진 최적화 문제를 해결할 수 있어요. 문제를 LP 파일, MPS 파일, 또는 Luna Model로 제공하기만 하면 돼요. 이 함수는 재정식화, 회로 합성, 트랜스파일, 하드웨어 실행을 자동으로 처리해요. 이 솔버는 양자 근사 최적화 알고리즘(QAOA)의 제약 네이티브 확장인 FlexQAOA 알고리즘의 반복적 웜스타트[1]를 활용해요.
이 최적화기는 제약이 있는 이진 문제를 대상으로 해요. 특히 원-핫 제약과 세트 패킹 제약은 XY-믹서를 사용하여 네이티브로 강제할 수 있어요. 다른 제약 유형은 자동으로 페널티 항으로 재정식화돼요.
이 함수는 이산 문제만 풀 수 있어요. 모든 결정 변수는 큐비트로 인코딩할 수 있도록 이진 변수이거나, 명시적인 하한과 상한이 있는 정수 변수여야 해요. 연속(실수값) 변수는 지원되지 않으며, 이를 포함하는 모델은 오류 코드 4710과 함께 거부돼요.
설명
성능은 문제 인스턴스와 이후 처리 단계 모두에 따라 달라질 수 있어요. 경우에 따라 고전적 샘플과 양자 생성 샘플이 동등한 후처리 후 유사한 최종 솔루션 품질을 달성할 수 있어요. 따라서 평가에는 전체 최적화 워크플로를 고려해야 해요.
제약 양자 최적화기는 반복적 웜스타트 XY-믹서 QAOA(IWS-QAOA) [1]를 구현합니다. 이 알고리즘은 양자 하드웨어에서 고정 각도 QAOA 회로를 실행하고, 이전 반복의 측정 결과를 사용하여 각 회로의 초기 웜스타트 확률을 업데이트합니다. 변분 매개변수 훈련은 필요하지 않으며, 대신 고정 선형 램프 매개변수화가 선택됩니다.
XY-믹서를 사용하여 원-핫 제약을 강제하면 제약 문제의 솔루션 품질을 크게 향상시킬 수 있어요. 이는 검색 공간이 실질적으로 더 작은 실행 가능한 부분 공간으로 축소되기 때문이며, 페널티 항으로 인한 추가적인 복잡성도 최적화 지형에 도입되지 않기 때문이에요.
워크플로
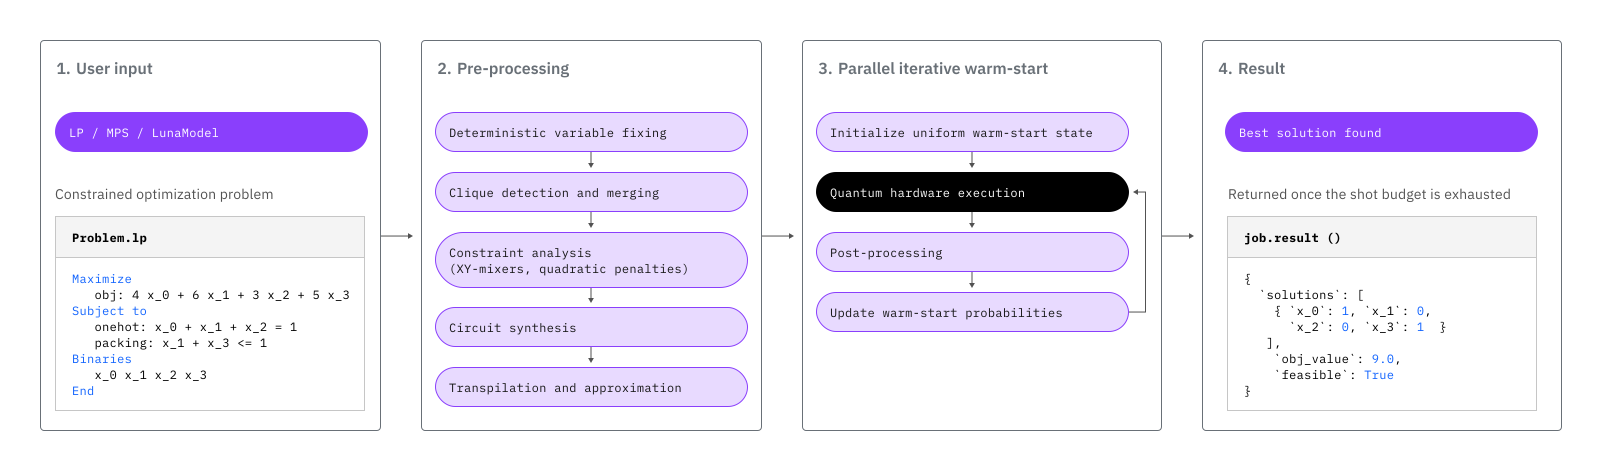
이 함수의 워크플로는 다음과 같습니다.
-
전처리: 회로 합성 전에 최적화기는 입력 문제의 제약 구조를 분석합니다.
-
그래프 전처리: 문제에 적용 가능한 경우, 변수 간의 관계를 결정하는 엣지를 가진 그래프로 분석해요. 이 그래프 분석을 통해 전처리 단계에서 문제를 두 가지 방식으로 개선할 수 있어요. 첫째, 단일 제약들은 클리크 병합을 사용하여 하나의 큰 제약으로 집계될 수 있어 단일 XY-믹서로 표현돼요. 둘째, 이웃이 하나뿐인 변수는 결정론적으로 고정될 수 있어 문제 크기와 복잡성이 줄어들어요.
-
제약 해결: 전처리기는 각 제약을 개별적으로 처리해요. 제약이 원-핫 제약인 경우 XY-믹서를 통해 강제할 수 있어요. 세트 패킹 제약인 경우 먼저 원-핫 제약으로 변환돼요. 등식 제약은 이차 페널티를 통해 처리되고, 부등식 제약은 불균형 페널티화를 통해 처리돼요.
-
페널티 도출: 원-핫 등식 제약으로 표현할 수 없는 제약은 페널티 항으로 변환됩니다. 최적화기는 문제 구조로부터 페널티 강도를 자동으로 도출합니다.
-
-
반복적 웜스타팅: 최적화기는 여러 개의 _병렬 웜스타트 체인_을 실행해요. 각 체인은 변수 할당에 대한 확률 분포를 유지하며, 이는 QAOA 회로의 시작 확률(웜스타트 상태)로 사용돼요. 각 반복에서 체인은 양자 회로에서 샘플링하고, 고전적 후처리를 적용하며, 샘플의 발생에 기반하여 분포를 업데이트해요. 반복이 거듭될수록 변분 최적화 루프 없이도 탐색이 고품질 솔루션 쪽으로 좁혀져요.
체인의 수(num_parallel), 체인당 총 샷 예산(total_shots), QAOA 반복 횟수(reps)는 솔루션 품질과 런타임 간의 균형을 조정하는 주요 제어 요소입니다.
벤치마크
아래 벤치마크는 제약 양자 최적화기 Qiskit Function이 100개를 훨씬 초과하는 이진 변수를 가진 제약 최적화 문제에 대해 고품질의 실행 가능한 솔루션을 찾을 수 있음을 보여줍니다. 정확도는 발견된 목적 값과 알려진 최적값의 비율입니다. 런타임은 함수 호출부터 결과 전달까지의 실제 경과 시간입니다. QPU 사용량은 청구 가능한 Quantum Compute 시간입니다.
두 가지 문제가 검토되었습니다: 최대 독립 집합(MIS) 문제와 잘 알려진 MaxCut 문제를 두 개 이상의 범주로 확장한 Max--Cut입니다. Max--Cut은 그래프 색칠 결정 문제와 동등한 최적화 문제이기도 합니다(모든 엣지가 절단되면 그래프는 -색칠 가능합니다).
| 문제 | 변수 | 제약 조건 | 큐비트 | 정확도 | 실행 가능성 | 총 실행 시간(초) | QPU 사용 시간(초) | 총 샷 수 |
|---|---|---|---|---|---|---|---|---|
| MIS es60fst02 | 186 | 280 | 124 | 100.0% | True | 940.2 | 147.0 | 25.0k |
| MIS sloane_2dc_128 | 128 | 5173 | 74 | 100.0% | True | 347.6 | 106.0 | 12.5k |
| Max-3-Cut Karate Club | 99 | 33 | 99 | 98.7% | True | 279.5 | 166.0 | 25.0k |
| Max-4-Cut Karate Club | 132 | 33 | 132 | 100.0% | True | 258.3 | 200.0 | 25.0k |
벤치마크 참고사항
-
위 결과는 기본 옵션과
use_session이 활성화된ibm_marrakeshHeron r2 프로세서에서 얻어졌습니다.sloane_2dc_128인스턴스의 경우total_shots=12500이 사용되었습니다. -
MIS 인스턴스에 대해 감소된 큐비트 수(186 및 128개 변수 대비 124 및 74)는 전처리에서의 변수 고정을 반영합니다.
-
MIS의 문제 인스턴스는 양자 최적화 벤치마킹 라이브러리에서 가져온 것입니다. - Max--Cut 문제의 인스턴스는 채색수가 5인 Zachary Karate Club 그래프입니다.
시작하기
이 가이드는 함수를 로드하고 간단한 문제를 실행하는 방법을 보여줌으로써 제약 양자 최적화기의 기본 사용법을 보여줍니다. 더 심화된 튜토리얼은 Aqarios 제약 양자 최적화기로 최대 독립 집합 찾기를 참조하세요.
IBM Quantum API 키와 인스턴스 CRN으로 인증한 다음 카탈로그에서 함수를 로드합니다.
다음 코드는 자격 증명을 저장했다고 가정합니다. 이를 설정하려면 IBM Cloud 계정 자격 증명 저장의 지침을 따르세요.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"luna_model": "luna-model", "networkx": "networkx", "qiskit_addon_opt_mapper": "qiskit-addon-opt-mapper", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(aqarios/constrained-quantum-optimizer)]
# Load the function
optimizer = catalog.load("aqarios/constrained-quantum-optimizer")
# Check the list of backends you have access to
catalog.backends()
[<IBMBackend('ibm_pittsburgh')>,
 <IBMBackend('ibm_boston')>,
 <IBMBackend('ibm_phoenix')>,
 <IBMBackend('ibm_fez')>,
 <IBMBackend('ibm_miami')>,
 <IBMBackend('ibm_marrakesh')>,
 <IBMBackend('ibm_kingston')>]
# Select the backend you want to use
backend = catalog.backend("ibm_phoenix")
예제 1: 간단한 제약 문제
첫 번째 예제는 경영과학(OR)에서 흔히 사용되는 최적화 문제 명세인 LP 파일로 함수를 사용하는 방법을 보여줍니다. 다음과 같은 다섯 개의 이진 변수 에 대한 임의의 최적화 문제를 두 가지 제약 조건 아래 정식화합니다:
1. 문제 정식화하기
수학적 표현식을 다음과 같은 LP 문자열 형식으로 직접 나타냅니다.
lp_str = """\\Problem name: Example
Minimize
  obj: [ 2 x_1 x_2 + 4 x_2 x_3 - 2 x_3 x_4 - 4 x_4 x_5 - 4 x_1 x_3 - 8 x_2 x_5 ] / 2
Subject To
  c1: x_1 + x_2 + x_3 <= 1
  c2: x_3 - x_4 + x_5 = 0
Binaries
  x_1 x_2 x_3 x_4 x_5
End
"""
[ ... ] / 2는 LP 표준에서 이차 목적 함수를 위해 필요한 표기법임에 유의하세요.
2. 최적화기 실행하기
최적화기로 문제를 해결합니다.
# Set up low-resource options for the simple problem
options = {"total_shots": 2000, "num_parallel": 5, "use_session": True}

# Dispatch the job
job_1 = optimizer.run(
    problem=lp_str, backend_name=backend.name, options=options
)

print(f"Job ID: {job_1.job_id}")
Job ID: 2e06a3a8-7c29-4c76-94d7-194293363f4a
# Monitor the job status
job_1.status()
'RUNNING: WAITING_FOR_QPU'
3. 결과 가져오기
변수 이름을 관련 할당에 매핑하는 솔루션이 결과에서 제공됩니다.
result = job_1.result()

result
{'solutions': [{'x_1': 0, 'x_2': 1, 'x_3': 0, 'x_4': 1, 'x_5': 1}],
 'solution_bitstrings': ['01011'],
 'raw_energy': -6.0,
 'objective_value': -6.0,
 'feasible': True,
 'metadata': {'resource_usage': {'RUNNING: MAPPING': {'CPU': 5.405},
   'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU': 9.902},
   'RUNNING: WAITING_FOR_QPU': {'CPU': 25.456},
   'RUNNING: EXECUTING_QPU': {'CPU': 25.202},
   'RUNNING: POST_PROCESSING': {'CPU': 6.481}},
  'circuit_metrics': {'before_transpilation': {'num_qubits': 6,
    'gate_count': 42,
    'depth': 15,
    'two_qubit_gate_count': 12,
    'two_qubit_gate_depth': 7,
    'operations': {'rz': 12,
     'p': 8,
     'ry': 7,
     'rzz': 4,
     'cx': 3,
     'xx_plus_yy': 3,
     'global_phase': 2,
     'cry': 2,
     'x': 1}},
   'after_transpilation': {'num_qubits': 6,
    'gate_count': 254,
    'depth': 100,
    'two_qubit_gate_count': 48,
    'two_qubit_gate_depth': 33,
    'operations': {'rz': 78, 'sx': 122, 'cz': 48, 'measure': 6, 'x': 0}}},
  'solver_info': {'variable_mapping': {'x_1': 0,
    'x_2': 1,
    'x_3': 2,
    'x_4': 3,
    'x_5': 4}}}}
반환 딕셔너리의 solutions 필드에는 발견된 최선의 솔루션(축퇴된(degenerate) 솔루션 포함)이 모두 각 변수 이름을 해당 할당값에 매핑하는 딕셔너리 형태로 들어 있어요. 같은 솔루션들은 solution_bitstrings에 비트스트링으로도 반환되며, metadata.solver_info.variable_mapping은 비트스트링의 몇 번째 문자 위치가 어느 변수에 해당하는지 알려 줘요. 솔루션 데이터와 함께 objective_value, feasible 플래그, 추가 metadata가 제공돼요.
예제 2: 최대 독립 집합
최대 독립 집합(MIS) 문제는 그래프에서 부분집합 내 어떤 두 정점도 엣지를 공유하지 않는 가장 큰 정점 부분집합을 찾는 문제입니다. 이 예제는 12개 노드로 구성된 정규 그래프에서 MIS를 해결합니다. 이 문제와 더 큰 예제에 대한 자세한 내용은 튜토리얼을 참조하세요.
이 문제는 qiskit-addon-opt-mapper로 구축됩니다. 필요한 경우 필수 패키지를 설치하세요:
# %pip install networkx qiskit-addon-opt-mapper
1단계: 문제 정의하기
무작위 3-정규 그래프를 구축하고 MIS 최적화 문제를 생성합니다. 각 그래프 노드는 이진 변수가 되고, 각 엣지는 최대 하나의 끝점만 선택되도록 하는 제약을 도입합니다.
import networkx as nx
from qiskit_addon_opt_mapper.applications import IndependentSet
from qiskit_addon_opt_mapper.translators import to_docplex_mp

# 12-node random 3-regular graph
G = nx.random_regular_graph(3, 12, seed=7)

# Build MIS problem and export as LP string
mis = IndependentSet(G)
mis_problem = mis.to_optimization_problem()
lp_str = to_docplex_mp(mis_problem).export_as_lp_string()

print(lp_str)
\ This file has been generated by DOcplex
\ ENCODING=ISO-8859-1
\Problem name: Independent set

Maximize
 obj: x_0 + x_1 + x_2 + x_3 + x_4 + x_5 + x_6 + x_7 + x_8 + x_9 + x_10 + x_11
Subject To
 c0: x_0 + x_4 <= 1
 c1: x_0 + x_9 <= 1
 c2: x_0 + x_8 <= 1
 c3: x_1 + x_2 <= 1
 c4: x_1 + x_7 <= 1
 c5: x_1 + x_3 <= 1
 c6: x_2 + x_4 <= 1
 c7: x_2 + x_11 <= 1
 c8: x_3 + x_10 <= 1
 c9: x_3 + x_11 <= 1
 c10: x_4 + x_5 <= 1
 c11: x_5 + x_10 <= 1
 c12: x_5 + x_6 <= 1
 c13: x_6 + x_8 <= 1
 c14: x_6 + x_7 <= 1
 c15: x_7 + x_9 <= 1
 c16: x_8 + x_11 <= 1
 c17: x_9 + x_10 <= 1

Bounds
 0 <= x_0 <= 1
 0 <= x_1 <= 1
 0 <= x_2 <= 1
 0 <= x_3 <= 1
 0 <= x_4 <= 1
 0 <= x_5 <= 1
 0 <= x_6 <= 1
 0 <= x_7 <= 1
 0 <= x_8 <= 1
 0 <= x_9 <= 1
 0 <= x_10 <= 1
 0 <= x_11 <= 1

Binaries
 x_0 x_1 x_2 x_3 x_4 x_5 x_6 x_7 x_8 x_9 x_10 x_11
End
2단계: 최적화기 실행하기
최적화기로 문제를 해결합니다.
options = {"total_shots": 2000, "use_session": True}

# Dispatch the job
job_2 = optimizer.run(
    problem=lp_str, backend_name=backend.name, options=options
)

print(f"Job ID: {job_2.job_id}")
Job ID: f041431c-b42e-4627-afe5-522fea61faf6
# Monitor the job status
job_2.status()
'QUEUED'
3단계: 결과 가져오기 및 해석하기
마지막으로 솔루션을 검색하고 정확성을 검증합니다.
result = job_2.result()

print(f"Feasible: {result['feasible']}")
print(f"Independent set size: {int(result['objective_value'])}")

# Extract the selected nodes
solution = result["solutions"][0]
independent_set = [
    int(k.split("_")[1]) for k, v in solution.items() if v == 1
]
print(f"Selected nodes: {sorted(independent_set)}")

# Verify no two selected nodes share an edge
conflicts = [
    (u, v)
    for u, v in G.edges()
    if u in independent_set and v in independent_set
]
print(f"Edge conflicts: {conflicts}")
Feasible: True
Independent set size: 5
Selected nodes: [1, 4, 6, 9, 11]
Edge conflicts: []
예제 3: 그래프 3-색칠(Max-3-Cut)
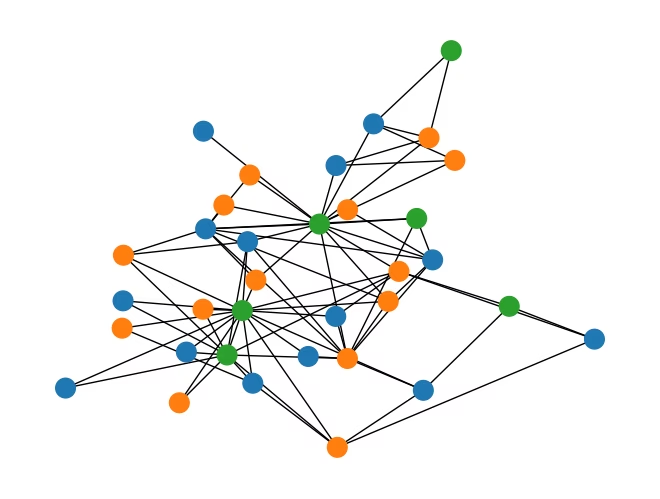
Max--Cut 문제는 그래프의 정점을 개의 그룹으로 분할하여 서로 다른 그룹에 속하는 끝점을 가진 엣지의 수를 최대화합니다. 인 경우 이는 교차 색상 엣지를 최대화하는 3-색칠을 찾는 것과 동등합니다.
공식적으로, 각 노드 를 색상 에 대한 이진 변수 로 개 그룹 중 하나에 할당합니다. 각 노드에 대한 원-핫 제약 은 고유한 할당을 강제합니다. 목적 함수는 교차 그룹 엣지를 최대화합니다:
원-핫 제약은 XY-믹서에 이상적이며, 최적화기가 이를 네이티브로 처리해요.
이 예제는 Zachary Karate Club 그래프(34개 노드, 78개 엣지)를 사용하고 Luna Model로 모델을 구축합니다. 필요한 경우 필수 패키지를 설치하세요:
# %pip install networkx matplotlib luna-model
1단계: 문제 정의하기
먼저 luna-model 패키지로 이진 변수를 생성합니다. 그런 다음 목적 함수를 정의하고 모델에 제약을 추가합니다.
import networkx as nx
from luna_model import Model, quicksum

k = 3
G = nx.karate_club_graph()

# Instantiate the Model object
model = Model(name="Max-3-Cut")

# Add binary variables
x = model.add_variables("x", shape=(G.number_of_nodes(), k))

# Add the objective by using the numpy dot abstraction
model.objective = quicksum(x[i].dot(x[j]) for i, j in G.edges)

# Bulk-add the one-hot constraints
model.add_constraints(x.sum(axis=1) == 1)

# Encode the model to send via API
model_enc = model.encode_b64()
2단계: 최적화기 실행하기
최적화기로 문제를 해결합니다.
options = {"use_session": True}

# Dispatch the job
job_3 = optimizer.run(
    problem=model_enc, backend_name=backend.name, options=options
)

print(f"Job ID: {job_3.job_id}")
Job ID: df911d83-9df7-44a1-bfad-5d66e08676c3
# Monitor the job status
job_3.status()
'RUNNING: WAITING_FOR_QPU'
3단계: 결과 검색 및 시각화하기
결과를 검색하고 시각화합니다.
result = job_3.result()
solution = result["solutions"][0]

# Map each node to its assigned color group
node_group = {}
for i in G.nodes:
    for c in range(k):
        if solution[f"x{i},{c}"] == 1:
            node_group[i] = c

print(f"Feasible: {result['feasible']}")
print(f"Violations: {int(result['objective_value'])}")

# Visualize the partition
colors = ["tab:blue", "tab:orange", "tab:green"]
node_colors = [colors[node_group[i]] for i in G.nodes()]
nx.draw(G, nx.kamada_kawai_layout(G), node_color=node_colors, node_size=200)
Feasible: True
Violations: 4
변경 로그
[0.4.0] - 2026-09-22
호환성을 깨는 변경 사항
- 입력 매개변수
model의 이름을problem으로 변경했어요. - 출력 필드
obj_value의 이름을objective_value로 변경했어요. postprocessing옵션을postprocessing_level로 대체했어요. 이 옵션은 문자열 대신[0, 3]범위의 정수를 받아요. 이전 값은"off"->0,"weak"->1,"medium"->2,"strong"->3으로 대응되며, 기본값은3으로 변하지 않았어요.metadata.circuit_metrics의 구조를 변경했어요. 이제 평균 게이트 수를 담은 중첩 없는 단일 딕셔너리 대신num_qubits,gate_count,depth,two_qubit_gate_count,two_qubit_gate_depth,operations를before_transpilation과after_transpilation에 대해 각각 보고해요. 문제가 전처리 중에 풀려서 회로가 실행되지 않은 경우 이 필드는None이에요(오류 코드4712).
기능
- 실행 간에 회로 합성과 라우팅을 재현할 수 있도록
seed_transpiler옵션을 추가했습니다. - 이 함수가 제출하는 모든 Qiskit Runtime 작업에 사용자 지정 태그를 붙일 수 있는
job_tags옵션을 추가했습니다. solutions와 동일한 해를 비트스트링 형태로 반환하는 출력 필드solution_bitstrings를 추가했습니다.- 각 변수 이름을
solution_bitstrings항목 내 문자 위치에 매핑하는metadata.solver_info.variable_mapping을 추가했습니다.
문서
- 연속(실수값) 변수는 지원되지 않으며 정수 변수에는 명시적인 경계가 필요하다는 점을 문서화했습니다. 이러한 모델은 오류 코드
4710으로 실패합니다.
지원 받기
질문이나 문제가 있으면 작업 ID와 함께 support@aqarios.com으로 문의하세요.
다음 단계
- Aqarios의 제약 양자 최적화기 접근 권한 요청하기.
- 완전한 매개변수 및 출력 문서는 API 참조를 방문하세요.
- 실제 QOBLIB 벤치마크 인스턴스에 대한 심층 분석은 Aqarios 제약 양자 최적화기로 최대 독립 집합 찾기 튜토리얼을 시도해보세요.
- 논문 반복적 웜스타트 XY-믹서를 통한 제약 양자 최적화를 읽어 보세요.
참고 문헌
- Bucher et al. (2026), 반복적 웜스타트 XY-믹서를 통한 제약 양자 최적화 10.1088/1367-2630/ae8ea2