Rimay Quantum Feature Extraction - Kipu Quantum의 Qiskit Function
API 레퍼런스를 참조하세요.
Qiskit Functions는 IBM Quantum® Premium Plan, Flex Plan, On-Prem(IBM Quantum Platform API를 통한) Plan 사용자만 사용할 수 있는 실험적 기능입니다. 미리 보기 릴리스 상태이며 변경될 수 있습니다.
개요
Rimay는 양자 하드웨어에서 생성한 특징으로 고전적 머신러닝 파이프라인을 보강합니다. 이 함수는 고전적 표 형식 데이터를 받아 양자 변환 특징 집합을 반환합니다. 양자 시스템이 데이터를 처리하면 입력 간의 비선형 관계를 포착하는 풍부한 특징이 생성됩니다. 생성된 특징을 단독으로 또는 원래 특징과 결합하여 임의의 고전 모델을 훈련하는 데 사용할 수 있습니다. 소규모 및 중간 규모 데이터셋에서는 양자 변환 특징이 순수 고전적 기준선에 비해 예측 품질을 향상시킬 수 있습니다.
이 함수는 다음과 같은 사용자를 위해 만들어졌습니다.
-
소규모 및 중간 규모 표 형식 데이터셋에 대한 기존 머신러닝 파이프라인이 있으며 예측 품질이 정체된 데이터 과학 팀. 양자 회로를 직접 만들 필요 없이 Rimay를 추가 전처리 단계 하나로 더하면 됩니다.
-
머신러닝 작업을 위한 양자 방법을 탐구하는 연구자.
설명
양자 특징 추출 알고리즘 [1]은 양자 머신러닝의 두 가지 원리를 결합합니다. 첫째는 데이터를 고차원 힐베르트 공간에 임베딩하여 더 표현력 있는 표현을 만드는 양자 특징 맵입니다. 둘째는 양자 다체계의 동역학을 입력의 비선형 변환으로 사용하는 양자 저장소 컴퓨팅입니다.
Rimay는 특징 값과 특징 간 상호 정보를 스핀 글라스 해밀토니언의 국소 장과 결합 계수로 인코딩합니다. 반단열 양자 동역학은 시스템을 입력 데이터의 상관관계가 비선형적으로 혼합된 저에너지 상태로 진화시킵니다. Rimay는 일체 및 이체 기댓값을 측정하여 이러한 상관관계를 추출합니다. 이 기댓값이 머신러닝 모델에 입력하는 양자 변환 특징입니다.
워크플로
-
고전적 머신러닝에서와 같이 표 형식 데이터를 전처리하세요. Rimay에는 수치형 특징이 필요하므로, 예를 들어 scikit-learn의
OneHotEncoder로 범주형 특징을 수치형으로 변환하세요. -
데이터를 훈련 세트와 테스트 세트로 분할하고, 예제 섹션과 같이 두 세트를 모두 함수에 업로드하세요.
-
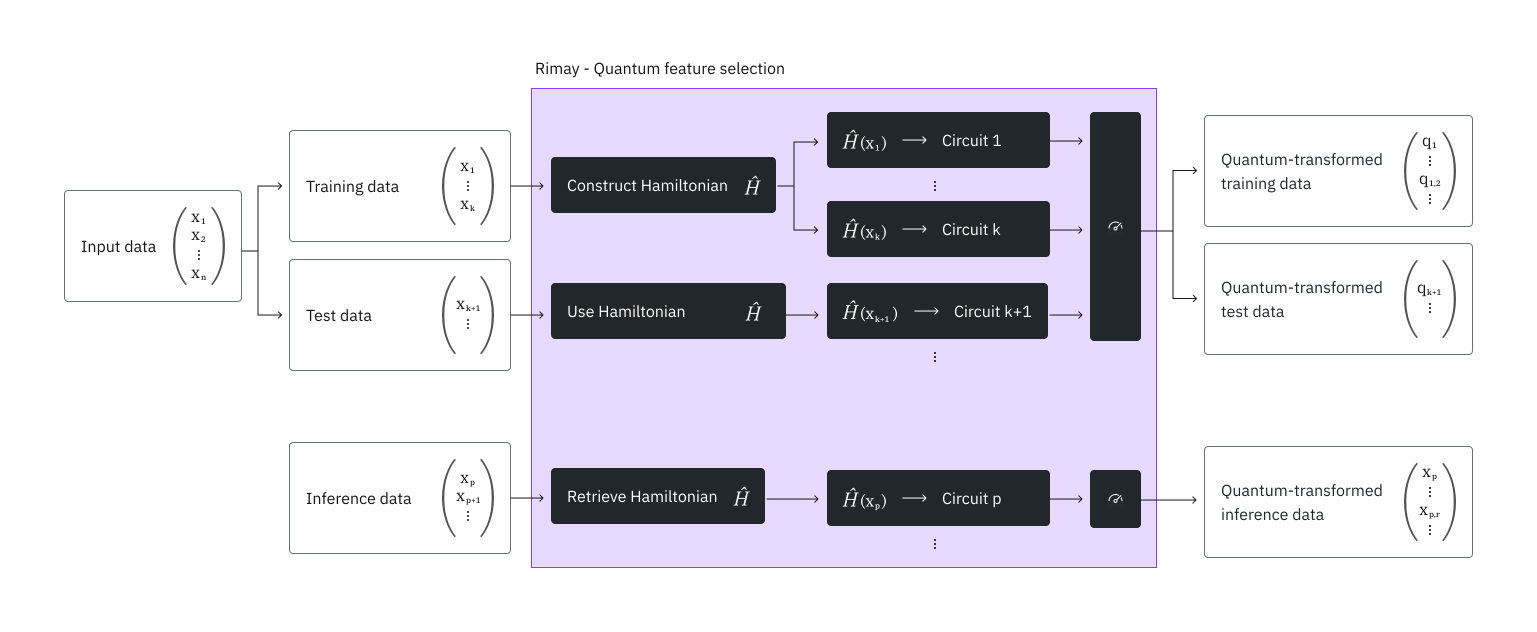
Rimay는 훈련 데이터를 사용하여 데이터를 나타내는 해밀토니언을 구성합니다. 모든 특징은 하나의 큐비트에 대응하며, 전체 훈련 세트가 어떤 특징(따라서 어떤 큐비트)이 상호작용할지를 결정합니다. Rimay는 이 구조를 저장하여 테스트 데이터와 이후의 추론 데이터를 동일한 해밀토니언으로 매핑합니다.
-
모든 샘플에 대해 특징 값이 해밀토니언의 국소 장을 설정하고, 특징 간 상호 정보가 3단계 구조의 결합 계수를 설정합니다. Rimay는 이 해밀토니언의 반단열 진화를 회로로 디지털화하여 QPU에서 회로를 실행합니다.
-
Rimay는 결과 비트열을 측정한 다음, 일체 기댓값과 물리적으로 결합된 큐비트의 이체 기댓값을 계산합니다.
-
기댓값을 모델에 바로 입력하거나 원래 특징과 결합할 수 있는 형태로 다운로드합니다.
이러한 구조 때문에 실행에 필요한 큐비트 수는 특징 수와 같고, 제출하는 회로 수는 샘플 수와 같습니다.
매핑을 피팅한 후에는 새 데이터를 그 매핑을 통해 변환할 수 있으며, 예를 들어 추론에 사용할 수 있습니다. 그러면 Rimay는 피팅 중에 만든 해밀토니언을 가져와 그로부터 새 샘플용 회로를 구성합니다.
Rimay를 머신러닝 파이프라인에 통합하기
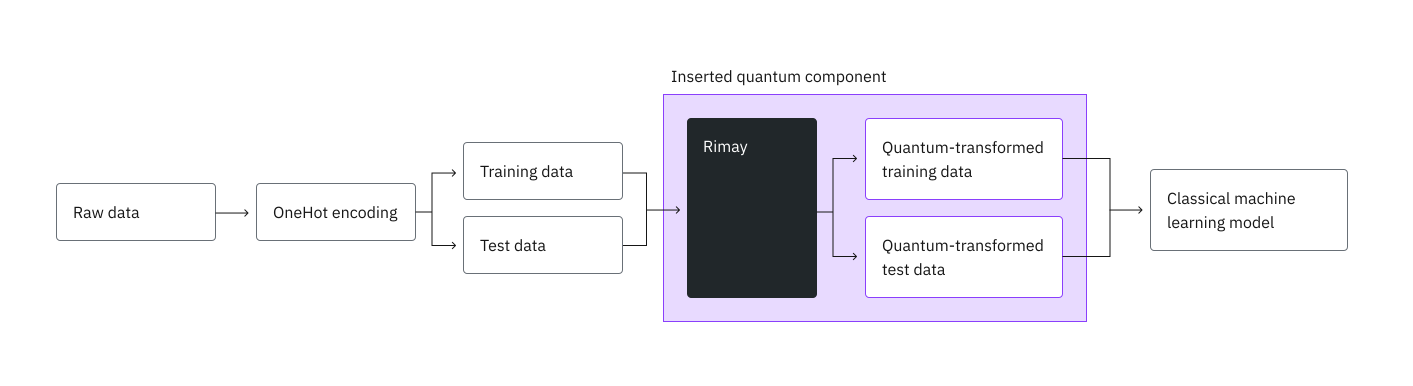
고전적 파이프라인과 마찬가지로, 예를 들어 범주형 특징을 원-핫 인코딩하는 등 원시 데이터를 전처리하고 훈련 세트와 테스트 세트로 분할하는 것으로 시작합니다. 두 세트를 모델에 직접 입력하는 대신 먼저 Rimay에 입력하고, 양자 변환 특징으로 모델을 훈련합니다.
벤치마크
Kipu Quantum은 OpenML [2]의 독일 신용 데이터셋으로 Rimay를 벤치마크했습니다. 이 데이터셋은 신용 신청자 1000명을 신용 위험이 좋은지 나쁜지로 분류합니다. 범주형 속성 13개와 수치형 속성 7개가 있습니다. 범주형 속성을 원-핫 인코딩하면 수치형 특징 48개가 됩니다. 벤치마크는 샘플의 20%를 테스트 세트로 따로 떼어 둡니다.
기준선으로 고전적 특징에 대해 여러 고전 모델을 훈련했습니다. Rimay로는 랜덤 포레스트를 두 가지 방식으로 훈련했습니다. 양자 변환 특징만으로 훈련한 경우(Random forest Q)와, 양자 변환 특징을 고전적 특징과 결합하여 훈련한 경우(하이브리드를 뜻하는 Random forest H)입니다. 표에는 양자 변환 특징에서 가장 좋은 성능을 보인 랜덤 포레스트만 나와 있습니다.
| 모델 | 특징 | 정확도 | AUC | F1 점수 | 정밀도 | 재현율 |
|---|---|---|---|---|---|---|
| CatBoost | 고전 | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | 고전 | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | 고전 | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | 고전 | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | 양자 | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | 하이브리드 | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
하이브리드 특징은 정밀도를 제외한 랜덤 포레스트의 모든 지표를 향상시키며, 하이브리드 랜덤 포레스트는 고전적 특징을 사용한 CatBoost보다 높은 AUC, F1 점수, 재현율에 도달합니다. 가장 큰 효과는 재현율에서 나타나며, 0.921에서 0.957로 상승합니다. 양자 변환 특징만으로는 고전 모델의 정밀도에 미치지 못합니다.
테스트 세트에는 샘플이 200개뿐이므로 샘플 하나를 더 정확히 예측하면 정확도가 0.005 달라집니다. 차이는 유의미한 효과가 아니라 추가 검증이 필요한 경향으로 해석하세요. 예측 정확도는 추출된 특성에 하드웨어로 인해 생기는 노이즈에도 좌우될 수 있습니다. 따라서 샷 노이즈가 결과를 제한하지 않도록 충분한 샷을 사용하세요.
벤치마크에는 다음 리소스를 사용했습니다.
| 예제 | 큐비트 수 | 샘플 수 | 샷 수 | 총 시간(분) | QPU 사용량(분) | 프로세서 |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
회로의 수인 샘플 수가 QPU 시간을 좌우합니다. 필요한 QPU 시간을 크게 줄여 주므로 Nighthawk r2 프로세서 유형을 사용하세요.
입력
mode에 따라 실행에 필요한 매개변수가 정해집니다. 모든 입력 매개변수에 대한 설명은 API 레퍼런스를 참조하세요.
입력 파일
-
함수를 실행하기 전에
catalog.file_upload()로 모든 파일을 업로드하세요. -
업로드하면 아직 시작되지 않은 제출된 작업의 경우에도 같은 이름의 기존 파일이 대체됩니다. 여러 작업을 동시에 실행하려면 작업마다 파일에 고유한 이름을 지정하세요. 예를 들어
run1_x_train.csv와run2_x_train.csv처럼 지정합니다. -
모든 파일은 헤더 행이 있는 CSV 파일입니다. 특성 파일의 각 열은 하나의 특성이며 모든 값은 숫자여야 합니다.
-
y_train에는x_train의 각 행에 레이블이 하나씩 대응하는 숫자 열이 정확히 하나 있어야 합니다. 범주형 레이블은 숫자로 매핑하세요. 예를 들어 good과 bad를 1과 0으로 매핑합니다. -
x_test와x_inference는x_train과 같은 열을 같은 순서로 가져야 합니다.
mapping_id는 피팅으로 생성된 매핑에 접근하는 유일한 방법이며, 조회하거나 복구할 수 없습니다. 해당 매핑을 사용할 권한을 부여하므로 자격 증명처럼 취급하고 공유하지 마세요. 분실하면 새 매핑을 피팅해야 하며, 이는 양자 하드웨어에서 또 한 번의 실행 비용이 듭니다. 매핑은 해당 프로세서에서만 실행되므로 피팅에 사용한 backend_name도 함께 기록해 두세요.
제한 사항
-
각 특성은 하나의 큐비트에 매핑되므로 프로세서의 큐비트 수는 데이터의 특성 수 이상이어야 합니다. 특성이 그보다 많다면 먼저 특성 선택 기법으로 특성 수를 줄이세요.
-
각 샘플은 하나의 회로가 되며, 한 번의 실행에서는 학습 샘플과 테스트 샘플을 합쳐서 셉니다. 한 번의 실행에는 최대 15,000개의 샘플을 담을 수 있습니다.
-
단일 작업은 최대 1,000만 번의 실행을 요청할 수 있으므로 샘플 수에
shots를 곱한 값이 1,000만을 넘어서는 안 됩니다. -
작업은 회로가 프로세서 대기열에서 기다리는 시간을 포함하여 24시간 이내에 끝나야 합니다. 이보다 오래 실행되는 작업은 결과 없이 중지됩니다. 사용량이 많은 프로세서에서는 대규모 데이터 세트를 이 제한보다 훨씬 낮게 유지하세요.
출력
job.result()는 딕셔너리를 반환합니다. 양자 변환된 특성 자체는 catalog.file_download()로 다운로드하는 CSV 파일에 기록됩니다. 딕셔너리의 각 키에 대한 설명은 API 레퍼런스를 참조하세요. 각 실행 단계에 걸린 시간은 실행 메타데이터를 참조하세요.
모든 출력 파일에는 입력 파일의 순서대로 입력 행마다 한 행이 있고, 양자 변환된 특성마다 한 열이 있습니다. 이름이 corr_로 시작하는 열은 2체 기댓값입니다. 파일에는 레이블 열이 없습니다. 학습 데이터의 레이블은 y_train 파일에 그대로 남습니다.
실행 메타데이터
resource_usage에는 실행이 거친 각 실행 단계별 항목이 하나씩 있습니다. "RUNNING: MAPPING", "RUNNING: POST_PROCESSING", 그리고 QPU에서는 보통 "RUNNING: WAITING_FOR_QPU"입니다. 각 항목에는 해당 단계의 실제 경과 시간(초)인 CPU_TIME과 QPU 시간(초)인 QPU_TIME이 들어 있습니다. QPU에서는 IBM이 청구한 QPU 시간이 회로가 실행된 단계인 "RUNNING: MAPPING" 아래에 기록됩니다.
"RUNNING: WAITING_FOR_QPU"는 작업이 IBM 대기열에서 기다린 시간입니다. 실행은 IBM 작업 타임스탬프에서 이 시간을 가져오며 "RUNNING: MAPPING"에는 포함하지 않습니다. IBM이 모든 작업의 타임스탬프를 보고하지 않으면 이 항목은 없으며, 대기 시간은 "RUNNING: MAPPING"에 포함됩니다.
IBM®는 작업이 끝나고 어느 정도 시간이 지난 후에 사용량 계산을 마칩니다. 실행은 이를 최대 1분 정도 기다립니다. 그 시간이 지나도 계산 중인 사용량은 QPU_TIME에 포함되지 않으며, 최종 사용량은 IBM Quantum Platform에 표시됩니다. 실행이 IBM에서 사용량을 읽을 수 없으면 QPU_TIME은 None입니다.
예를 들면 다음과 같습니다.
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
시작하기
IBM Quantum Platform API 키로 인증하고 다음과 같이 Qiskit Function을 선택하세요.
다음 코드는 자격 증명을 저장해 두었다고 가정합니다. 저장하지 않았다면 Qiskit Functions Catalog 클라이언트 설치의 지침에 따라 API 키로 계정을 저장하세요.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
함수 크기
모든 작업은 S, M, L 중 하나의 크기로 실행됩니다. 지정한 크기가 너무 작으면 작업이 거부됩니다. 크기가 필요 이상으로 크면 작업에 필요한 것보다 더 큰 컴퓨팅 프로파일에서 실행됩니다.
Rimay 작업의 크기는 매핑하는 샘플 수에 따라 결정됩니다. fit-transform에서는 x_train과 x_test의 행, transform에서는 x_inference의 행이 기준입니다. y_train의 레이블은 세지 않으며 delete 실행은 샘플을 매핑하지 않습니다.
| 크기 | 작업당 샘플 수 | 컴퓨팅 프로파일 | vCPU | RAM |
|---|---|---|---|---|
S | 최대 2,999 | 8x32 | 8 | 32 GB |
M | 3,000~9,999 | 8x32 | 8 | 32 GB |
L | 10,000~15,000 | 16x128 | 16 | 128 GB |
샘플 수가 유일한 기준입니다. 크기는 컴퓨팅 프로파일만 바꿉니다. 특성, 샘플, 샷에 대한 제한은 모든 크기에서 같습니다. S와 M은 같은 컴퓨팅 프로파일에서 실행되며 각각이 다루는 샘플 수만 다릅니다.
작업이 크기를 요청하지 않으면 기본값인 M이 사용됩니다. 따라서 샘플이 9,999개를 넘는 작업은 L을 요청해야 합니다.
rimay.sizes_map으로 함수 자체에서 매핑을 읽을 수 있고, rimay.default_size로 작업이 크기를 요청하지 않을 때 실행되는 크기를 읽을 수 있습니다.
제출하기 전에 크기 계산하기
자신의 입력에 대해 이것을 실행하세요. 입력을 읽기만 하고 다른 일은 하지 않습니다. 작업이 제출되지 않고 아무것도 예약되지 않으므로 원하는 만큼 자주 호출할 수 있습니다.
파일 이름이 아니라 데이터 세트 자체를 input_file과 같은 순서로, 실행의 mode와 함께 전달하세요. 호출 방법은 예제의 2단계에 나와 있습니다.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
크기가 너무 작으면 작업이 오류 4600으로 실패하고, 메시지에 대신 사용할 크기가 표시됩니다. 필요 이상으로 크면 작업은 정상적으로 실행되며 4601 권고 이벤트가 기록됩니다.
예제
이 예제는 데이터를 업로드하고, 함수를 실행하고, 양자 변환된 특성을 가져오는 방법을 보여줍니다. 전처리와 고전 모델 학습까지 포함한 엔드 투 엔드 예제는 튜토리얼을 참조하세요.
1. 데이터 업로드
이 예제는 숫자 특성 4개와 이진 레이블이 있는 작은 합성 데이터 세트를 사용하므로, 실행에 큐비트가 4개만 필요하고 빠르게 끝납니다. 다음 셀은 이를 학습 특성, 학습 레이블, 테스트 특성, 이 예제의 4단계에서 사용할 특성의 CSV 파일 4개로 기록합니다. 자신의 데이터를 사용하려면 전처리한 학습 세트와 테스트 세트를 같은 레이아웃의 파일로 대신 기록하세요.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
학습 파일과 테스트 파일을 업로드하세요. x_inference.csv는 4단계에서 업로드합니다.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. 함수 실행
함수 크기의 계산기로 업로드한 데이터에서 실행 크기를 계산하세요.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
데이터의 특성 수 이상의 큐비트를 가진 프로세서를 선택하고 해당 크기로 fit-transform 모드에서 함수를 실행하세요. 샘플 데이터에는 특성이 4개 있으므로 모든 IBM Quantum 프로세서에서 실행할 수 있습니다.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
다음과 같이 워크로드의 상태를 확인하거나 결과를 반환하세요.
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. 결과 가져오기
양자 변환된 특성을 다운로드하세요. 각 파일이 고유한 이름으로 저장되도록 target_name을 전달하세요.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. 새 데이터 매핑
모델을 학습시킨 후에는 피팅된 매핑으로 새 데이터를 매핑합니다. 예를 들어 추론을 실행할 때 사용합니다. 이 예제는 이 예제의 첫 번째 셀에서 기록한 x_inference.csv를 매핑합니다. 새 행이 새 매핑이 아니라 같은 매핑으로 매핑되도록 피팅에서 반환된 mapping_id를 전달하세요.
매핑은 하나의 프로세서의 큐비트 레이아웃에 맞게 만들어지므로 피팅과 같은 backend_name을 전달하세요. 이는 피팅이 result["backend_name"]으로 반환했습니다. least_busy()는 다른 프로세서를 반환할 수 있으므로 프로세서를 선택하는 데 사용하지 마세요. Rimay는 아무것도 제출하기 전에 다른 프로세서를 거부합니다. 샷 수도 피팅에서 가져옵니다.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. 매핑 삭제
피팅된 매핑이 더 이상 필요하지 않으면 삭제하세요. delete 실행은 양자 작업을 하지 않으므로 프로세서, 샷, 함수 크기가 필요하지 않습니다. 삭제는 되돌릴 수 없습니다. 삭제하면 mapping_id는 더 이상 아무것도 가리키지 않으며, 이를 사용하는 transform 실행은 실패합니다.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
오류 메시지 가져오기
워크로드 상태가 ERROR이면 다음과 같이 job.error_message()로 오류 메시지를 가져오세요.
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Rimay가 보고하는 모든 오류에는 IBM Quantum 오류 코드의 코드, 메시지, 그리고 전달한 값과 허용되는 값을 알려 주는 해결 방법이 포함됩니다. 다음 표에 가장 흔한 오류가 나와 있습니다.
| 코드 | 원인 |
|---|---|
1221 | 매개변수가 없거나 유형이 잘못되었거나, mode가 유효하지 않거나, input_file에 지정한 파일이 업로드되지 않았거나, 파일끼리 일치하지 않거나, 특성이 숫자가 아니거나, mapping_id가 저장된 매핑과 일치하지 않습니다. |
1221 | "transform" 실행이 해당 매핑을 만든 피팅과 다른 backend_name을 지정했습니다. |
1216 | 인스턴스에 전달한 backend_name의 프로세서가 없습니다. 해결 방법에 인스턴스가 가진 프로세서가 나열됩니다. |
1200 | API 키에 작업이 실행되는 인스턴스에 대한 접근 권한이 없습니다. |
3200 | backend_name이 ibm_로 시작하지 않습니다. |
4500 | 데이터의 특성 수가 프로세서의 큐비트 수보다 많습니다. |
6000 | 샘플 수에 shots를 곱한 값이 1,000만 번의 실행을 초과합니다. |
6001 | shots가 1보다 작습니다. |
6002 | 데이터의 샘플 수가 한 번의 실행에서 허용하는 수보다 많습니다. |
활용 사례
소규모 및 중규모 데이터 세트의 표 형식 분류에서 Kipu Quantum은 양자 특성 추출을 다음에 적용했습니다.
표 형식 데이터 외에도, 고정된 신경망이 이미지를 숫자 특성으로 변환하면 양자 특성 추출이 이를 양자 변환된 특성으로 매핑할 수 있습니다.
지원 받기
지원이 필요하면 support@kipu-quantum.com으로 문의하세요.
다음 단계
-
이 Qiskit Function의 API 레퍼런스를 방문하세요.
-
Kipu Quantum의 Rimay 양자 특성 추출로 신용 위험 분류하기 튜토리얼을 따라 해 보세요.
참고 문헌
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
추가 정보
Rimay는 "설명하다"를 뜻하는 케추아어 단어입니다.