Parity Twine Optimizer: ParityQC의 Qiskit Function
API 참조를 참조하세요
Qiskit Functions는 IBM Quantum® Premium Plan, Flex Plan, On-Prem(IBM Quantum Platform API를 통한) Plan 사용자만 이용할 수 있는 실험적 기능입니다. 미리보기 릴리스 상태이며 변경될 수 있습니다.
개요
Parity Twine Optimizer는 Parity Twine 방식을 사용하여 양자 컴퓨터로 최적화 문제를 해결할 수 있게 합니다. Parity Architecture를 기반으로 한 이 접근 방식은 ParityQC 컴파일러를 사용하여 장치 연결성을 고려하면서 양자 알고리즘 실행에 필요한 게이트 수와 회로 깊이를 최소화합니다.
이러한 리소스 절감을 통해 표준적이고 SWAP이 많은 트랜스파일 방법으로는 실행 불가능한 규모의 산업 관련 최적화 문제를 해결할 수 있습니다. Parity Twine Optimizer는 트랜스파일 단계를 자동화하며 최소한의 사용자 입력으로 사용할 수 있습니다.
Parity Twine 방식은 양자 근사 최적화 알고리즘(QAOA) 및 양자 푸리에 변환(QFT)과 같은 양자 알고리즘에 대해 게이트 수와 회로 깊이를 줄이는 측면에서 다른 모든 컴파일 방법을 능가합니다. 양자 정보를 물리적 큐비트로부터 추상화함으로써 비국소적 상호작용이 SWAP 게이트 없이 구현됩니다. 대신 Parity Twine 체인(CNOT 게이트 시퀀스)이 큐비트 간에 논리적 패리티 정보를 체계적으로 분배합니다.
이 최적화기는 QAOA를 사용하여 주어진 비용 함수의 에너지를 최소화합니다. QAOA는 비용 해밀토니안()의 바닥 상태를 근사함으로써 조합 최적화 문제를 해결하도록 설계된 하이브리드 양자-고전 변분 알고리즘입니다. 믹싱 항()은 상태 간 전이를 유도하여 솔루션 공간을 탐색합니다. 매개변수 와 로 제어되는 이 항들의 교대 시퀀스는 초기 상태에 작용하는 유니터리 를 정의합니다.
문제 유니터리 exp()의 인코딩은 모든 논리적 체 회전 연산자(exp())의 인코딩을 필요로 합니다. 이는 체 생성자(Parity Twine 네트워크)를 사용하여 달성할 수 있으며, 이는 QAOA 회로 깊이와 2큐비트 게이트 수를 줄입니다.
설명
Parity Twine Optimizer의 입력은 최적화 문제, 선택한 IBM Quantum 하드웨어 이름, 그리고 트랜스파일 및 하드웨어 실행 설정을 조정하기 위한 추가 선택적 인수로 구성됩니다. 최적화기 함수는 문제 정의를 Parity Twine 컴파일러로 라우팅합니다. 그림 1은 함수 워크플로의 요약을 보여줍니다.
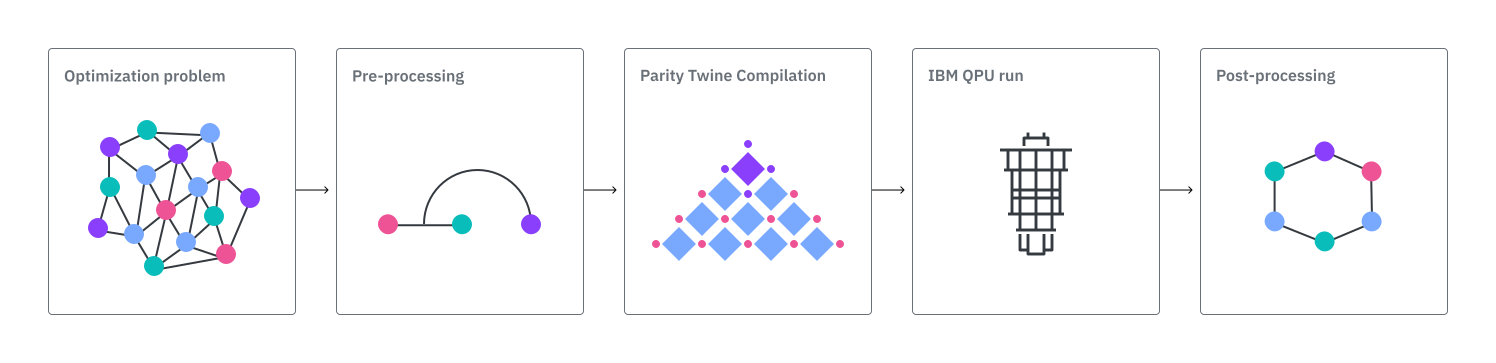
입력 최적화 문제는 (정규화된) 해밀토니안으로 전처리됩니다. 그런 다음 ParityQC 컴파일러는 매개변수화된 Parity Twine 앤사츠 회로를 구성하며, 이는 선택한 하드웨어의 네이티브 게이트 세트에 맞는 논리적 앤사츠로 트랜스파일됩니다.
QAOA 회로 매개변수는 "efficient depth one" 접근 방식을 사용하여 고전적으로 최적화되고 트랜스파일된 회로에 할당됩니다. QAOA의 한 라운드만 사용되므로, 최적의 와 매개변수는 많은 회로 호출에 대한 비용이 많이 드는 반복 최적화 없이 CPU에서의 그리드 검색을 사용하여 얻어집니다. 덕분에 최적화기에 필요한 QPU 실행 시간이 크게 줄어들어요. 회로당 실행 시간은 대부분 QPU에서 작업을 실행하는 데 드는 일정한 오버헤드에 의해 결정됩니다. 회로 매개변수가 설정되면 작업이 지정된 IBM® QPU로 제출됩니다.
그런 다음 원시 결과가 후처리됩니다. 이 단계는 솔루션 문자열의 비트를 무작위 순서로 훑으면서 비용 함수 값을 줄이는 경우 비트 값을 뒤집는 로컬 그리디 탐색을 사용합니다.
벤치마크
성능은 문제 인스턴스와 이후 처리 단계 모두에 따라 달라질 수 있습니다. 경우에 따라 고전적 샘플과 양자 생성 샘플이 동등한 후처리 후 유사한 최종 솔루션 품질을 달성할 수 있습니다. 따라서 평가에는 전체 최적화 워크플로를 고려해야 합니다.
셰링턴-커크패트릭 모델
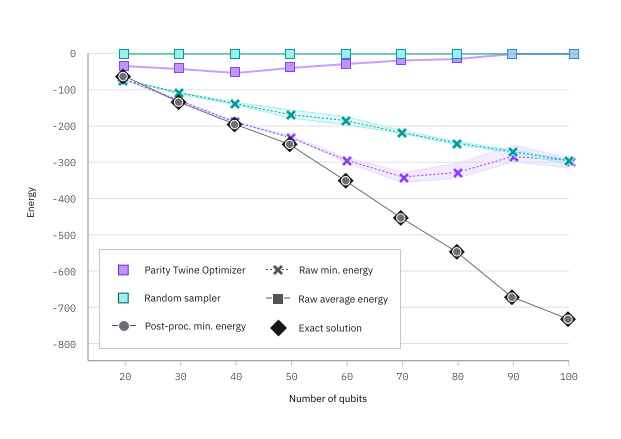
그림 2는 Parity Twine Optimizer의 효과를 보여줍니다. 이는 큐비트 수가 증가하는 셰링턴-커크패트릭 모델에 대해 최적화기를 사용하여 얻은 결과를 무작위 샘플링과 비교합니다.
무작위 결과와 최적화기 결과 모두의 후처리는 정확한 바닥 상태로 이어지지만, Twine QAOA의 원시 최소 에너지 출력은 항상 무작위 값보다 좋습니다. 고려된 최대 큐비트 수(90 및 100)의 경우, 하드웨어 노이즈로 인해 최적화기 결과가 저하되어 무작위 샘플링과 일치하는 원시 값으로 되돌아갑니다.
셰링턴-커크패트릭 모델 소개와 Parity Twine Optimizer로 이를 해결하는 방법에 대한 자세한 내용은 이 튜토리얼을 참조하세요.
마켓 스플릿 문제
표 1은 마켓 스플릿(MS) 문제의 다양한 인스턴스에 적용된 Parity Twine Optimizer의 구체적인 성능 지표를 보여줍니다. 이는 QOBLIB - 양자 최적화 벤치마킹 라이브러리에서 얻어졌으며 Parity Twine Optimizer를 사용하여 라이브러리에 제출된 제출물에 해당합니다.
MS 위반은 솔루션이 모든 제약을 만족시키는 것에서 얼마나 벗어났는지를 측정하는 정확도 지표로, 로 정의됩니다. 이 지표 값이 낮을수록 더 정확한 솔루션을 나타냅니다.
표 1은 ibm_boston 장치를 백엔드로 사용하고 100,000샷을 사용한 Parity Twine Optimizer로 각 인스턴스를 5회 실행한 평균값을 보고합니다.
각 인스턴스 실행에서 얻은 최소 MS 위반이 보고됩니다.
| 인스턴스 | 큐비트 | 2큐비트 게이트 | 2큐비트 깊이 | MS 위반 | 매핑 시간(초) | QPU 실행 시간(초) | 후처리 시간(초) |
|---|---|---|---|---|---|---|---|
| ms_03_050_002 | 20 | 399 | 76 | 0 | 45 | 29 | 71 |
| ms_03_100_022 | 20 | 399 | 76 | 0 | 30 | 29 | 77 |
| ms_03_200_177 | 20 | 399 | 76 | 0 | 33 | 29 | 63 |
| ms_04_050_001 | 30 | 899 | 116 | 1 | 68 | 29 | 216 |
| ms_04_100_003 | 30 | 899 | 116 | 2 | 89 | 29 | 187 |
| ms_04_200_030 | 30 | 899 | 116 | 3 | 89 | 29 | 219 |
| ms_05_100_003 | 40 | 1599 | 156 | 3 | 237 | 30 | 364 |
| ms_06_050_001 | 50 | 2499 | 196 | 4 | 499 | 30 | 464 |
| ms_07_050_001 | 60 | 3599 | 236 | 17 | 858 | 31 | 637 |
| ms_08_050_001 | 70 | 4899 | 276 | 36 | 1561 | 31 | 773 |
표 1: 마켓 스플릿 문제의 다양한 인스턴스에 대한 성능 지표. 인스턴스 이름은 QOBLIB 문제 라이브러리의 해당 예제에 대한 것입니다. 설명 섹션에서 앞서 언급했듯이, CPU에서 얻은 최적의 회로 매개변수로 QAOA의 한 라운드만 사용되므로 QPU 시간은 최소한이며 거의 일정합니다.
마켓 스플릿 문제 소개와 Parity Twine Optimizer로 이를 해결하는 방법에 대한 자세한 내용은 이 튜토리얼을 참조하세요.
최대 독립 집합 문제
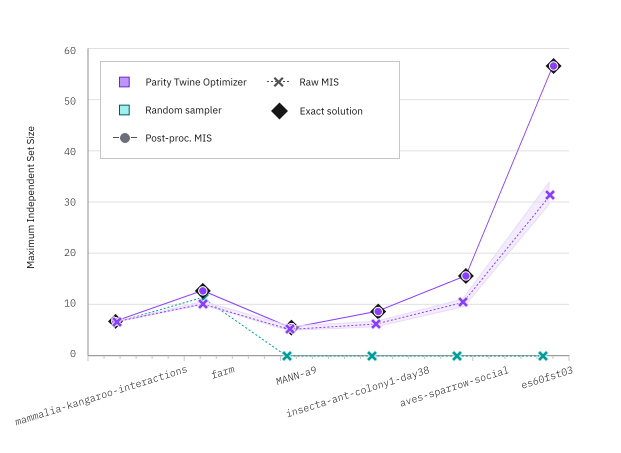
그림 3은 QOBLIB - 양자 최적화 벤치마킹 라이브러리에서 얻은 선택된 인스턴스에 대해 최대 독립 집합 문제에 대해 Parity Twine 최적화기를 사용하여 얻은 결과를 무작위 샘플링과 비교합니다. 이는 18(mammalia-kangaroo-interactions)개부터 114(es60fst03)개까지의 큐비트 범위입니다.
작은 인스턴스의 경우 최적화기와 무작위 샘플링의 원시 최대 독립 집합 크기 결과는 유사하지만, 더 큰 인스턴스의 경우 최적화기가 훨씬 더 좋은 결과를 제공합니다. 무작위 샘플링 결과와 최적화기 결과 모두의 후처리는 다시 정확한 값과 일치하는 세트 크기로 이어집니다.
시작하기
IBM Quantum Platform API 토큰을 사용하여 인증하고 Qiskit Function을 다음과 같이 선택합니다.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

# Authenticate and load the Qiskit Function
catalog = QiskitFunctionsCatalog(
    channel="ibm_quantum_platform",
)
function = catalog.load("parityqc/parity-twine-optimizer")
예제
Parity Twine Optimizer는 다음과 같이 간단한 QUBO 예제에 적용할 수 있습니다. 문제는 먼저 딕셔너리를 사용하여 정의됩니다:
problem = {"()": 3, "(0,)": 1, "(0, 1)": 2, "(1, 2)": -1}
그런 다음 변수 유형을 binary 또는 spin으로 정의해야 합니다:
variable_type = "spin"
이는 인 목적 함수 를 정의합니다.
백엔드를 선택합니다. 예를 들면:
backend_name = "ibm_phoenix"
사용자 계정/인스턴스에서 사용 가능한 백엔드 목록을 보려면 catalog.backends()를 사용하세요.
백엔드가 지정되지 않은 경우 가장 한가한 백엔드(대기 중인 작업 수가 가장 적은 백엔드)가 자동으로 선택됩니다.
최적화기가 로드되면(앞서 참조) 기본 옵션을 사용하여 문제에 대해 실행할 수 있습니다:
function_job = function.run(
    problem=problem, variable_type=variable_type, backend_name=backend_name
)
print(f"Job ID: {function_job.job_id}")
다음과 같이 작업 상태를 확인합니다:
# Monitor the job status
function_job.status()
다음과 같이 결과를 가져와요:
# Retrieve the job result if the status is DONE
result = function_job.result()

result
결과를 출력하면 다음과 같이 나타납니다:
{
    'solution': {'0': -1, '1': 1, '2': 1},
    'objective_value': -1.0,
    'solution_bitstring': '100',
    'metadata': {
        'circuit_metrics': {
            'depth': 20,
            'gate_count': 198,
            'two_qubit_gate_depth': 4,
            'two_qubit_gate_count': 4,
            'num_qubits': 3,
            'operations': {'delay': 158, 'rz': 17, 'sx': 14, 'cz': 4, 'measure': 3, 'x': 2}
        },
        'solver_info': {
            'variable_mapping': {'0': 0, '1': 1, '2': 2},
            'bitstring_distributions': {
                'before_postprocessing': {'100': 71760, ... },
                'after_postprocessing': {'100': 88440, '011': 11560}
            },
            'best_parameters': {
                'beta': [-0.46259546391008877],
                'gamma': [0.6181957189727373]
            }
        },
        'resource_usage': {
            'RUNNING: MAPPING': {'CPU_TIME': 42.878},
            'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 0.094},
            'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 790.623},
            'RUNNING: EXECUTING_QPU': {'QPU_TIME': 28.0},
            'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.828}
        }
    }
}
solution 딕셔너리는 문제에 정의된 큐비트(, )에 해당하며 최적화된 스핀 값을 제공합니다.
objective_value는 최적화 문제의 비용 또는 에너지입니다. 이는 solution의 품질을 정량화합니다.
metadata는 트랜스파일에 대한 정보(2큐비트 게이트 수/깊이, 사용된 게이트, 활성 큐비트)와 양자 및 고전 컴퓨팅 시간 모두에 대한 다양한 런타임을 제공합니다.
또한 metadata는 알고리즘의 내부 작동 방식을 엿볼 수 있게 해줍니다. 최적화된 변분 매개변수(beta 및 gamma)를 볼 수 있으며, 원시 양자 결과에 고전적 후처리가 적용된 후 측정된 비트스트링의 분포가 어떻게 개선되었는지 검토할 수 있습니다.
결과 출력의 모든 비트스트링은 variable_mapping을 사용하여 문제 변수에 매핑될 수 있습니다.
예를 들어, 'solution_bitstring': '100'을 'variable_mapping': {'0': 0, '1': 1, '2': 2}를 사용하여 이진 솔루션 {'0': 1, '1': 0, '2': 0}에 매핑할 수 있습니다.
스핀 변수로 문제를 해결하고 있으므로 이진에서 스핀으로의 변환(0 -> 1, 1 -> -1)을 적용해야 합니다.
그러면 최종 솔루션 'solution': {'0': -1, '1': 1, '2': 1}에 도달합니다.
Parity Twine Optimizer 함수의 입력 및 출력에 대한 자세한 내용은 API 참조를 참조하세요.
변경 로그
[1.0.2] - 2026-09-15
Notes
이번 릴리스는 Parity Twine Optimizer Qiskit Function의 첫 번째 안정 프로덕션 버전이에요. 향후 릴리스에서는 다음이 도입될 예정이에요:
- 고차 문제 컴파일,
- 추가 최적화 알고리즘,
- 전처리 및 후처리 개선.
기능
- 효율적인 Parity Twine 컴파일러로 희소 및 밀집 QUBO 문제를 해결합니다.
문서
- 시작하기 사용자 가이드.
- 마켓 스플릿 및 셰링턴-커크패트릭 문제에 대한 예제가 포함된 튜토리얼.
- API 문서.
지원 받기
질문이나 문제가 있으면 ParityQC에 문의하세요.
다음 단계
- 양식을 작성하여 이 함수에 대한 액세스를 요청하세요.
- 이 Qiskit Function에 대한 API 참조를 방문하세요.
- 마켓 스플릿 문제에 Parity Twine Optimizer를 적용하는 튜토리얼을 시도해 보세요.
- 셰링턴-커크패트릭 모델에 Parity Twine Optimizer를 적용하는 튜토리얼을 시도해 보세요.
- Connectivity-aware Synthesis of Quantum Algorithms, Drier et al. (2025) ArXiv 프리프린트를 검토하세요.