JIJ의 SQOA Solver로 큐비트 수보다 변수가 많은 최대 독립 집합 문제 풀기
Qiskit Functions는 IBM Quantum® Premium Plan, Flex Plan, On-Prem(IBM Quantum Platform API 경유) Plan 사용자에게만 제공되는 실험적 기능입니다. 프리뷰 릴리스 상태이며 변경될 수 있습니다.
사용량 추정: Heron r2 프로세서에서 10초. (참고: 추정치일 뿐이며 실제 실행 시간은 다를 수 있습니다.)
배경
이 튜토리얼에서는 JIJ의 Qiskit Function인 SQOA Solver를 사용하여, 선택한 QPU의 큐비트 수보다 이진 변수가 많은 최대 독립 집합(MIS) 문제를 푸는 방법을 보여줍니다. 기본 단계는 Quantum Optimization Benchmarking Library (QOBLIB) [1]에서 MIS 인스턴스를 불러오고, qiskit-addon-opt-mapper로 이차 비제약 이진 최적화(QUBO) 형태로 정식화한 다음, IBM® QPU에서 실행하도록 SQOA Solver에 제출하고, 반환된 해를 검증하는 것입니다.
최대 독립 집합 문제
독립 집합은 선택된 어떤 두 노드도 간선을 공유하지 않는 그래프의 노드 부분집합입니다. 최대 독립 집합(MIS)은 노드 수가 가능한 한 가장 많은 독립 집합입니다. MIS의 응용 분야로는 스케줄링, 자원 할당, 네트워크 설계 등이 있습니다.
MIS는 NP-hard입니다. 전수 탐색에서는 노드가 하나 추가될 때마다 고려해야 할 부분집합의 수가 두 배가 되므로, 중간 규모의 그래프에서도 이 방식은 비현실적입니다. QOBLIB은 열 가지 문제 유형 중 하나로 MIS를 포함하고 있어, 실제 하드웨어에서 양자 최적화 워크플로를 평가하는 데 유용한 벤치마크입니다.
수학적 정식화
무방향 그래프 가 주어지면, 각 노드 에 이진 변수 를 할당합니다.
-
노드 가 선택되면 입니다.
-
otherwise.
이진 선형 정식화는 선택된 노드 수를 최대화하면서 어떤 간선의 양 끝점도 함께 선택되지 않도록 합니다.
목적 함수는 선택된 노드 수를 셉니다. 간선 제약 조건이 함께 작용하여 선택된 노드들이 독립 집합을 이루도록 보장합니다.
이 튜토리얼에서는 간선 제약 조건을 이차 페널티로 대체하는 QOBLIB의 이진 비제약 정식화를 사용합니다.
간선의 양 끝점이 모두 선택될 때마다 두 번째 항이 목적 함수에서 2를 뺍니다. 이 페널티 때문에 충돌하는 선택은 어느 한쪽 끝점만 유지하는 것보다 불리해집니다. 결과로 얻는 목적 함수는 QUBO이며, 이는 SQOA Solver가 받아들이는 입력 형식입니다.
SQOA Solver를 사용하는 이유
많은 양자 최적화 접근법은 이진 변수마다 큐비트 하나를 할당하므로, 양자 하드웨어의 용량이 문제 크기를 직접 제한할 수 있습니다. SQOA Solver는 이러한 제한을 완화하기 위해 여러 축소 기법과 하이브리드 컴퓨팅 기법을 결합합니다.
-
QPU의 큐비트 수보다 이진 변수가 많은 문제를 다룰 수 있습니다. Presolve는 최소 하나의 최적해를 보존하면서 변수를 고정하고 나머지 QUBO를 단순화할 수 있는 축소 규칙을 적용합니다. 경험적으로 presolve는 나머지 QUBO를 더 희소하게 만들 수도 있으며, 이는 뒤따르는 QRAC 기반 인코딩에 도움이 됩니다.
그런 다음 솔버는 Quantum Random Access Optimization(QRAO) [3]에서 유래한 QRAC 기반 인코딩을 사용하여, QUBO에서 직접 상호작용이 없는 여러 변수(최대 세 개)를 하나의 큐비트에 표현합니다.
presolve와 인코딩으로 인한 축소 정도는 문제 구조에 따라 달라집니다. 예를 들어 이 튜토리얼에서는 변수 200개짜리 문제가 큐비트 67개만 사용합니다.
-
하드웨어 노이즈에 덜 민감할 수 있습니다. 샘플 기반 양자 대각화 [4], [5]는 QPU를 비트열 샘플링에 사용하고 대각화는 고전적으로 수행합니다. 이렇게 하면 변분 매개변수 업데이트를 위한 반복적인 QPU 평가를 피할 수 있고, 최적화 워크플로에 미치는 노이즈의 영향을 줄일 수 있습니다.
-
presolve부터 후처리까지의 워크플로를 자동화합니다. 올바른 형식의 QUBO 인스턴스를 제공하고 백엔드를 선택하면 됩니다. 그러면 SQOA Solver가 전체 워크플로를 자동으로 실행합니다. presolve를 적용하고, 고전 변수를 이완된 양자 문제로 매핑하며, 샘플링 회로를 구성하고 트랜스파일하고, 양자 샘플링과 고전 대각화를 수행하고, 할당을 반올림하여 개선하고, 고전적 해를 재구성하여 평가합니다.
요구 사항
이 튜토리얼을 시작하기 전에 다음 패키지가 설치되어 있는지 확인하세요.
-
Qiskit Functions Catalog 클라이언트(
pip install qiskit-ibm-catalog). -
문제를 정식화하는 데 사용하는 Qiskit addon optimization mapper(
pip install qiskit-addon-opt-mapper). -
그래프를 다루고 그리는 데 사용하는 NetworkX와 Matplotlib(
pip install networkx matplotlib).
또한 Qiskit Functions Catalog에서 SQOA Solver에 접근할 수 있어야 합니다. 양식을 작성하여 이 함수에 대한 접근을 요청하세요.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "networkx": "networkx", "ommx": "ommx", "ommx_quantum_benchmarks": "ommx-quantum-benchmarks", "qiskit_addon_opt_mapper": "qiskit-addon-opt-mapper", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# %pip install qiskit-ibm-catalog qiskit-addon-opt-mapper networkx matplotlib
설정
먼저 필요한 패키지와 도구를 가져옵니다.
import urllib.request

import matplotlib.pyplot as plt
import networkx as nx
from qiskit_addon_opt_mapper import OptimizationProblem
from qiskit_addon_opt_mapper.converters import OptimizationProblemToQubo
from qiskit_ibm_catalog import QiskitFunctionsCatalog
SQOA Solver는 IBM® 최적화 함수에서 사용하는 튜플-문자열 형식의 계수 딕셔너리로 QUBO 문제를 받습니다. OptimizationProblemToQubo가 반환하는 QUBO를 이 형식으로 변환하는 헬퍼 함수를 정의합니다.
변환기는 항상 최소화 문제를 반환하며, 이는 SQOA Solver가 딕셔너리 문제를 다루는 방식과 일치합니다. 키는 QUBO의 변수 인덱스를 사용하며, 반환된 해가 모든 변수를 포함하도록 계수가 0이더라도 모든 변수에 선형 항목이 포함됩니다.
def to_problem_dict(qubo: OptimizationProblem) -> dict[str, float]:
    """Convert a QUBO from OptimizationProblemToQubo to the SQOA Solver dictionary format."""
    objective = qubo.objective
    payload = {"()": objective.constant}
    # Keep every variable in the problem, even with a zero linear coefficient.
    payload.update({f"({i},)": 0.0 for i in range(qubo.get_num_vars())})
    for i, coefficient in objective.linear.to_dict().items():
        payload[f"({i},)"] += coefficient
    for (i, j), coefficient in objective.quadratic.to_dict().items():
        # Fold a binary diagonal term x_i * x_i = x_i into the linear term.
        key = f"({i},)" if i == j else f"({i}, {j})"
        payload[key] = payload.get(key, 0.0) + coefficient
    return {key: float(value) for key, value in payload.items()}
1단계: 고전 입력을 양자 문제로 매핑하기
SQOA Solver는 QUBO 문제를 받아 함수 내부에서 양자 매핑을 수행합니다. 이 튜토리얼에서는 QOBLIB에서 MIS 인스턴스를 다운로드하고 qiskit-addon-opt-mapper로 QUBO로 정식화합니다. 이 단계에서는 다음을 다룹니다.
-
SQOA Solver에 연결합니다.
-
SQOA 프레임워크를 이해합니다.
-
문제 인스턴스를 불러옵니다.
-
QUBO를 정식화하고 제출용으로 변환합니다.
SQOA Solver에 연결하기
IBM Quantum Platform 자격 증명으로 Qiskit Functions Catalog에 연결한 다음 SQOA Solver를 불러옵니다. 다음 코드는 이미 로컬 환경에 계정을 저장했다고 가정합니다.
연결에 실패하면 IBM Quantum Platform 계정 관리자가 선택한 서비스 인스턴스에 SQOA Solver 접근 권한을 부여했는지 확인하세요.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
solver = catalog.load("jij/sqoa-solver")
SQOA 프레임워크 이해하기
양자 이완을 사용한 샘플링 기반 양자 최적화 알고리즘(SQOA-QR) [2]은 Quantum Random Access Optimization(QRAO)과 샘플 기반 양자 대각화를 결합합니다.
-
양자 이완 및 인코딩: SQOA Solver는 QUBO를 형태의 최소화 Ising 목적 함수로 변환합니다. 여기서 입니다. 그런 다음 QRAO [3]가 각 스핀 변수를 파울리 관측량에 매핑합니다. 여기서 사용하는 -QRAC 인코딩에서 이완된 해밀토니안은 다음과 같습니다.
여기서 는 항등 연산자이고, 는 변수 를 하나의 큐비트와 , , 중 하나에 할당하며, 는 와 같은 큐비트에 매핑된 변수의 수입니다. 관련된 두 큐비트에 각각 변수가 세 개씩 들어 있으면, 선형 및 이차 스케일링 인자는 각각 과 이 됩니다.
같은 큐비트를 공유하는 변수에는 서로 교환하지 않는 다른 파울리 관측량이 할당됩니다. QUBO에서 상호작용하는 변수는 서로 다른 큐비트에 두고, QUBO에서 직접 상호작용이 없는 변수는 한 큐비트를 공유할 수 있습니다. 따라서 큐비트 수의 감소 정도는 문제 구조에 따라 달라집니다.
-
양자 샘플링: 양자 프로세서가 이완된 해밀토니안의 낮은 에너지 상태를 탐색하도록 설계된 회로에서 비트열을 샘플링합니다.
-
샘플 기반 대각화: 솔버는 이완된 해밀토니안을 샘플링된 비트열에서 얻은 기저 상태들이 span하는 부분공간에 사영하고, 사영된 해밀토니안을 고전적으로 대각화합니다 [4], [5]. 샘플링된 비트열 집합이 고정되어 있을 때, 을 서로 다른 개의 기저 상태가 생성하는 부분공간이라고 하면 입니다. 추정 바닥 상태 에너지는 다음과 같습니다.
여기서 는 이완된 전체 해밀토니안의 바닥 상태 에너지입니다. 따라서 유지하는 부분공간이 커져도 추정 바닥 상태 에너지는 증가할 수 없습니다.
이 순서 관계는 샘플링 결과가 같다고 가정하며, 반올림 이전의 이완된 해밀토니안 에너지에 관한 것입니다. 반환되는 고전적 해가 더 좋아진다는 것을 이론적으로 보장하지는 않습니다. 다만 QRAO에서는 더 낮은 에너지 상태가 휴리스틱하게 더 좋은 고전적 해를 제공할 것으로 기대됩니다.
-
반올림: 대각화로 얻은 이완된 상태를 고전적인 이진 할당으로 변환합니다.
SQOA Solver는 이 프레임워크를 고전 처리로 감쌉니다. 양자 매핑 전에 presolve가 최소 하나의 최적해를 보존하면서 변수를 고정하고 나머지 QUBO를 단순화할 수 있는 축소 규칙을 적용합니다. 대각화와 반올림 후에는 고전 국소 탐색이 할당을 개선하고, OMMX가 전체 해를 재구성하여 평가합니다.
인스턴스 불러오기
QOBLIB은 각 MIS 인스턴스를 DIMACS .gph 형식의 그래프로 배포합니다. 이는 줄 단위 형식으로, p로 시작하는 줄은 노드와 간선의 수를 나타내고 e로 시작하는 각 줄은 간선 하나를 정의합니다.
QOBLIB은 각 인스턴스에 대해 최적해 또는 알려진 최선의 참조 해도 함께 공개합니다. 다음 함수들은 QOBLIB 저장소에서 둘 다 다운로드합니다. DIMACS는 노드 번호를 1부터 매기므로, 그래프는 0부터 시작하도록 다시 레이블링합니다.
대신 자신의 그래프로 시작하려면 다운로드를 건너뛰고 NetworkX 그래프로부터 같은 방식으로 문제를 정식화하세요.
QOBLIB_URL = "https://raw.githubusercontent.com/ZIB-AOPT/QOBLIB/refs/heads/main/07-independentset"

def fetch_qoblib_graph(name: str) -> nx.Graph:
    """Download a QOBLIB independent-set instance as a NetworkX graph."""
    with urllib.request.urlopen(
        f"{QOBLIB_URL}/instances/{name}.gph"
    ) as response:
        lines = response.read().decode().splitlines()
    graph = nx.Graph()
    for fields in map(str.split, lines):
        if fields and fields[0] == "p":
            # Header: p edge <number of nodes> <number of edges>
            graph.add_nodes_from(range(int(fields[2])))
        elif fields and fields[0] == "e":
            # DIMACS labels nodes from 1; relabel them to start from 0.
            graph.add_edge(int(fields[1]) - 1, int(fields[2]) - 1)
    return graph

def fetch_reference_objective(name: str) -> float:
    """Read the objective value of the QOBLIB reference solution."""
    with urllib.request.urlopen(
        f"{QOBLIB_URL}/solutions/{name}.opt.sol"
    ) as response:
        for line in response.read().decode().splitlines():
            if line.startswith("# Objective value"):
                return float(line.split("=")[1])
    raise ValueError(f"No objective value found for {name}.")

INSTANCE_NAME = "gen200_p0-9_44"
G = fetch_qoblib_graph(INSTANCE_NAME)
reference_objective = fetch_reference_objective(INSTANCE_NAME)
참조 해의 목적 함수 값은 나중에 SQOA Solver의 결과를 평가하는 데 사용합니다. 이 튜토리얼은 이 문제를 156큐비트 장치에서 풉니다.
print(
    f"{INSTANCE_NAME}: {G.number_of_nodes()} nodes, {G.number_of_edges()} edges"
)
print(f"Reference objective: {reference_objective:g}")
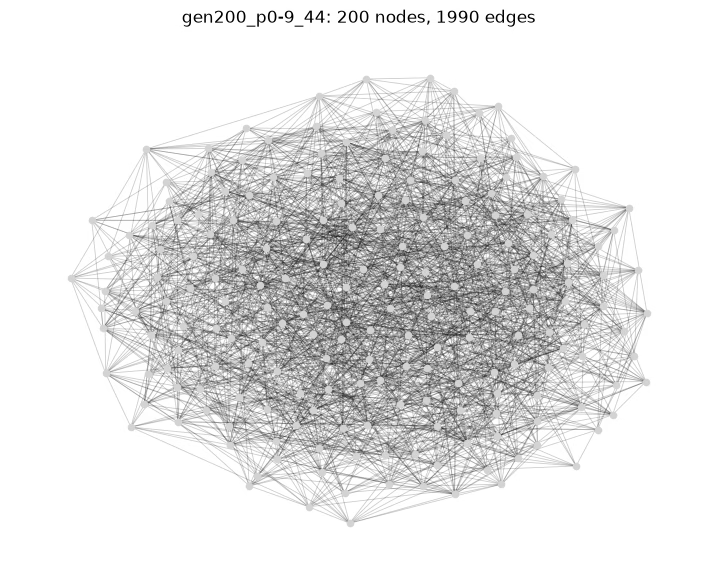
gen200_p0-9_44: 200 nodes, 1990 edges
Reference objective: 44
그래프를 시각화합니다. 나중에 SQOA Solver가 반환한 노드가 독립 집합을 이루는지 검증할 때도 이 그래프를 사용합니다.
layout = nx.forceatlas2_layout(
    G, max_iter=500, scaling_ratio=3.0, gravity=1.0, seed=7
)
node_size = max(8, min(60, 4000 / max(G.number_of_nodes(), 1)))

fig, ax = plt.subplots(figsize=(9, 7))
nx.draw_networkx_edges(G, layout, ax=ax, alpha=0.2, width=0.6)
nx.draw_networkx_nodes(
    G, layout, node_size=node_size, node_color="lightgray", ax=ax
)
ax.set_title(
    f"{INSTANCE_NAME}: {G.number_of_nodes()} nodes, {G.number_of_edges()} edges"
)
ax.set_axis_off()
plt.show()
QUBO 정식화하기
배경 섹션의 이진 선형 정식화를, 노드당 이진 변수 하나, 선택된 노드 수를 세는 목적 함수, 간선당 제약 조건 하나를 가진 OptimizationProblem으로 구성합니다. 그런 다음 OptimizationProblemToQubo로 변환합니다.
페널티 가중치가 2이면 변환기는 각 간선 제약 조건을 페널티 항 로 대체하고 최대화를 최소화로 바꾸므로, 변환된 문제는 부호가 반전된 QOBLIB의 이진 비제약 정식화가 됩니다. QUBO의 변수 인덱스는 그래프의 노드 레이블입니다. qiskit_addon_opt_mapper.applications의 IndependentSet 애플리케이션 클래스는 IndependentSet(G).to_optimization_problem()으로 같은 제약 모델을 구성합니다.
마지막으로 to_problem_dict()로 QUBO를 딕셔너리 형식으로 변환합니다. 이 문제는 이진 QUBO이므로 2단계의 요청에서는 변수 도메인을 "binary"로 선언합니다. 함수는 제출 후에 presolve, 양자 매핑, 회로 구성을 수행합니다.
mis = OptimizationProblem(INSTANCE_NAME)
mis.binary_var_list(G.number_of_nodes(), name="x")
mis.maximize(linear={v: 1 for v in G.nodes})
for u, v in G.edges:
    mis.linear_constraint({u: 1, v: 1}, "<=", 1)

converter = OptimizationProblemToQubo(penalty=2)
qubo = converter.convert(mis)
problem_dict = to_problem_dict(qubo)

print(f"QUBO variables: {qubo.get_num_vars()}")
print(f"Dictionary entries: {len(problem_dict)}")
QUBO variables: 200
Dictionary entries: 2191
2단계: 양자 하드웨어 실행을 위해 문제 최적화하기
SQOA Solver는 함수 내부에서 양자 매핑과 하드웨어 준비를 수행합니다. 먼저 QUBO에 presolve를 적용한 다음, QRAC 기반 인코딩을 사용하여 나머지 변수를 이완된 해밀토니안으로 매핑합니다.
양자 샘플링을 위해 이완된 해밀토니안을 기반으로 회로를 구성하고 선택한 백엔드에 맞게 트랜스파일합니다. presolve와 인코딩으로 인한 문제 크기 및 큐비트 감소는 문제에 따라 달라지므로, 고정된 감소 배율을 가정하지 말고 솔버를 구성하세요.
솔버 입력 구성하기
SQOA Solver에는 두 가지 입력이 필요합니다.
-
problem, 1단계에서 만든 딕셔너리. -
variable_type, 이 QUBO에서는"binary"입니다.
선택적으로 두 가지 입력도 받을 수 있습니다.
-
backend_name은 QPU를 선택합니다. 생략하거나None이면, 함수는 인스턴스에서 접근할 수 있는 운영 중인 QPU 중 가장 한가한 QPU를 선택합니다. -
options는 샘플링 예산(shots), 고전 시드(seed), 세션 사용(session), 고전 국소 탐색(postprocessing_level), 작업 태그(job_tags)를 제어하는 딕셔너리입니다.shots를 늘리면 샘플링 통계가 개선될 수 있습니다.
모든 입력과 기본값, 검증 규칙은 API 레퍼런스를 참조하세요.
이 튜토리얼에서는 백엔드를 명시적으로 지정하고, shots, session, postprocessing_level에는 기본값을 사용하며, 고전 시드를 설정합니다. 3단계에서 solver.run()에 전달할 수 있도록 입력을 딕셔너리로 모읍니다.
# ibm_fez has 156 qubits
backend_name = (
    "ibm_fez"  # Omit this key or pass None for automatic selection.
)

sqoa_input = {
    "problem": problem_dict,
    "variable_type": "binary",
    "backend_name": backend_name,
}
sqoa_input["options"] = {
    "shots": 4096,
    "seed": 42,
    "session": False,
    "postprocessing_level": 1,
}
3단계: 프리미티브를 사용하여 실행하기
1단계에서 만든 SQOA Solver 연결로 작업을 제출합니다. 함수는 선택한 백엔드에서 IBM Quantum Sampler 프리미티브를 실행하고, 측정된 비트열을 수집한 다음, 고전 대각화와 후처리를 이어서 진행합니다. 사용자는 하나의 함수 작업만 다루면 됩니다.
job = solver.run(**sqoa_input)
print(f"Job ID: {job.job_id}")
Job ID: dcee8e26-b8ac-4dd7-a76e-5adb5bc388e5
워크로드의 상태를 확인하려면 작업 상태 확인을 참조하세요. 내부적으로 함수는 매핑, 하드웨어 최적화, 대기열 대기, QPU 실행, 후처리 단계를 차례로 거칩니다.
job.status()
'INITIALIZING'
job.result()는 작업이 완료될 때까지 대기한 후, 해와 그 목적 함수 값 및 실현 가능성, 그리고 솔버 정보와 리소스 사용량을 담은 메타데이터가 들어 있는 딕셔너리를 반환합니다. 입력과 출력의 전체 정의는 API 레퍼런스를 참조하세요.
result = job.result()
4단계: 결과를 후처리하고 고전 형식으로 변환하기
전체 함수 출력을 살펴보고, 반환된 할당을 그래프로 되돌려 매핑하고, 선택된 노드를 검증한 다음, 결과를 시각화합니다.
결과 살펴보기
결과 딕셔너리에는 네 개의 최상위 필드가 있습니다.
-
solution은x_i를 키로 하는 완전한 변수 할당이며, 여기서 _i_는 변수 인덱스입니다(예:x_17). 이 튜토리얼에서 변수 인덱스는 노드 레이블입니다. -
objective_value는 제출된 딕셔너리, 즉 최소화 QUBO에서 평가한 해당 할당의 목적 함수 값입니다. -
딕셔너리에는 제약 조건이 없으므로
feasible은 변수 도메인에 대해서만 해당됩니다. -
metadata에는solver_info와resource_usage가 들어 있습니다.solver_info는 실행에 사용된 유효한seed를 기록합니다. 고전 국소 탐색이 실행된 경우solver_info에는 개선 이전의 반올림된 할당도solution_before_postprocessing에 기록됩니다.
solver_info = result["metadata"]["solver_info"]

print(f"Result fields: {list(result)}")
print(f"Solution entries: {len(result['solution'])}")
print(f"First entries: {dict(list(result['solution'].items())[:3])}")
print(f"Objective value: {result['objective_value']}")
print(f"Feasible: {result['feasible']}")
print(f"Solver-info fields: {list(solver_info)}")
print(f"Effective seed: {solver_info['seed']}")
print(f"Resource-usage phases: {list(result['metadata']['resource_usage'])}")
Result fields: ['solution', 'objective_value', 'feasible', 'metadata']
Solution entries: 200
First entries: {'x_0': 0.0, 'x_1': 0.0, 'x_2': 1.0}
Objective value: -35.0
Feasible: True
Solver-info fields: ['seed', 'solution_before_postprocessing']
Effective seed: 42
Resource-usage phases: ['RUNNING: MAPPING', 'RUNNING: OPTIMIZING_FOR_HARDWARE', 'RUNNING: WAITING_FOR_QPU', 'RUNNING: EXECUTING_QPU', 'RUNNING: POST_PROCESSING']
해를 그래프에 매핑하기
반환된 값을 변수 인덱스 순서대로 모으고, interpret()로 원래 문제의 변수에 다시 매핑합니다. 선택된 노드는 값이 1인 변수이며, is_feasible()은 원래 문제의 간선 제약 조건에 대해 할당을 확인합니다.
x_qubo = [result["solution"][f"x_{i}"] for i in range(qubo.get_num_vars())]
x = converter.interpret(x_qubo)
selected_nodes = [node for node, value in enumerate(x) if value > 0.5]

print(f"Selected nodes: {len(selected_nodes)}")
print(f"Satisfies every edge constraint: {mis.is_feasible(x)}")
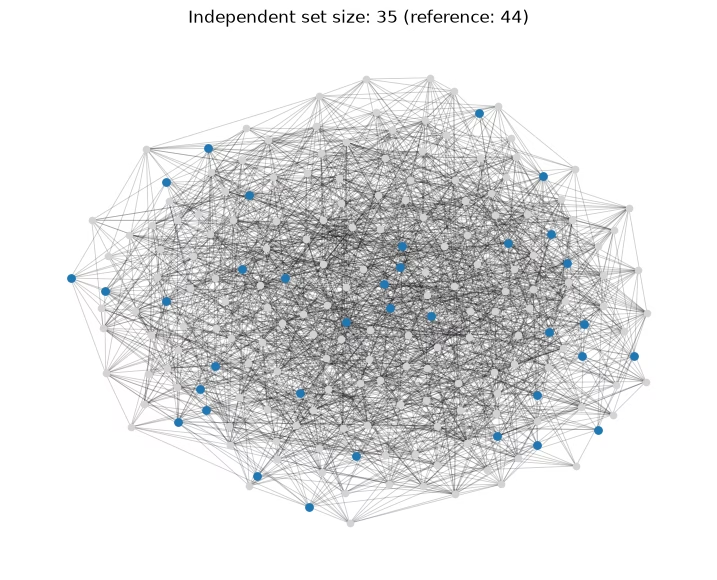
Selected nodes: 35
Satisfies every edge constraint: True
후처리 이전의 해와 비교하기
postprocessing_level이 1이므로 solver_info에는 고전 국소 탐색 이전의 반올림된 할당도 solution_before_postprocessing에 기록됩니다. 이는 solution과 같은 키를 사용합니다.
QUBO에서 평가하여 개선 과정이 결과를 얼마나 향상시켰는지 확인합니다. 두 값 모두 제출된 최소화 QUBO의 목적 함수 값이므로 값이 낮을수록 좋습니다. 국소 탐색이 실행되지 않으면, 예를 들어 presolve가 모든 변수를 고정하면 이 필드는 생략됩니다.
before = solver_info.get("solution_before_postprocessing")
if before is None:
    print("The classical local search did not run for this problem.")
else:
    x_before = [before[f"x_{i}"] for i in range(qubo.get_num_vars())]
    changed = sum(
        before[key] != value for key, value in result["solution"].items()
    )
    print(
        f"Objective before local search: {qubo.objective.evaluate(x_before)}"
    )
    print(f"Objective after local search: {result['objective_value']}")
    print(f"Variables changed by local search: {changed}")
Objective before local search: -12.0
Objective after local search: -35.0
Variables changed by local search: 19
독립성 제약 조건 검증하기
QUBO는 인접성을 명시적인 제약 조건이 아니라 페널티 항으로 표현하므로, 휴리스틱 결과가 인접한 노드를 선택할 수도 있습니다. 반환된 노드를 그래프와 직접 대조해 확인하세요. 다음 섹션의 비교와 시각화를 위해, 반환된 집합을 복사하고 감지된 각 충돌에서 한쪽 끝점을 탐욕적으로 제거합니다.
returned_set = set(selected_nodes)
conflicts = [
    (u, v) for u, v in G.edges if u in returned_set and v in returned_set
]
print(f"Conflicting edges in the returned set: {len(conflicts)}")

independent_set = returned_set.copy()
for u, v in conflicts:
    if u in independent_set and v in independent_set:
        # Drop the endpoint that has more selected neighbors.
        drop = max(
            (u, v),
            key=lambda node: sum(nb in independent_set for nb in G[node]),
        )
        independent_set.remove(drop)

assert all(
    not (u in independent_set and v in independent_set) for u, v in G.edges
)
print(f"Independent set size after repair: {len(independent_set)}")
Conflicting edges in the returned set: 0
Independent set size after repair: 35
참조 해와 비교하기
1단계에서 QOBLIB 참조 해의 목적 함수 값을 다운로드했습니다. QOBLIB 참조 해는 최적해이거나 알려진 최선의 해일 수 있으므로, 항상 검증된 최적해라고 가정하지 말고 참조 목적 함수 값과 비교하세요.
이 최대화 문제에서 비율이 1.0이면 수정된 결과가 참조 목적 함수 값과 일치한다는 뜻입니다.
ratio_to_reference = len(independent_set) / reference_objective

print(f"Reference objective: {reference_objective:g}")
print(f"Ratio to reference: {ratio_to_reference:.3f}")
Reference objective: 44
Ratio to reference: 0.795
결과 시각화하기
수정된 독립 집합을 강조 표시하여 그래프를 다시 그립니다. 강조 표시된 어떤 두 노드도 간선을 공유하지 않습니다.
fig, ax = plt.subplots(figsize=(9, 7))
nx.draw_networkx_edges(G, layout, ax=ax, alpha=0.2, width=0.6)
nx.draw_networkx_nodes(
    G,
    layout,
    nodelist=[v for v in G if v not in independent_set],
    node_size=node_size,
    node_color="lightgray",
    ax=ax,
)
nx.draw_networkx_nodes(
    G,
    layout,
    nodelist=sorted(independent_set),
    node_size=node_size * 1.4,
    node_color="tab:blue",
    ax=ax,
)
ax.set_title(
    f"Independent set size: {len(independent_set)} "
    f"(reference: {reference_objective:g})"
)
ax.set_axis_off()
plt.show()
리소스 사용량 읽기
결과 메타데이터는 RUNNING: EXECUTING_QPU 이외의 단계에 대해, 값이 있는 경우 CPU_TIME을 보고합니다. RUNNING: EXECUTING_QPU 단계는 모든 Quantum Compute 작업의 최종 사용량을 확인할 수 있는 경우, Quantum Compute가 반환하는 QPU 사용량인 QPU_TIME을 보고할 수 있습니다.
usage = result["metadata"]["resource_usage"]

for phase, metrics in usage.items():
    line = f"{phase:36s}"
    if "CPU_TIME" in metrics:
        line += f" CPU {metrics['CPU_TIME']:8.1f} s"
    if "QPU_TIME" in metrics:
        line += f" QPU {metrics['QPU_TIME']:8.1f} s"
    print(line)
RUNNING: MAPPING                     CPU     11.8 s
RUNNING: OPTIMIZING_FOR_HARDWARE     CPU     15.4 s
RUNNING: WAITING_FOR_QPU             CPU     16.5 s
RUNNING: EXECUTING_QPU               QPU      3.0 s
RUNNING: POST_PROCESSING             CPU     55.8 s
결론
이 튜토리얼에서는 QOBLIB에서 MIS 인스턴스를 다운로드하고, qiskit-addon-opt-mapper로 QUBO로 정식화하고, SQOA Solver에 연결하고, 워크로드를 구성하여 제출하고, 반환된 할당을 그래프로 되돌려 매핑하고, 선택된 노드를 원래 그래프와 대조해 확인했습니다.
또한 결과를 QOBLIB 참조 해와 비교하고, 고전 후처리의 기여도를 살펴보았으며, 각 실행 단계의 리소스 사용량을 확인했습니다.
SQOA Solver는 presolve, QRAC 기반 인코딩을 사용한 QRAO, 샘플링 회로 구성, 하드웨어 인식 트랜스파일, 샘플 기반 대각화, 반올림, 고전 개선을 결합합니다. 이 워크플로는 변수당 큐비트 하나를 쓰는 인코딩보다 더 많은 이진 변수를 매핑할 수 있습니다. presolve와 인코딩으로 인한 감소량은 문제 구조에 따라 달라지며, 해의 품질은 얻은 샘플에 따라 달라집니다.
shots와 postprocessing_level 설정은 제출 워크플로를 바꾸지 않고 각각 양자 샘플링 예산과 고전 개선을 제어합니다.
부록: 문제를 OMMX 인스턴스로 제출하기
SQOA Solver는 OMMX SDK의 ommx.v1.Instance도 받습니다. OMMX Quantum Benchmarks 패키지는 QOBLIB 문제를 참조 해와 함께 OMMX 인스턴스로 배포하므로, 직접 정식화하지 않고도 같은 QUBO를 불러올 수 있습니다.
OMMX 입력을 사용하면 objective_value는 인스턴스의 의미에 따라 평가되며, 결과에는 정규 ommx.v1.Solution도 포함됩니다. OMMX SDK도 함께 설치되는 패키지를 설치합니다.
# %pip install ommx-quantum-benchmarks
같은 인스턴스의 binary_unconstrained 모델을 불러옵니다. 데이터셋 로더가 진행 메시지를 출력하므로, 출력을 간결하게 유지하기 위해 코드에서 이를 캡처합니다.
%%capture
from ommx_quantum_benchmarks.qoblib import IndependentSet

ommx_instance, _ = IndependentSet()("binary_unconstrained", INSTANCE_NAME)
SQOA Solver는 OMMX 인스턴스를 표준 패딩 Base64 문자열로 받고 정규 해를 같은 형식으로 반환합니다. 이 변환을 위해 두 개의 헬퍼 함수를 정의합니다.
-
to_problem_payload()는ommx.v1.Instance를problem으로 전달할 문자열로 직렬화합니다. -
to_ommx_solution()은 결과에서 정규ommx.v1.Solution을 디코딩합니다.
import base64

from ommx.v1 import Instance, Solution

def to_problem_payload(instance: Instance) -> str:
    """Serialize an OMMX instance into the `problem` string for SQOA Solver."""
    return base64.b64encode(instance.to_bytes()).decode()

def to_ommx_solution(result: dict) -> Solution:
    """Decode the canonical OMMX solution from a SQOA Solver result."""
    payload = result["metadata"]["solver_info"]["ommx_solution"]
    return Solution.from_bytes(base64.b64decode(payload, validate=True))
problem만 바꾸고 이전과 같은 입력으로 인스턴스를 제출합니다. 그런 다음 정규 해를 디코딩하고 변수 이름으로 선택된 노드를 읽습니다.
ommx_job = solver.run(
    **{**sqoa_input, "problem": to_problem_payload(ommx_instance)}
)
ommx_result = ommx_job.result()

ommx_solution = to_ommx_solution(ommx_result)
x_values = ommx_solution.extract_decision_variables("x")
ommx_nodes = sorted(
    node for (node,), value in x_values.items() if value > 0.5
)

print(f"Objective value: {ommx_result['objective_value']}")
print(f"Selected nodes: {len(ommx_nodes)}")
Objective value: 35.0
Selected nodes: 35
다음 단계
- 이 워크플로를 자신의 QUBO 문제에 적용해 보세요. SQOA Solver 가이드에 나온 대로
OptimizationProblem을 구성합니다. 변환 및 제출 단계는 그대로이지만, 검증은 문제의 구조에 맞게 조정하세요. - 부록에 나온 대로 문제를 OMMX 인스턴스로 제출해 보세요. 허용되는 문제 형식과 반환되는 필드는 API 레퍼런스를 참조하세요.
- QOBLIB 저장소 또는 OMMX Quantum Benchmarks를 통해 다른 독립 집합 인스턴스를 살펴보세요.
- qiskit-addon-opt-mapper 또는 JijModeling으로 모델링하는 방법과 OMMX로 문제를 교환하는 방법을 더 알아보세요.
참고 문헌
[1] Koch, T., Bernal Neira, D. E., Chen, Y., Cortiana, G., Egger, D. J., Heese, R., Hegade, N. N., Gomez Cadavid, A., Huang, R., Itoko, T., et al. (2026). Quantum optimization benchmarking library: The intractable decathlon. Nature Computational Science, 6, 653–671. DOI, arXiv:2504.03832
[2] Matsuyama, H., & Yamashiro, Y. (2025). Sampling-based quantum optimization algorithm with quantum relaxation. 2025 IEEE International Conference on Quantum Computing and Engineering (QCE), 1, 2323–2333. DOI, arXiv:2504.12629
[3] Fuller, B., Hadfield, C., Glick, J. R., Imamichi, T., Itoko, T., Thompson, R. J., Jiao, Y., Kagele, M. M., Blom-Schieber, A. W., Raymond, R., et al. (2024). Approximate solutions of combinatorial problems via quantum relaxations. IEEE Transactions on Quantum Engineering, 5, 1–15. DOI, arXiv:2111.03167
[4] Kanno, K., Kohda, M., Imai, R., Koh, S., Mitarai, K., Mizukami, W., & Nakagawa, Y. O. (2026). Quantum-selected configuration interaction: Classical diagonalization of Hamiltonians in subspaces selected by quantum computers. Physical Review Research, 8(2), 023268. DOI, arXiv:2302.11320
[5] Robledo-Moreno, J., Motta, M., Haas, H., Javadi-Abhari, A., Jurcevic, P., Kirby, W., et al. (2025). Chemistry beyond the scale of exact diagonalization on a quantum-centric supercomputer. Science Advances, 11(25), eadu9991. DOI, arXiv:2405.05068