실시간 벤치마킹으로 백엔드 속성 새로 고침
사용량 추정: ibm_kingston에서 3분 (참고: 이는 추정치일 뿐입니다. 실제 실행 시간은 다를 수 있습니다.)
학습 목표
-
QPU가 보고하는 속성이 디바이스의 현재 동작보다 뒤처질 수 있는 이유와, 직접 다시 측정할 가치가 있는 경우
-
다섯 가지 표준 특성화 실험(판독, 단일 큐비트 무작위화 벤치마킹, 레이어드 2큐비트 무작위화 벤치마킹, , ) 각각이 측정하는 항목
-
단일 호출로 또는 단계별로 전체 특성화 스위트를 실행하고, 새로 고쳐진 속성을 가진 백엔드 객체를 얻는 방법
-
측정된 속성을 보고된 속성과 비교하는 방법과, 일부 차이가 디바이스 드리프트가 아니라 측정 방법론을 반영하는 이유
사전 준비 사항
-
Qiskit 패턴 워크플로
-
Qiskit Runtime 실행 모드, 특히 batch mode
-
백엔드 속성 및 캘리브레이션 데이터와 같은 QPU 정보를 탐색하는 방법
배경
모든 IBM Quantum® QPU는 각 큐비트가 현재 얼마나 잘 작동하고 있는지를 설명하는 일련의 속성을 보고합니다: 이완 시간(), 결맞음 시간(), 판독 오류, 그리고 1큐비트 및 2큐비트 게이트 오류. 이 수치는 실제로 중요합니다. 트랜스파일러는 이를 사용하여 회로가 실행되어야 할 물리 큐비트를 결정하고, 오류 완화 기법은 이에 의존하며, 여러분은 이를 사용하여 디바이스가 실험에 충분히 잘 작동하는지 판단할 수 있습니다.
보고된 속성은 일반적으로 하루에 한 번 정도 실행되는 캘리브레이션 절차에서 나옵니다. 그러나 초전도 큐비트는 더 짧은 시간 척도에서 드리프트할 수 있으며, 일시적인 결함(이른바 2준위 시스템)이 캘리브레이션 시점에 훌륭해 보였던 큐비트를 일시적으로 저하시킬 수 있습니다. 게다가 작업은 실제로 실행되기 훨씬 이전에 트랜스파일되는 경우가 많아, 보고된 속성에 기반한 결정이 오래된 정보에 의존할 수 있습니다. 큐비트 선택을 위한 실시간 벤치마킹 튜토리얼은 이러한 속성이 하루하루 얼마나 변동할 수 있는지 보여주고, 개별 Qiskit Experiments로부터 완전한 특성화 워크플로를 직접 구축합니다.
이 튜토리얼은 실험 구성, 작업 제출, 곡선 피팅을 몇 번의 호출로 패키지화한 Qiskit Device Benchmarking의 BackendCharacterization 유틸리티를 사용하여 해당 워크플로의 간소화된 버전을 보여줍니다. 약 70초의 QPU 시간을 소비하고, 속성이 바로 지금 디바이스를 반영하는 백엔드 객체를 얻어, 보고된 값과 비교하거나 다운스트림 도구에 전달할 준비가 됩니다.
특성화 실험
이 스위트는 각각 표준 실험을 사용하여 다섯 가지 속성을 측정합니다:
-
판독 오류 (
readout): 각 큐비트는 또는 로 준비된 후 즉시 측정됩니다. 잘못된 상태를 판독할 확률이 상태 준비 및 측정(SPAM) 오류를 제공합니다. -
1큐비트 게이트 오류 (
rb_1q): 무작위화 벤치마킹(RB)은 이상적으로 항등원으로 합성되는 무작위 단일 큐비트 클리퍼드 게이트의 시퀀스를 실행합니다. 시퀀스 길이에 따라 생존 확률이 감쇠하는 방식은 SPAM 오류와 무관하게 게이트당 평균 오류를 제공합니다. -
2큐비트 게이트 오류 (
rb_2q): 레이어 충실도 실험에서와 같이, 동시에 실행되는 겹치지 않는 2큐비트 게이트의 전체 레이어에 동일한 RB 개념을 적용합니다. 많은 게이트가 동시에 실행되기 때문에, 결과 오류율은 크로스토크 효과를 포함하며 깊은 회로가 실제로 경험하는 것에 더 가깝습니다. -
(
t1): 각 큐비트는 여기된 후 증가하는 지연 시간을 두고 측정됩니다. 여기 상태 집단의 감쇠가 이완 시간을 제공합니다. -
(
t2): Hahn 에코 실험은 각 큐비트를 중첩 상태로 만들고, 지연 시간의 중간에 에코 펄스를 적용하며, 위상 결맞음이 얼마나 빨리 손실되는지 측정합니다. 기본값은 단일 에코이며, 다중 에코(CPMG 방식) 변형은 이 튜토리얼 마지막 부분에서 다룹니다.
새로 고침이 하는 일과 하지 않는 일
이 워크플로를 사용할 때 다음 세 가지를 염두에 두세요:
-
새로 고쳐진 속성은 여러분에게 반환된 백엔드 객체 안에만 존재합니다. 디바이스 자체나 IBM Quantum이 다른 사용자에게 보고하는 캘리브레이션 데이터에는 아무것도 변경되지 않습니다.
-
측정된 값은 특정 방법론으로 촬영된 스냅샷입니다. 특히 레이어드 2큐비트 오류와 병렬 단일 에코 값을 포함한 일부 값은 보고된 캘리브레이션 데이터와 다른 방식으로 측정되므로, 관찰되는 차이의 일부는 드리프트가 아니라 방법론적인 것입니다. 이 튜토리얼은 이런 경우가 발생하는 지점을 짚어줍니다.
-
특성화 자체에는 QPU 시간이 소요됩니다(Heron r2 프로세서에서 전체 스위트는 약 70초), 이는 최신 정보를 얻기 위한 대가입니다.
이 워크플로는 Qiskit 패턴의 네 단계를 따릅니다:
-
1단계: 고전적 입력을 양자 문제로 매핑합니다. 디바이스와 측정할 속성 세트를 선택합니다.
-
2단계: 양자 하드웨어 실행을 위해 문제를 최적화합니다. 이 유틸리티는 디바이스의 네이티브 게이트로 직접 실험 회로를 구축하고 칩 전체에 병렬화합니다.
-
3단계: Qiskit 기본 요소를 사용하여 실행합니다. 실험은 배치 내부에서 Sampler 작업으로 실행됩니다.
-
4단계: 원하는 고전 형식으로 결과를 후처리하고 반환합니다. 측정 데이터를 큐비트별 오류 맵에 피팅하고, 백엔드를 새로 고치고, 측정된 속성을 보고된 속성과 비교합니다.
요구 사항
이 튜토리얼을 시작하기 전에 다음이 설치되어 있는지 확인하세요:
-
시각화 지원이 포함된 Qiskit SDK v2.0 이상
-
Qiskit Runtime v0.40 이상 (
pip install qiskit-ibm-runtime) -
Qiskit Experiments도 함께 설치하는 Qiskit Device Benchmarking (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
설정
필요한 라이브러리를 가져옵니다.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
특성화 스위트는 여러 실험을 구성하고, 여러 작업을 제출하며, 결과를 피팅하는데, 이는 전체적으로 몇 분 정도 걸릴 수 있습니다. INFO 수준 로깅을 활성화하여 각 단계가 진행됨에 따라 진행 상황을 출력하도록 합니다.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
소규모 시뮬레이터 예제
이 튜토리얼에는 시뮬레이터 예제가 포함되어 있지 않습니다. 이 워크플로는 특정 디바이스의 물리적 결함을 측정합니다: 큐비트가 얼마나 빨리 이완하고 위상이탈하는지, 그리고 게이트와 판독이 얼마나 자주 실패하는지 측정합니다. 이상적인 시뮬레이터는 이러한 결함이 전혀 없으므로 특성화할 것이 없습니다. 가짜 백엔드에 합성 노이즈 모델을 첨부할 수도 있지만, 그러면 실험은 여러분이 직접 입력한 수치만 복구하게 됩니다. 이러한 이유로, 우리는 Qiskit 패턴의 네 단계로 나누어 곧바로 하드웨어로 진행합니다.
대규모 하드웨어 예제
1단계: 고전적 입력을 양자 문제로 매핑
이 워크플로에서 "문제"는 디바이스 자체입니다: 고전적 입력은 여러분이 특성화하고자 하는 QPU와 측정할 속성 목록이며, 양자 실험은 이로부터 생성된 특성화 회로입니다.
먼저, 백엔드를 선택합니다. 이 튜토리얼은 156큐비트 Heron r2 프로세서인 ibm_kingston을 사용합니다; 접근 권한이 있는 다른 IBM Quantum 디바이스로 대체할 수 있습니다(또는 service.least_busy()로 하나를 선택할 수 있습니다).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
다음으로, 측정할 속성을 선택합니다. 다음 실험 중 임의의 부분 집합을 전달할 수 있습니다:
-
readout: SPAM(상태 준비 및 측정) 실험 -
rb_1q: 독립적인 단일 큐비트 무작위화 벤치마킹 -
rb_2q: 레이어 충실도 실험에서 나온 동시 2큐비트 무작위화 벤치마킹 -
t2: Hahn 에코 실험 (기본적으로 단일 에코) -
t1: 이완 실험
디바이스의 전체적인 그림을 얻으려면 전체 스위트를 실행하세요; 일부 속성에만 관심이 있고 QPU 시간을 절약하고 싶다면 목록에서 항목을 제외하세요.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
2단계: 양자 하드웨어 실행을 위해 문제 최적화
대부분의 튜토리얼에서는 이 지점에서 회로를 트랜스파일하게 됩니다. 여기서는 BackendCharacterization이 내부적으로 이를 처리합니다. 디바이스의 네이티브 게이트로 직접 실험 회로를 구축하고, 모든 큐비트에서 단일 큐비트 실험을 병렬로 실행하며, 결합 맵의 분리된 레이어에 걸쳐 2큐비트 벤치마킹을 예약하여 소수의 작업으로 전체 디바이스를 커버합니다. 이러한 병렬화 덕분에, 전체 스위트는 약 70초의 QPU 시간만 소비합니다.
워크플로를 관리하는 클래스를 초기화합니다:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
3단계: Qiskit 기본 요소를 사용하여 실행
run_experiments 메서드는 회로를 구축하고 Sampler 작업으로 제출합니다. 작업이 QPU에서 함께 예약되도록 Batch 컨텍스트 내에서 실행하면, 모든 작업이 제출된 후 메서드가 반환됩니다. (배치 외부에서 또는 Session 내부에서도 실행할 수 있습니다.)
세션 컨텍스트 관리자가 열려 있는 동안 Backend가 전달되었다는 경고가 표시될 수 있습니다. 이는 예상된 동작이며 안전하게 무시할 수 있습니다.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
이 메서드는 제출된 작업을 실험별로 키가 지정된 딕셔너리로 반환하며, 이는 IBM Quantum Platform 대시보드에서 추적하거나 디버깅하는 데 유용합니다.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
4단계: 원하는 고전 형식으로 결과를 후처리하고 반환
결과 분석
analyze_results 메서드는 작업이 완료될 때까지 기다린 다음 측정 데이터를 피팅합니다: 과 에 대한 지수 감쇠, RB 실험에 대한 생존 확률 감쇠, 판독에 대한 할당 행렬. 이 메서드는 측정된 속성당 하나씩, 각각 큐비트(또는 큐비트 쌍)를 측정값에 매핑하는 오류 맵의 딕셔너리를 반환합니다.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
이 맵은 판독 오류, 단일 큐비트 x 및 sx 게이트 오류, 레이어드 2큐비트 오류(레이어 충실도 실험에서 나온 lf_error_map), 그리고 초 단위의 및 시간을 다룹니다.
백엔드 속성 업데이트
update_backend 메서드는 측정된 값을 백엔드 복사본의 속성에 기록하고 이를 반환합니다. 원래의 backend 객체는 보고된 캘리브레이션 데이터를 유지하므로, 아래에서 보여주는 것처럼 두 가지를 비교할 수 있습니다. 이 업데이트는 여러분의 Python 세션에만 완전히 국한된다는 점을 기억하세요; 디바이스나 다른 사용자에게 아무것도 변경하지 않습니다.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
측정된 속성과 보고된 속성 비교
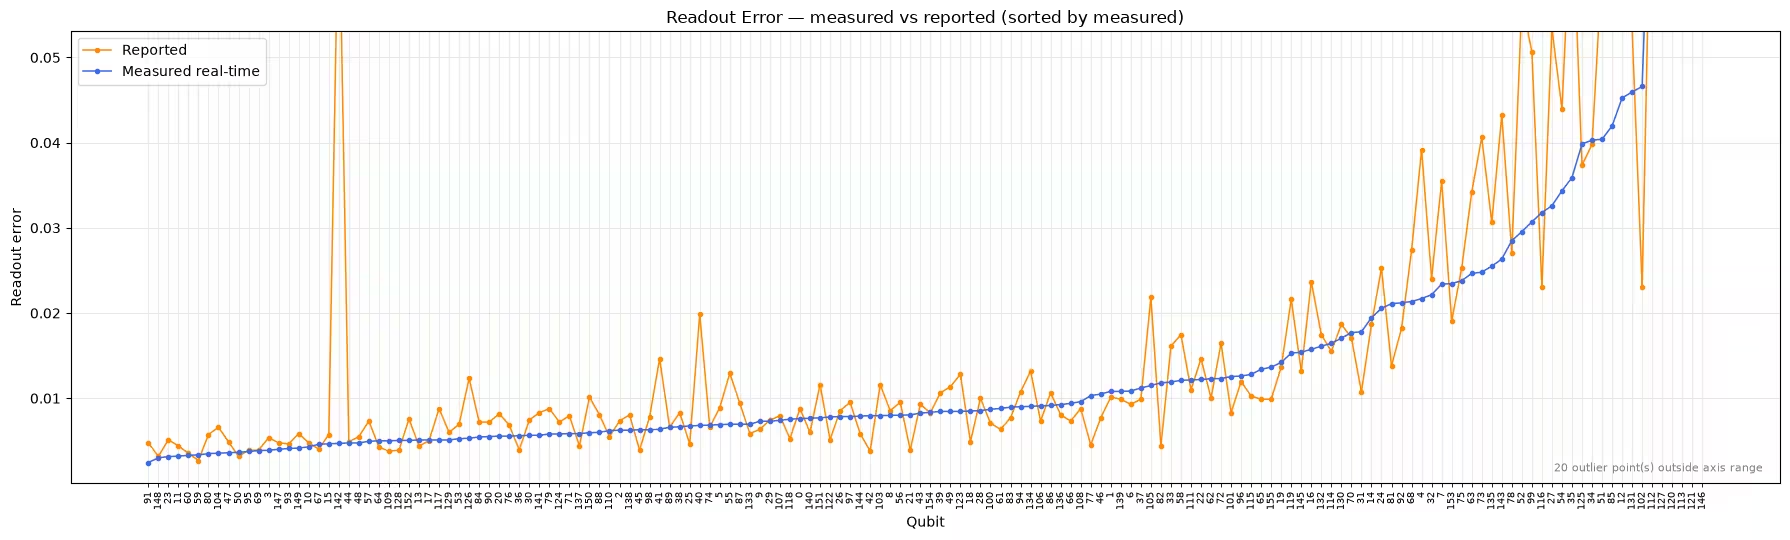
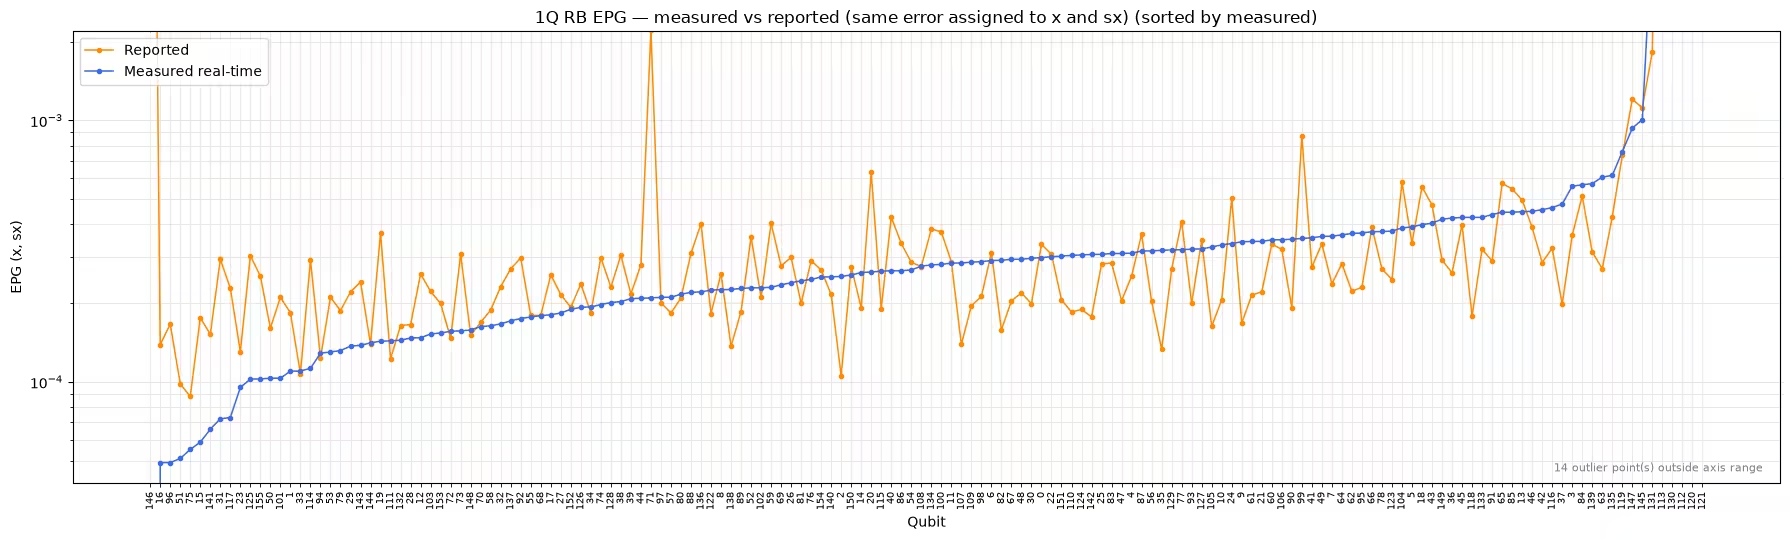
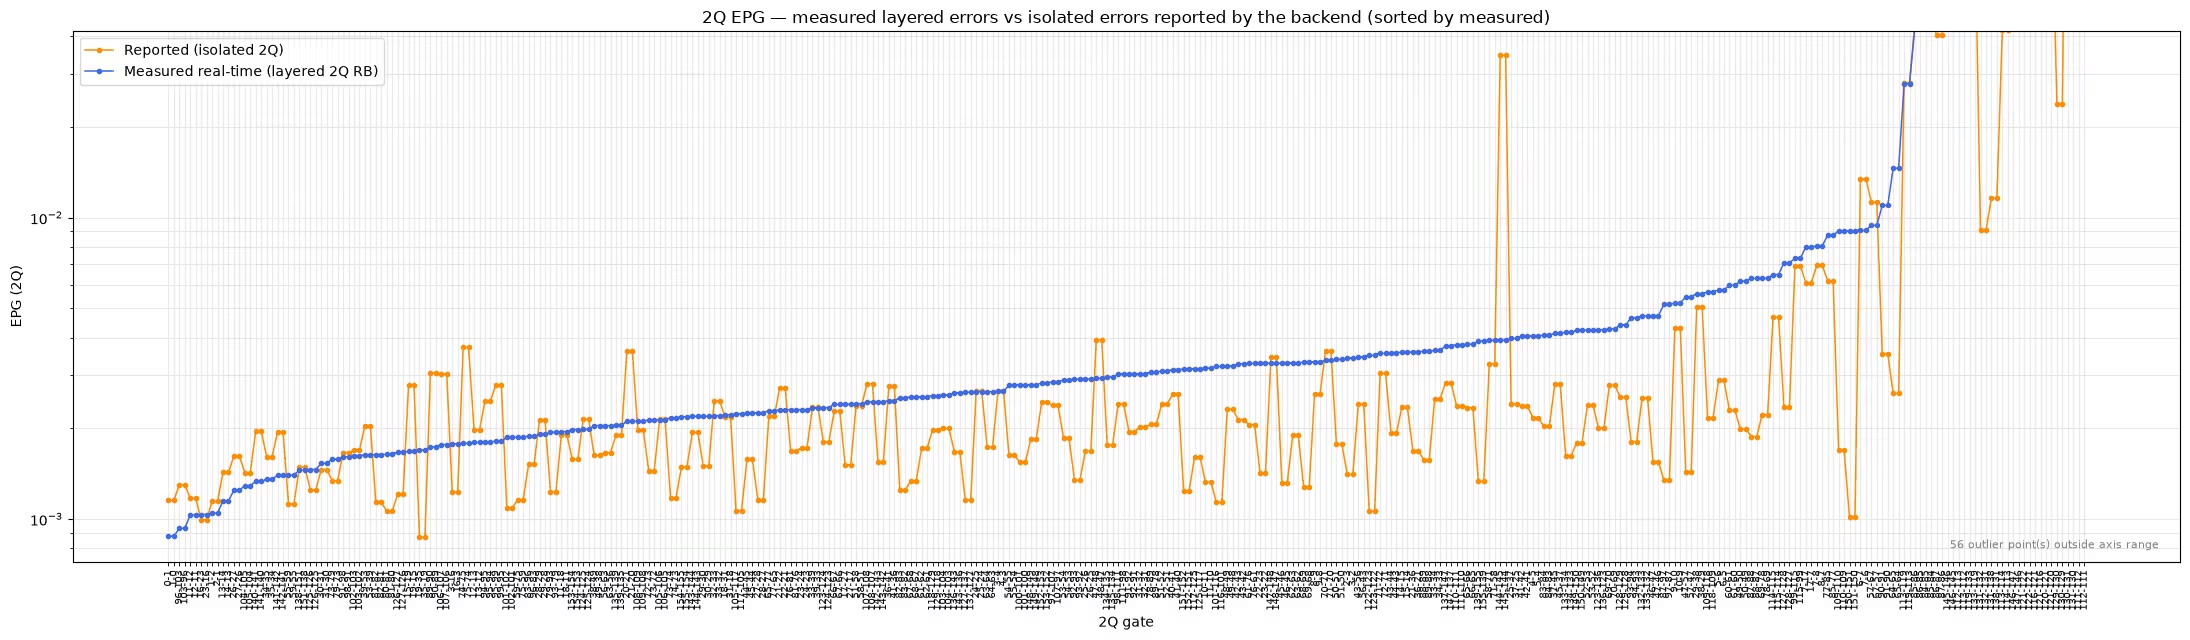
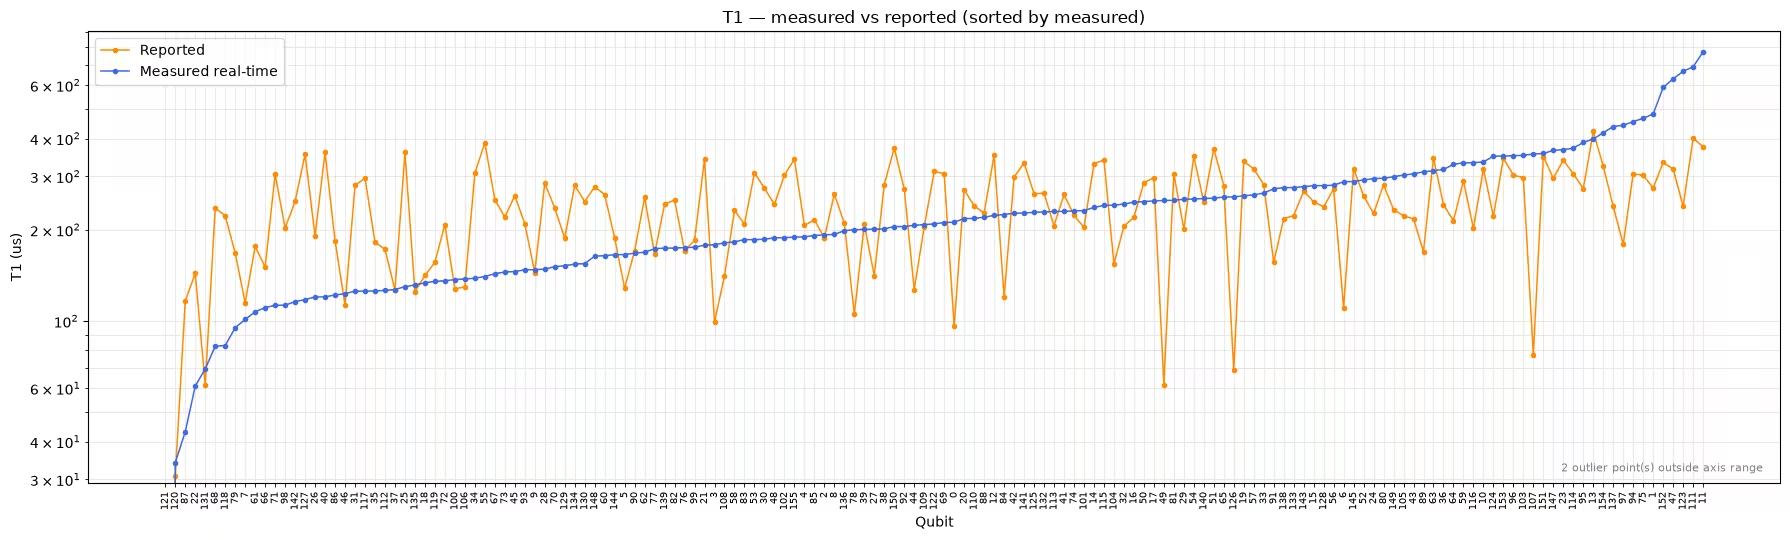
마지막으로, 측정된 실시간 속성을 백엔드가 보고하는 값과 대비하여 플롯합니다. 각 패널에서 큐비트(또는 큐비트 쌍)는 측정값을 기준으로 정렬되어 있어, 측정 곡선은 구조상 매끄럽고 그 주변에 흩어진 보고된 값의 산포도가 두 값이 일치하지 않는 지점을 보여줍니다. 동일한 측정 게이트당 오류가 x와 sx 게이트 모두에 할당되므로 단일 큐비트 RB에 대해서는 단일 플롯이 표시됩니다. 축 한계는 소수의 극단적인 이상치가 플롯을 압축하지 않도록 데이터의 대부분에서 선택됩니다; 범위를 벗어나는 점은 플롯에 주석으로 표시됩니다(또는 한계를 재정의하려면 ylim을 전달하세요).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
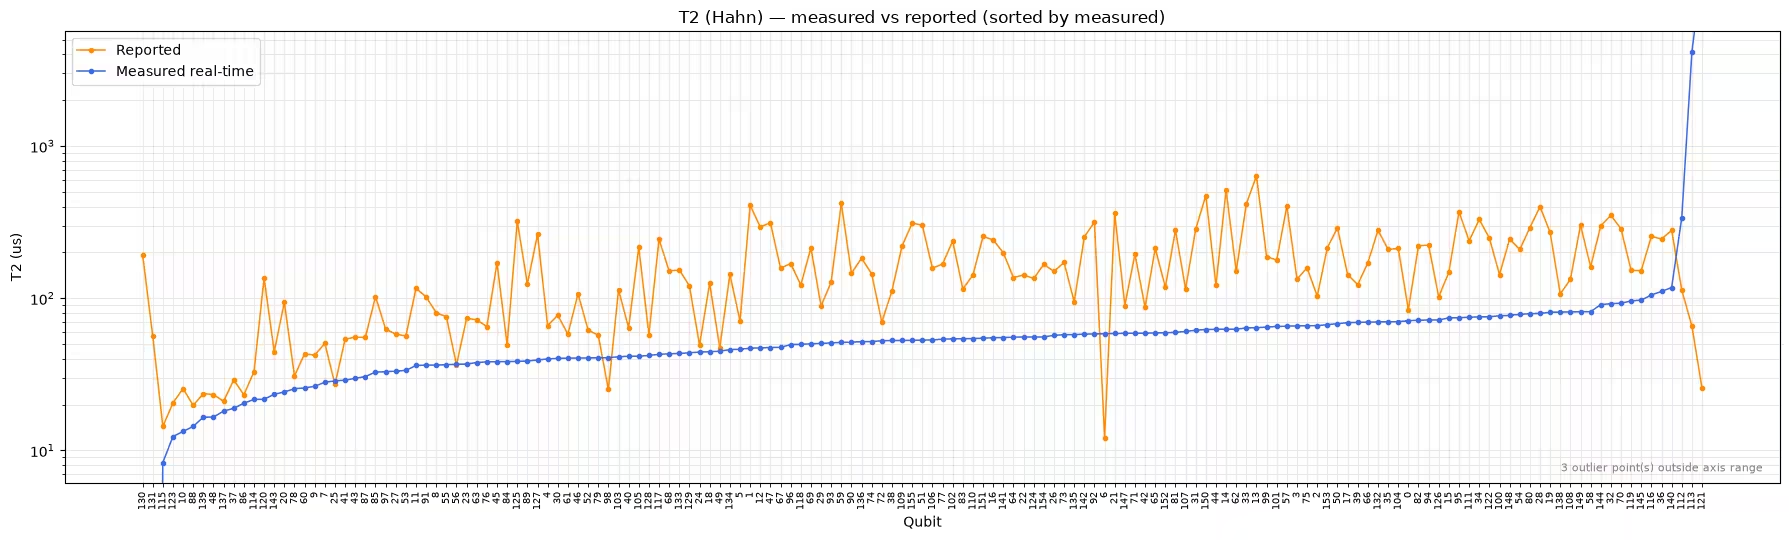
이러한 플롯은 신중하게 읽어야 합니다. 두 곡선 사이의 모든 차이가 디바이스가 드리프트했다는 것을 의미하지는 않기 때문입니다:
-
판독 및 단일 큐비트 오류: 대부분의 큐비트에서 측정값이 보고된 값을 따라가지만, 소수의 큐비트에 대한 보고된 값은 측정 곡선에서 크게 벗어나 있습니다. 이러한 국소적 불일치가 바로 이 워크플로가 포착하도록 설계된 드리프트입니다.
-
: 두 데이터 세트는 체계적인 오프셋 없이 서로 주위에 흩어져 있으며, 이는 이 시간이 지남에 따라 자연스럽게 변동한다는 것과 일치합니다.
-
2큐비트 오류: 측정값은 보고된 값보다 체계적으로 높게 위치합니다. 이는 예상된 결과입니다. 보고된 값은 고립된 게이트에서 측정되는 반면, 레이어 충실도 실험은 많은 게이트를 동시에 실행하므로 크로스토크를 포함하기 때문입니다. 레이어드 수치는 깊은 회로에 더 관련이 있지만, 보고된 캘리브레이션 데이터와 직접 비교할 수는 없습니다.
-
: 측정값은 대부분의 큐비트에 대해 보고된 값보다 훨씬 낮게 위치합니다. 다시 말하지만, 방법론이 큰 역할을 하며, 이는 다음 섹션에서 살펴봅니다.
개별 실험 결과 검사
기본 Qiskit Experiments ExperimentData 객체를 반환하는 experiment_data 속성을 통해 개별 특성화 실험의 원시 결과를 검사할 수도 있습니다. 예를 들어, 다음은 단일 큐비트의 측정된 감쇠 곡선을 표시하며, 이는 산출된 수치를 신뢰하기 전에 피팅의 품질을 확인하는 데 유용합니다.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

동적 디커플링 트레인으로 T2 측정
기본적으로 실험은 Hahn 에코를 한 번만 적용하고 모든 큐비트를 병렬로 측정하는데, 앞의 비교 플롯에서 본 것처럼 백엔드가 보고하는 것보다 눈에 띄게 낮은 값을 낼 수 있습니다. 한 가지 가설은 에코 수입니다: 보고된 값은 저주파 노이즈를 억제하는 동적 디커플링으로 캘리브레이션되었을 수 있습니다. 이를 테스트하려면, t2_num_echoes를 더 큰 값으로 설정하여 CPMG 스타일의 에코 펄스 트레인을 적용하는 전용 특성화를 실행합니다. 지연 시간은 두 경우 모두 총 자유 진화 시간을 나타내므로, 피팅된 값은 단일 에코 결과와 직접 비교할 수 있습니다.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
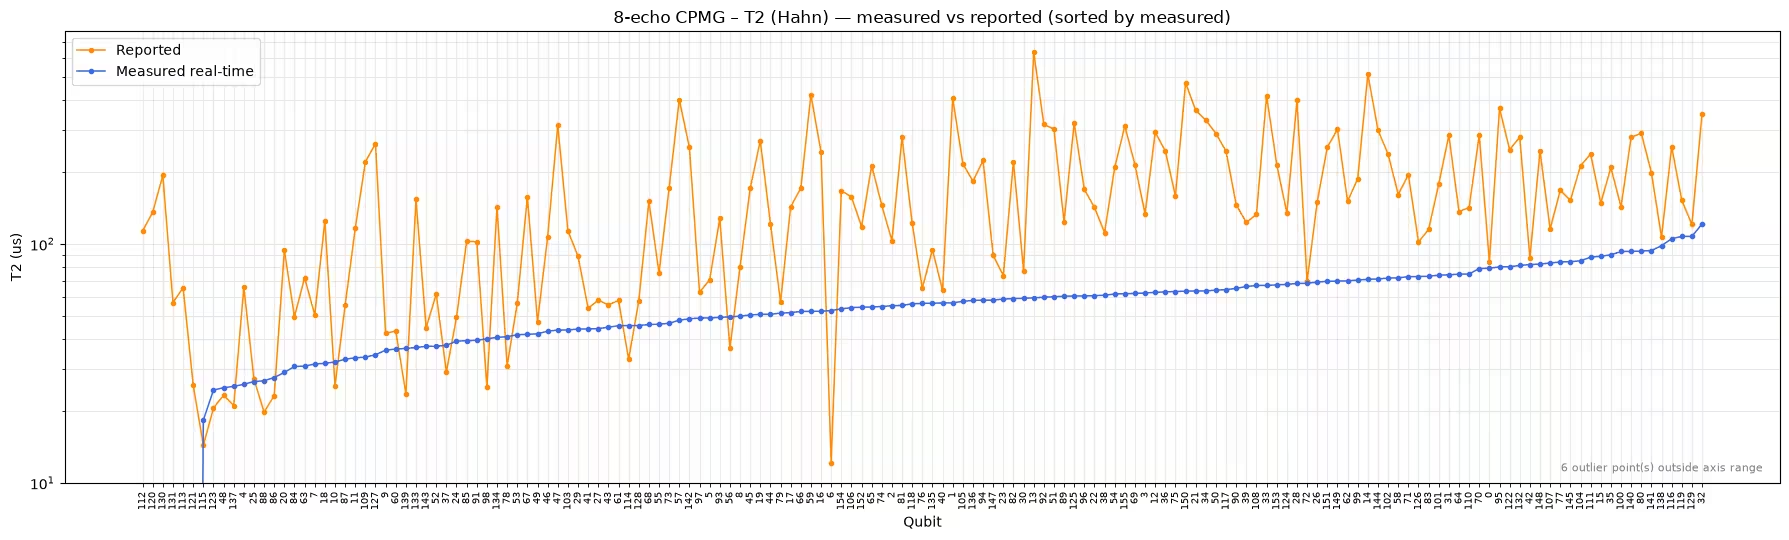
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
이 실행에서 추가 에코는 결과를 거의 변화시키지 않았습니다: 8-에코 중앙값(56 µs)은 단일 에코 값(53 µs)에 가까우며, 둘 다 보고된 중앙값(142 µs)보다 훨씬 낮습니다. 에코 수만으로는 이 차이를 설명할 수 없습니다; 캘리브레이션 절차의 세부 사항, 큐비트를 고립된 상태가 아니라 병렬로 측정하는 것 등 다른 방법론적 차이가 관련되어 있습니다.
실용적인 교훈은 방법론이 다른 (및 레이어드 2큐비트 오류) 비교를 신중하게 다뤄야 한다는 것입니다. 새로 고쳐진 값은 실제 워크로드에 가까운 조건에서 촬영된 자기 일관적인 스냅샷으로, 큐비트를 서로 비교하거나 시간이 지남에 따라 디바이스를 추적하는 데 적합합니다. 그러나 보고된 캘리브레이션 데이터와의 차이가 자동으로 드리프트의 증거가 되는 것은 아닙니다.
1~4단계를 단일 호출로 압축
일상적인 사용에서는 중간 결과가 거의 필요하지 않습니다. run_and_update 메서드는 위에서 수행한 모든 작업(구축, 제출, 피팅, 업데이트)을 새로 고쳐진 백엔드를 반환하는 단일 호출로 연결합니다. 이는 동일한 experiments 목록을 받아들이며(그리고 t2_num_echoes와 같은 옵션을 전달합니다), 마찬가지로 Batch 또는 Session 컨텍스트로 감쌀 수 있습니다.
다음 셀은 모든 작업과 후처리가 완료될 때까지 반환되지 않습니다.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
새로 고쳐진 backend_updated 객체는 이제 백엔드 속성이 워크플로에 반영되는 모든 곳에서 사용할 준비가 되었습니다. 회로를 트랜스파일할 때 가장 성능이 좋은 큐비트를 선택하기 위해 큐비트 선택을 위한 실시간 벤치마킹 튜토리얼과 함께 이 프로세스를 시도해 보세요. 디바이스는 계속해서 드리프트하므로, 실제로 워크로드를 실행하는 시점에 가깝게 속성을 새로 고치세요.
다음 단계
이 작업이 흥미로웠다면, 다음 자료에 관심이 있을 수 있습니다:
- 새로 고쳐진 속성을 사용하여 큐비트 선택을 위한 실시간 벤치마킹 튜토리얼에서 더 나은 큐비트를 선택하세요
- 보고된 캘리브레이션 데이터가 QPU 정보 가이드에서 어떻게 노출되는지 알아보세요
- Qiskit Experiments 문서에서 개별 특성화 실험을 살펴보세요
- Qiskit Device Benchmarking 저장소에서 더 많은 디바이스 수준 벤치마크를 둘러보세요