Greenberger-Horne-Zeilinger 상태의 섀도 토모그래피
사용량 추정: Heron r2 프로세서에서 10초 미만(참고: 추정치일 뿐이며 실제 실행 시간은 다를 수 있습니다.)
학습 목표
-
섀도 토모그래피가 양자 상태의 고전적 섀도를 구성하는 방법과, 전체 상태 토모그래피보다 지수적으로 적은 측정만 필요한 이유
-
Qiskit을 사용해 국소 파울리 섀도 토모그래피를 구현하여 단일 큐비트 자화, 2점 상관 함수, 2큐비트 축소 밀도 행렬을 추정하는 방법
-
대규모 하드웨어 실험에서 시공간 코드를 사용한 저오버헤드 오류 검출에 qiskit-paulice를 사용하는 방법
사전 지식
배경
큐비트 시스템의 전체 양자 상태 토모그래피는 밀도 행렬의 독립적인 매개변수 개를 모두 추정하기 위해 지수적으로 많은 측정이 필요합니다. 예를 들어 50큐비트 시스템에서는 이 과정에 샷 정도가 필요한데, 이는 관측 가능한 우주의 별 개수의 10억 배가 넘습니다. 섀도 토모그래피 [1]는 양자 상태의 “고전적 섀도”를 구성하는 양자 정보 프로토콜로, 관측량 개수에 대해 로그적으로 증가하고 시스템 크기 과는 무관한 샷 수만으로 목표 관측량을 추정할 수 있어, 에너지 추정, 얽힘 엔트로피와 상관 함수 계산, 양자 머신러닝의 커널 추정 등 양자 컴퓨팅의 여러 분야에서 유용합니다.
이 튜토리얼은 섀도 토모그래피를 사용해 고도로 얽힌 Greenberger-Horne-Zeilinger(GHZ) 상태의 국소 관측량, 즉 큐비트 의 단일 큐비트 자화 , 2점 상관 함수 , 2큐비트 축소 밀도 행렬(2-RDM)을 추정하는 방법을 보여 줍니다. 튜토리얼은 먼저 상태 벡터 시뮬레이션을 사용해 10큐비트 GHZ 상태에 대한 소규모 섀도 토모그래피 워크플로를 설명합니다. 그런 다음 실제 양자 하드웨어에서의 100큐비트 시연을 보여 줍니다.
섀도 토모그래피 프로토콜
섀도 토모그래피 프로토콜은 다음 단계로 이루어집니다.
- 유니터리 앙상블에서 뽑은 무작위 유니터리 를 초기 양자 상태에 적용합니다.
- 계산 기저에서 결과를 측정하여 비트열 를 얻습니다.
- 고전적 스냅샷 를 저장합니다. 여기서 은 측정 채널 의 역입니다.
- 이 과정을 번 반복하며, 개의 스냅샷 모음 이 고전적 섀도 를 이룹니다.
- 연산자 의 관측량 를 로 추정합니다.
섀도 토모그래피 변형
프로토콜 1단계에서 유니터리 앙상블(즉, 기저)을 어떻게 선택하느냐에 따라 해당 섀도 토모그래피의 샘플 복잡도, 추정치의 분산, 정보 완전성이 달라집니다. 문헌에서는 많은 앙상블 군이 고려되었으며, 각각 복잡도와 관측량 추정 효율 사이에 트레이드오프가 있습니다. 가장 흔히 사용되는 변형의 특성을 다음 표에 요약했으며, 이 목록이 전부는 아닙니다.
| 변형 | 앙상블 | 샘플 복잡도 | 회로 깊이 | 적합한 관측량 |
|---|---|---|---|---|
| 국소 파울리 [1] | 단일 큐비트 파울리 | 1 | 국소/소수 몸체 | |
| 전역 클리포드 [1] | 큐비트 클리포드 | 낮은 랭크, 충실도 | ||
| 페르미온 가우시안 [2], [3] | 매치게이트 회로 | 페르미온 | ||
| 얕은 섀도 [4], [5] | 저깊이 회로 | 비국소(하드웨어 친화적) |
표에서 사용한 용어는 다음과 같이 정의됩니다.
-
"샘플 복잡도"는 해당 섀도 토모그래피 변형에 필요한 측정 횟수를 뜻합니다.
-
"회로 깊이"는 양자 하드웨어에서 측정을 구현하는 데 드는 비용을 나타냅니다.
-
은 큐비트 수입니다.
-
는 관측량의 국소성입니다(예: 는 , 는 ).
-
은 동시에 추정할 관측량의 개수입니다.
-
은 가법 오차 허용치입니다.
-
는 페르미온의 수입니다.
국소 파울리 앙상블은 하드웨어 친화성이 가장 높지만 의 샘플 복잡도 페널티를 치르므로 비국소 성질 추정에는 적합하지 않습니다. 더 일반적으로, 국소 섀도의 샘플 복잡도 한계는 로 증가하며, 텐서 곱 관측량이라는 특수한 경우에는 로 개선됩니다.
반대로 전역 클리포드 앙상블은 비국소 관측량을 추정하는 데 사용할 수 있지만 회로 깊이가 좋지 않습니다. 페르미온 가우시안 섀도는 다체 물리, 화학, 재료 시뮬레이션에 유용하지만 매치게이트 회로가 필요하며, 이는 범용 게이트 기반 장치에서 상당한 오버헤드를 수반할 수 있습니다.
얕은 섀도는 회로 깊이가 국소 파울리와 전역 클리포드의 중간이어서 실용적 구현에 매우 유망한 변형이지만, 주어진 관측량에 대한 최적의 회로 깊이에 관해서는 아직 몇 가지 미해결 문제가 남아 있습니다.
섀도 토모그래피 연구의 최전선이 계속 확장됨에 따라, 해결해야 할 가장 관련성 높은 문제로는 목표 관측량 집합에 대한 측정 앙상블의 최적 선택, 샘플 복잡도 한계의 개선, 시간 발전된 관측량으로의 프로토콜 확장 등이 있습니다. 그럼에도 섀도 토모그래피는 최소한의 측정 횟수로 양자 상태에서 최대한의 고전 정보를 추출하는 선도적인 워크플로 중 하나이며, 전체 토모그래피와 고전 시뮬레이션이 모두 불가능한 규모에서 양자 상태를 특성화하는 데 이상적입니다.
국소 파울리 앙상블
이 튜토리얼은 무작위 파울리 기저, 즉 단일 큐비트 클리포드 게이트를 사용해 섀도를 수집하고 GHZ 상태의 성질을 추정합니다. 파울리 측정은 국소 관측량(스핀 밀도, 국소 상관 함수, 위치 확률 밀도 등)을 추정하기에는 훌륭한 선택이지만, 전역 관측량(총 에너지, 운동량, 전하 등)에는 그렇지 않다는 점에 유의하세요.
여기서는 큐비트마다 무작위 파울리 기저 를 독립적으로 선택하고 해당하는 단일 큐비트 회전을 적용한 다음 측정합니다.
이 앙상블에서 측정 채널의 역은 다음과 같습니다.
계수 은 세 가지 파울리 기저에 대한 평균에서 나오며, 이는 매개변수 의 탈분극 채널을 만듭니다. 그러면 전체 추정량은 단일 큐비트 추정량의 곱으로 인수분해됩니다. 표에 나온 것처럼, 국소성이 각각 인 개의 관측량에 대해 모든 관측량을 높은 확률로 가법 오차 이내로 추정하는 데 필요한 파울리 섀도의 수는 입니다. 관측량이 국소적으로 유지되는 한 시스템 크기는 측정 비용에 영향을 주지 않으므로, 지수적으로 많은 관측량을 로그 수준의 비용만으로 동시에 추정할 수 있습니다.
평균의 중앙값
개 스냅샷에 대한 단순 평균은 관측량의 단일 샷 추정치의 분산을 로 줄이지만 이상치에 민감합니다. 이를 보완하기 위해 평균의 중앙값을 사용할 수 있습니다. 이 과정은 다음과 같습니다.
- 개의 스냅샷을 크기가 같은 개의 그룹으로 나눕니다
- 각 그룹 내의 평균을 계산합니다
- 그룹 평균들의 중앙값을 반환합니다
이 튜토리얼은 국소 파울리 섀도 토모그래피를 수행하여 GHZ 상태의 성질을 추정합니다. 먼저 10큐비트 시뮬레이션 예제를 사용하고, 이어서 100큐비트 하드웨어 실험을 시연합니다.
요구 사항
이 튜토리얼을 시작하기 전에 다음이 설치되어 있는지 확인하세요.
-
시각화 지원이 포함된 Qiskit SDK v2.0 이상
-
IBM Quantum Compute v0.28 이상 (
pip install qiskit-ibm-runtime) -
Qiskit Paulice (
pip install qiskit-paulice)
설정
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_paulice": "qiskit-paulice"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import numpy as np
import matplotlib.pyplot as plt
from collections import deque, defaultdict
from qiskit import QuantumCircuit, ClassicalRegister
from qiskit.quantum_info import (
    Statevector,
    partial_trace,
    Operator,
    Pauli,
    SparsePauliOp,
)
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit_paulice.layout import get_low_overhead_ancillas
seed = 42  # for reproducibility
rng = np.random.default_rng(seed)
다음 도우미 함수는 튜토리얼 후반부의 대규모 하드웨어 예제에서 사용됩니다.
-
bad_cz,bad_readout,bad_coherence— 백엔드 보정 데이터를 조회하여 오류 또는 일관성 임계값을 초과하는 게이트, 큐비트, 에지를 식별하며, 이를 회로 레이아웃에서 제외할 수 있게 합니다. -
parallel_ghz— 커플링 맵에 대한 너비 우선 탐색을 사용해 주어진 크기의 GHZ 회로를 만들고, CNOT 계층을 병렬로 배치하여 회로 깊이를 최소화합니다. -
weighted_coverage,active_wires,z_trace_backward— [6]의 역전파 기법을 사용해, 주어진 시공간 패리티 검사 집합이 GHZ 회로의 오류 표면 중 얼마나 많은 부분을 보호하는지 계산합니다. -
add_measurements— GHZ 큐비트 측정과 검사 큐비트 측정을 별도의 고전 레지스터에 추가하여 독립적으로 사후 선택할 수 있게 합니다. -
build_shadow_circuits— 측정 전에 적절한 단일 큐비트 회전을 추가하여 무작위 파울리 기저마다 회로를 하나씩 생성합니다. -
parse_hw_results_w_checks— Sampler 출력을 샷마다 하나씩(ghz_bits, check_bits, bases)3중항으로 풀어냅니다. -
adapt_to_flat_bits,estimate_zz_nn_hw— GHZ 레지스터 비트를 전체 장치 인덱스 공간으로 다시 매핑하고 평균의 중앙값 추정치를 계산합니다.
def bad_cz(target, threshold: float = 0.01) -> list:
    "Return edges whose CZ error exceeds threshold."
    edges = []
    for edge in backend.target.build_coupling_map().get_edges():
        if (edge[1], edge[0]) not in edges:
            edges.append(edge)
    cz_errors = {edge: target["cz"][edge].error for edge in edges}
    worst = sorted(cz_errors.items(), key=lambda x: x[1], reverse=True)
    return [list(edge) for edge, error in worst if error > threshold]

def bad_readout(target, threshold: float = 0.01) -> list:
    "Return nodes whose measurement error exceeds threshold."
    meas_errors = {
        node: target["measure"][(node,)].error
        for node in range(backend.num_qubits)
    }
    worst = sorted(meas_errors.items(), key=lambda x: x[1], reverse=True)
    return [node for node, error in worst if error > threshold]

def bad_coherence(target, threshold: float = 60) -> list:
    "Return nodes whose T2 value is below threshold."
    t2s = {
        node: (target.qubit_properties[node].t2 or 0) * 1e6
        for node in range(backend.num_qubits)
    }
    return [
        node
        for node, val in sorted(t2s.items(), key=lambda x: x[1])
        if val < threshold
    ]

def parallel_ghz(
    root: int, num_qubits: int, backend, bad_edges: list, skip: list
) -> tuple:
    "Build a GHZ circuit of size num_qubits using BFS from root, one neighbor per layer."
    edges = [
        e
        for e in [list(e) for e in backend.coupling_map.get_edges()]
        if e not in bad_edges
        and [e[1], e[0]] not in bad_edges
        and e[0] not in skip
        and e[1] not in skip
    ]
    adj = defaultdict(list)
    for u, v in edges:
        adj[u].append(v)
        adj[v].append(u)

    qc = QuantumCircuit(backend.num_qubits)
    visited = [root]
    queue = deque([root])
    explored = defaultdict(set)
    layers = []
    qc.h(root)

    while queue and len(visited) < num_qubits:
        layer = []
        for node in list(queue):
            queue.popleft()
            unvisited = [
                nb
                for nb in adj[node]
                if nb not in visited and nb not in explored[node]
            ]
            if unvisited:
                nb = unvisited[0]
                visited.append(nb)
                queue.append(node)
                queue.append(nb)
                explored[node].add(nb)
                layer.append((node, nb))
                if len(visited) == num_qubits:
                    break
        if layer:
            layers.append(layer)
        else:
            break

    for layer in layers:
        for q1, q2 in layer:
            qc.cx(q1, q2)
        qc.barrier()

    return qc, visited, layers

def weighted_coverage(
    layers: list, parities: list, w_idle: float = 0.2, w_gate: float = 0.8
) -> float:
    "Compute weighted fraction of wires covered by at least one parity check."
    wires = active_wires(layers)
    covered_by_any = {n_layer: set() for n_layer in range(len(layers))}
    for parity in parities:
        for n_layer, qs in z_trace_backward(layers, parity).items():
            covered_by_any[n_layer] |= qs
    covered_weight = total_weight = 0
    for n_layer in range(len(layers)):
        idle = wires[n_layer]["idle"]
        gate = wires[n_layer]["gate"]
        total_weight += w_idle * len(idle) + w_gate * len(gate)
        covered_weight += w_idle * len(
            covered_by_any[n_layer] & idle
        ) + w_gate * len(covered_by_any[n_layer] & gate)
    return covered_weight / total_weight if total_weight > 0 else 0

def active_wires(layers: list) -> dict:
    """
    Returns per-layer dict with two sets:
    - 'idle': activated wires that are idle in this layer
    - 'gate': activated wires that are control/target of a CNOT at this layer
    """
    first_activation = {}
    for n_layer, layer in enumerate(layers):
        for c, t in layer:
            first_activation.setdefault(c, n_layer)
            first_activation.setdefault(t, n_layer)
    result = {}
    for n_layer in range(len(layers)):
        active = {
            q
            for q, n_layer0 in first_activation.items()
            if n_layer >= n_layer0
        }
        gate = {q for c, t in layers[n_layer] for q in (c, t)}
        result[n_layer] = {"idle": active - gate, "gate": gate}
    return result

def z_trace_backward(layers: list, initial_Zs: list) -> dict:
    """
    Backward propagate Zs with parity cancellation.
    Returns {layer: set of qubits with odd parity Z at that layer}.
    """
    wires = active_wires(layers)
    support = set(initial_Zs)
    trace = {}
    for n_layer in range(len(layers) - 1, -1, -1):
        active = wires[n_layer]["idle"] | wires[n_layer]["gate"]
        trace[n_layer] = support & active
        new_support = set()
        for q in support:
            hit = False
            for c, t in layers[n_layer]:
                if q == t:
                    new_support ^= {t, c}
                    hit = True
                    break
                elif q == c:
                    new_support ^= {c}
                    hit = True
                    break
            if not hit:
                new_support ^= {q}
        support = new_support
    return trace

def add_measurements(
    qc: QuantumCircuit, ghz_qubits: list, checks: list
) -> QuantumCircuit:
    "Add GHZ and check qubit measurements into separate classical registers."
    c1 = ClassicalRegister(len(ghz_qubits), "c1")
    qc.add_register(c1)
    for q, c in zip(ghz_qubits, c1):
        qc.measure(q, c)
    c2 = ClassicalRegister(len(checks), "c2")
    qc.add_register(c2)
    for q, c in zip(checks, c2):
        qc.measure(q, c)
    return qc

def build_shadow_circuits(
    base_circuit: QuantumCircuit,
    n_measure: int,
    ghz_qubits: list,
    checks: list,
) -> tuple:
    "Build n_measure circuits by appending random Pauli basis rotations to each GHZ qubit."
    n = base_circuit.num_qubits
    all_bases = rng.integers(0, 3, size=(n_measure, n))
    circuits = []
    for m in range(n_measure):
        qc = base_circuit.copy()
        qc.barrier()
        for q in ghz_qubits:
            b = all_bases[m, q]
            if b == 1:
                qc.h(q)
            elif b == 2:
                qc.sdg(q)
                qc.h(q)
        add_measurements(qc, ghz_qubits, checks)
        circuits.append(qc)
    return circuits, all_bases

def parse_hw_results_w_checks(
    result, bases: np.ndarray, ghz_qubits: list, checks: list
) -> list:
    "Parse hardware bitstrings into (ghz_bits, check_bits, bases) triples."
    snapshots = []
    n_ghz = len(ghz_qubits)
    n_checks = len(checks)
    for t, pub_result in enumerate(result):
        ghz_strings = (
            pub_result.data.c1.get_bitstrings()
        )  # one entry per shot
        chk_strings = pub_result.data.c2.get_bitstrings()
        for ghz_bitstring, check_bitstring in zip(ghz_strings, chk_strings):
            ghz_bits = [
                int(ghz_bitstring[n_ghz - 1 - i]) for i in range(n_ghz)
            ]
            check_bits = [
                int(check_bitstring[n_checks - 1 - i])
                for i in range(n_checks)
            ]
            snapshots.append((ghz_bits, check_bits, bases[t]))
    return snapshots

def adapt_to_flat_bits(
    ghz_bits: list, ghz_qubits: list, n_total: int
) -> list:
    "Map GHZ-register bits back to a full n_total-length bit vector."
    bits = [0] * n_total
    for i, q in enumerate(ghz_qubits):
        bits[q] = ghz_bits[i]
    return bits

def estimate_zz_nn_hw(
    snapshots: list, ghz_qubits: list, n_total: int, n_groups: int
) -> np.ndarray:
    "Estimate <ZiZi+1> for each neighboring GHZ qubit pair from flat-bit snapshots."
    pairs = list(zip(ghz_qubits[:-1], ghz_qubits[1:]))
    all_est = np.column_stack(
        [
            snapshot_estimate(
                ["Z" if q in pair else "I" for q in range(n_total)], snapshots
            )
            for pair in pairs
        ]
    )
    return mom(all_est, n_groups).real
소규모 시뮬레이터 예제
먼저 상태 벡터 시뮬레이션을 사용해 10큐비트 GHZ 상태를 준비하고, 국소 파울리 섀도로 그 성질을 추정합니다. GHZ 상태는 3개 이상의 큐비트로 이루어진 최대 얽힘 양자 상태로, 다자간 얽힘의 벤치마크로 쓰입니다. 양자 통신과 암호 프로토콜의 일반적인 구성 요소이기도 합니다. 또한 GHZ 회로는 해석적 성질이 완전히 알려져 있어 이 튜토리얼에서 검증하기에 이상적입니다.
1단계: 고전적 입력을 양자 문제에 매핑하기
이상적인 10큐비트 GHZ 상태를 준비합니다.
def ghz_statevector(num_qubits):
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    for q in range(num_qubits - 1):
        qc.cx(q, q + 1)
    return Statevector(qc)

num_qubits = 10  # number of qubits
psi = ghz_statevector(num_qubits)
psi.seed(seed)
print(
    f"{num_qubits}-qubit GHZ state ready (norm = {np.linalg.norm(psi):.6f})"
)
10-qubit GHZ state ready (norm = 1.000000)
2단계: 양자 하드웨어 실행에 맞게 최적화하기
다음으로, GHZ 상태를 무작위 파울리 기저로 회전시켜 섀도 스냅샷을 수집하는 함수를 정의합니다. 이는 대규모 예제에서 Sampler 프리미티브가 하드웨어에서 수행하는 작업을 그대로 따릅니다.
def basis_circuit(b):
    """0 -> Z basis (I), 1 -> X basis (H), 2 -> Y basis (Sdg;H)."""
    qc = QuantumCircuit(1)
    if b == 1:
        qc.h(0)
    elif b == 2:
        qc.sdg(0)
        qc.h(0)
    # b == 0: Z basis, no rotation
    return qc

_basis = {
    b: basis_circuit(b) for b in (0, 1, 2)
}  # built once, shared with the estimator's _U

def collect_shadow_snapshots(psi, n_snapshots, num_qubits):
    snapshots = []
    for _ in range(n_snapshots):
        bases = rng.integers(0, 3, size=num_qubits)
        rot = QuantumCircuit(num_qubits)
        for q, b in enumerate(bases):
            rot.compose(_basis[b], qubits=[q], inplace=True)
        evolved = psi.evolve(rot)
        evolved.seed(int(rng.integers(0, 2**31)))
        bitstr = next(
            iter(evolved.sample_counts(shots=1))
        )  # Born rule internal
        bits = [int(x) for x in bitstr[::-1]]  # little-endian -> qubit
        snapshots.append((bits, bases))
    return snapshots
3단계: Qiskit 프리미티브를 사용해 실행하기
이 시뮬레이션에서는 상태 벡터를 직접 사용합니다.
n_snapshots = 5000  # number of shadow snapshots
n_groups = 20  # groups/batches for median-of-means

snapshots = collect_shadow_snapshots(psi, n_snapshots, num_qubits)
print(f"Collected {n_snapshots} snapshots.")
Collected 5000 snapshots.
4단계: 후처리하고 원하는 고전적 형식으로 결과 반환하기
섀도 추정기와 median-of-means(MOM) 추정기를 정의합니다. 이 추정기는 섀도 스냅샷을 수집하는 데 사용한 무작위 측정 기저에 대해 동작합니다. 이 함수들을 사용해 수집한 측정값으로부터 단일 큐비트 자화, 2-큐비트 상관자, 2-큐비트 RDM을 포함한 GHZ 상태의 성질을 추정합니다. 그런 다음 추정값을 정확한 값과 비교합니다.
_U = {
    b: Operator(basis_circuit(b)) for b in (0, 1, 2)
}  # rotation Uᵢ per basis
_P = {p: Operator(Pauli(p)) for p in "IXYZ"}  # single-qubit Paulis

def shadow_estimator(P, b, bit):  # P is a label char, e.g. "X"
    UPU = _U[b] @ _P[P] @ _U[b].adjoint()  # Uᵢ P Uᵢ†
    return (3 * UPU.data[bit, bit] - np.trace(_P[P].data)).real

def mom(estimates: np.ndarray, n_groups: int) -> np.ndarray:
    "Median-of-means outlier suppression."
    T = len(estimates)
    spg = T // n_groups  # shots per group
    trimmed = estimates[
        : spg * n_groups
    ]  # drop any leftover shots that don't cleanly fit into a group
    groups = trimmed.reshape(n_groups, spg, *estimates.shape[1:])
    means = groups.mean(axis=1)  # take the mean of each group
    return np.median(means.real, axis=0) + 1j * np.median(
        means.imag, axis=0
    )  # take the median of means for real and imaginary parts separately

def snapshot_estimate(
    pauli_string, snapshots
):  # full-width label, len == num_qubits
    out = np.empty(len(snapshots), dtype=complex)
    for t, (bits, bases) in enumerate(snapshots):
        e = 1.0 + 0j
        for q, P in enumerate(pauli_string):
            e *= shadow_estimator(P, bases[q], bits[q])
        out[t] = e
    return out

Z_est = np.column_stack(
    [
        snapshot_estimate(
            ["Z" if q == i else "I" for q in range(num_qubits)], snapshots
        )
        for i in range(num_qubits)
    ]
)
Z_vals = mom(Z_est, n_groups).real

ZZ_est = np.column_stack(
    [
        snapshot_estimate(
            ["Z" if q in (i, i + 1) else "I" for q in range(num_qubits)],
            snapshots,
        )
        for i in range(num_qubits - 1)
    ]
)
ZZ_nn = mom(ZZ_est, n_groups).real

ZZ_full = np.zeros((n_snapshots, num_qubits, num_qubits), dtype=complex)
for i in range(num_qubits):
    ZZ_full[:, i, i] = 1.0  # diagonal is always 1
    for j in range(i + 1, num_qubits):
        col = snapshot_estimate(
            ["Z" if q in (i, j) else "I" for q in range(num_qubits)],
            snapshots,
        )
        ZZ_full[:, i, j] = col
        ZZ_full[:, j, i] = col  # symmetric
ZZ_mat = mom(ZZ_full, n_groups).real

# 2-qubit reduced density matrix (RDM) for pair (qi, qj)
# the elementwise complex median (real/imag split) for the RDM coefficients generalizes the scalar median in Ref.[1]
qi, qj = 0, num_qubits - 1
terms = []
for a in "IXYZ":
    for b in "IXYZ":
        label = "".join({qi: a, qj: b}.get(q, "I") for q in range(num_qubits))
        c = mom(snapshot_estimate(label, snapshots).reshape(-1, 1), n_groups)[
            0
        ]
        terms.append((b + a, c / 4))
rho_shadow = SparsePauliOp.from_list(terms).to_matrix()

traced_out = [q for q in range(num_qubits) if q not in (qi, qj)]
rho_exact = partial_trace(
    psi, traced_out
).data  # diag(0.5, 0, 0, 0.5) for GHZ

print(f"{'Observable':<22} {'Estimated':>12} {'Ideal':>8} {'Max error':>12}")
print("-" * 57)
print(
    f"{'<Zi> (all qubits)':<22} {'-':>12} {'0':>8} {np.max(np.abs(Z_vals)):>12.4f}"
)
print(
    f"{'<ZiZi+1> mean':<22} {np.mean(ZZ_nn):>12.4f} {'1':>8} {np.max(np.abs(ZZ_nn - 1)):>12.4f}"
)
print(
    f"{'2-RDM Frobenius err':<22} {'-':>12} {'0':>8} {np.linalg.norm(rho_shadow - rho_exact):>12.4f}"
)
Observable                Estimated    Ideal    Max error
---------------------------------------------------------
<Zi> (all qubits)                 -        0       0.0540
<ZiZi+1> mean                1.0040        1       0.1520
2-RDM Frobenius err               -        0       0.1080
결과 시각화
첫 번째 그래프는 각 큐비트에 대해 추정한 단일 큐비트 자화 값을 보여줍니다. 두 번째 그래프는 모든 큐비트 쌍에 대해 추정한 2점 상관자 값의 분포를 보여줍니다. 마지막 그래프는 2-큐비트 축소 밀도 행렬 원소의 크기를 보여줍니다. 주어진 시스템 크기에 비해 상당히 많은 스냅샷을 사용했으므로, 결과가 정확한 값에 가깝습니다.
fig, axes = plt.subplots(
    1, 3, figsize=(14, 4), gridspec_kw={"width_ratios": [1, 1, 1]}
)

z_exact = psi.expectation_value(
    SparsePauliOp.from_sparse_list([("Z", [0], 1.0)], num_qubits)
).real  # 0.0
zz_exact = psi.expectation_value(
    SparsePauliOp.from_sparse_list([("ZZ", [0, 1], 1.0)], num_qubits)
).real  # 1.0

# <Zi>
axes[0].bar(range(num_qubits), Z_vals, color="#4a90d9", alpha=0.85)
axes[0].axhline(0, color="black", lw=0.8)
axes[0].set_ylim(-0.5, 0.5)
axes[0].set_title(r"$\langle Z_i \rangle$ (ideal = %0.2f)" % z_exact)
axes[0].set_xlabel("Qubit index")
axes[0].grid(axis="y", alpha=0.3)

# <ZiZj>
im = axes[1].imshow(ZZ_mat, vmin=-1, vmax=1, cmap="magma")
plt.colorbar(im, ax=axes[1])
axes[1].set_title(r"$\langle Z_i Z_j \rangle$ (ideal = %0.2f)" % zz_exact)
axes[1].set_xlabel("Qubit j")
axes[1].set_ylabel("Qubit i")

# 2-RDM magnitude
im2 = axes[2].imshow(np.abs(rho_shadow), vmin=0, vmax=0.5, cmap="Blues")
plt.colorbar(im2, ax=axes[2])
axes[2].set_title(r"$|\rho_2|$ for qubits (0, N-1)")
axes[2].set_xticks(range(4))
axes[2].set_yticks(range(4))
axes[2].set_xticklabels(["00", "01", "10", "11"])
axes[2].set_yticklabels(["00", "01", "10", "11"])
[Text(0, 0, '00'), Text(0, 1, '01'), Text(0, 2, '10'), Text(0, 3, '11')]

샷 스케일링 평가
이 튜토리얼에서는 관측량을 추정하기 위해 5,000개의 스냅샷을 사용합니다. 추정한 함수 중 하나의 평균 오차를 서로 다른 샷 예산에 대해 그려 섀도 단층 촬영의 샷 스케일링을 평가합니다. 2-큐비트 상관자의 오차는 평균 추정기의 표준 통계적 수렴에서 예상되는 것처럼 로 감소합니다. 섀도 단층 촬영의 중요한 점은 이 튜토리얼에서 다루는 것과 같은 국소 관측량의 경우 앞의 상수 계수가 큐비트 수에 따라 증가하지 않는다는 것입니다.
shot_counts = [100, 250, 500, 1000, 2000, 5000, 10000]
errors = []

for N_test in shot_counts:
    snaps = collect_shadow_snapshots(psi, N_test, num_qubits)
    zz_vals = []
    for i in range(num_qubits - 1):
        ests = []
        for bits, bases in snaps:
            e = 1.0 + 0j
            for q in range(num_qubits):
                op = "Z" if q in (i, i + 1) else "I"
                e *= shadow_estimator(op, bases[q], bits[q])
            ests.append(e.real)
        zz_vals.append(np.mean(ests))
    errors.append(float(np.mean(np.abs(np.array(zz_vals) - 1.0))))
    print(f"T={N_test:5d} error = {errors[-1]:.4f}")

fig, ax = plt.subplots(figsize=(6, 4))
T_arr = np.array(shot_counts, dtype=float)
ax.loglog(T_arr, errors, "o-", color="#4a90d9", lw=2, label="Shadow estimate")
ax.loglog(
    T_arr,
    errors[0] * np.sqrt(shot_counts[0] / T_arr),
    "k--",
    alpha=0.5,
    label=r"$1/\sqrt{T}$ reference",
)
ax.set_xlabel("Shots T")
ax.set_ylabel(r"Mean $|\langle Z_i Z_{i+1} \rangle - 1|$")
ax.set_title(f"Convergence for {num_qubits}-qubit GHZ")
ax.legend()
plt.tight_layout()
plt.show()
T=  100 error = 0.1856
T=  250 error = 0.1613
T=  500 error = 0.1027
T= 1000 error = 0.0827
T= 2000 error = 0.0513
T= 5000 error = 0.0311
T=10000 error = 0.0162

대규모 하드웨어 예제
앞선 시뮬레이션은 국소 Pauli 섀도 단층 촬영이 잡음 없는 상태 벡터에서 올바른 관측량을 복원함을 확인해 줍니다. 같은 프로토콜을 실제 하드웨어에서 100개 큐비트로 실행하면 시뮬레이션에는 나타나지 않는 두 가지 어려움이 생깁니다. 깊은 GHZ 회로 전반에 걸쳐 게이트 오류와 읽기 오류가 누적되며, 최적의 큐비트 배치를 찾으려면 직접 배치를 고르는 대신 장치의 커플링 그래프를 탐색해야 합니다.
첫 번째 어려움을 해결하기 위해 시공간 코드를 이용한 낮은 오버헤드 오류 검출을 사용합니다 [6]. GHZ 트리에 인접한 소수의 보조 큐비트를 패리티 검사에 사용합니다. 각 보조 큐비트는 측정 전에 인접한 GHZ 큐비트 두 개와 얽히므로, 어느 한쪽 이웃에서 비트 플립 오류가 하나만 발생해도 보조 큐비트의 결과가 0에서 1로 바뀝니다. 검사용 보조 큐비트 중 하나라도 1로 읽히는 스냅샷은 버리며, 남은 더 깨끗한 부분집합으로 를 추정합니다.
두 번째 어려움은 후보 GHZ 트리 배치를 탐색하여, 회로 깊이의 허용 가능한 증가 범위 내에서 패리티 검사 커버리지, 즉 적어도 하나의 검사로 감시되는 회로 와이어의 비율을 최대화하는 배치를 선택함으로써 해결합니다.
1-4단계(하나의 코드 블록에서 수행)
이제 동일한 4단계 워크플로를 실제 양자 하드웨어의 100큐비트 GHZ 상태에 적용하며, 시뮬레이션에서는 나타나지 않는 두 가지 하드웨어 특화 기능을 추가합니다.
-
1단계에서는 백엔드 잡음(게이트 오류, 읽기 오류, T2 시간)을 특성화하여 신뢰할 수 없는 큐비트와 에지를 회로 배치에서 제외합니다.
-
2단계에서는 가능한 GHZ 트리 배치를 탐색하여 허용 가능한 회로 깊이 내에서 패리티 검사 커버리지를 최대화하는 배치를 찾습니다. 이는 시뮬레이션에서 사용한 단순한 체인을 대체합니다.
-
3단계에서는 섀도 회로(무작위 Pauli 기저마다 하나씩)를 만들고, 하드웨어 기본 게이트로 트랜스파일한 다음,
shots=8로 Sampler 프리미티브에 제출합니다(각 회로는 서로 독립적인 비트열 8개를 생성합니다). -
4단계에서는 검사 큐비트가 모두 0으로 읽힌(검출된 오류 없음) 스냅샷만 사후 선택한 다음, 그 사후 선택을 적용했을 때와 적용하지 않았을 때의 를 추정하여 오류 검출로 인한 개선을 보여줍니다.
# ── Step 1: Map classical inputs to a quantum problem ─────────────────────────
service = QiskitRuntimeService()
backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=133
)
coupling_map = backend.target.build_coupling_map()
n_total = backend.num_qubits

thresh_cz, thresh_meas, thresh_t2 = 0.025, 0.15, 10
bad_edges = bad_cz(backend.target, threshold=thresh_cz)
bad_nodes_readout = bad_readout(backend.target, threshold=thresh_meas)
dead_qubits = bad_readout(backend.target, threshold=0.4)
bad_nodes = list(
    set(bad_nodes_readout)
    | set(bad_coherence(backend.target, threshold=thresh_t2))
)

# ── Step 2: Optimize for quantum hardware execution ───────────────────────────
# Search over starting qubits and random node-skip sets to find the GHZ layout
# with the best parity-check coverage within an acceptable circuit depth.
ghz_size = 100
max_skips, shuffles, max_depth_increase = 10, 200, 10
w_idle, w_gate = 0.2, 0.8

# Find the root that yields the shallowest GHZ — exclude bad_nodes from the start
best_root = None
base_depth = float("inf")
for root in range(backend.num_qubits):
    if root in bad_nodes:
        continue
    qc, ghz_qubits, _ = parallel_ghz(
        root, ghz_size, backend, bad_edges, bad_nodes
    )
    if len(ghz_qubits) != ghz_size:
        continue
    depth = qc.depth(lambda x: x.operation.num_qubits == 2)
    if depth < base_depth:
        best_root, base_depth = root, depth
if best_root is None:
    raise Exception(
        "No qualifying GHZ root layout found. Relax error thresholds."
    )

qc, ghz_qubits, layers = parallel_ghz(
    best_root, ghz_size, backend, bad_edges, bad_nodes
)

degree_two_nodes = [
    i
    for i in ghz_qubits
    if all(n in ghz_qubits for n in coupling_map.neighbors(i))
    and len(coupling_map.neighbors(i)) >= 2
]

best_covered_fraction = -1
best_qc = best_checks = best_parities = best_layers = best_ghz_qubits = None

for num_skips in range(max_skips):
    for _ in range(shuffles):
        skip_trial = list(
            rng.choice(degree_two_nodes, num_skips, replace=False)
        )
        qc, ghz_qubits, layers = parallel_ghz(
            best_root, ghz_size, backend, bad_edges, skip_trial + bad_nodes
        )
        if len(ghz_qubits) != ghz_size:
            continue
        depth = qc.depth(lambda x: x.operation.num_qubits == 2)
        checks, parities = [], []
        for ancilla, neighbors in get_low_overhead_ancillas(
            coupling_map, ghz_qubits
        ).items():
            if ancilla in dead_qubits:
                continue
            good_neighbors = [
                n
                for n in neighbors
                if [ancilla, n] not in bad_edges
                and [n, ancilla] not in bad_edges
            ]
            if len(good_neighbors) < 2:
                continue
            checks.append(ancilla)
            parities.append((good_neighbors[0], good_neighbors[1]))
            qc.cx(good_neighbors[0], ancilla)
            qc.cx(good_neighbors[1], ancilla)
        covered_fraction = weighted_coverage(
            layers=layers, parities=parities, w_idle=w_idle, w_gate=w_gate
        )
        if (
            covered_fraction > best_covered_fraction
            and depth <= base_depth + max_depth_increase
        ):
            best_covered_fraction = covered_fraction
            (
                best_qc,
                best_ghz_qubits,
                best_checks,
                best_parities,
                best_layers,
            ) = qc, ghz_qubits, checks, parities, layers

qc, ghz_qubits, checks, parities, layers = (
    best_qc,
    best_ghz_qubits,
    best_checks,
    best_parities,
    best_layers,
)
if len(ghz_qubits) != ghz_size:
    raise Exception("No GHZ found. Relax error thresholds.")

print(f"GHZ qubits: {ghz_qubits} ({len(ghz_qubits)})")
print(f"Check qubits: {checks} ({len(checks)})")
print(
    "Covered fraction (no idle): ",
    weighted_coverage(
        layers=layers, parities=parities, w_idle=0.0, w_gate=1.0
    ),
)

# ── Step 3: Execute using Qiskit primitives ───────────────────────────────────
# Build one shadow circuit per random Pauli basis, each repeated for shots_per_basis
# independent bitstrings. Transpile to hardware-native gates, then submit using the
# Sampler primitive. Each circuit yields shots_per_basis snapshots in that basis.
n_hw = 1000
shots_per_basis = 8  # multiple shots per basis circuit
shadow_circs, hw_bases = build_shadow_circuits(qc, n_hw, ghz_qubits, checks)
sampler = Sampler(backend)
sampler.options.environment.job_tags = ["TUT_STGHZS"]
pm = generate_preset_pass_manager(optimization_level=1, backend=backend)
isa_circuit = pm.run(shadow_circs)
job = sampler.run(isa_circuit, shots=shots_per_basis)
result = job.result()

# ── Step 4: Post-process and return result in desired classical format ─────────
# Filter snapshots whose check qubits all read 0 (no detected error), then
# estimate <ZiZi+1> with and without the error-detection postselection.
snapshots_hw = parse_hw_results_w_checks(result, hw_bases, ghz_qubits, checks)
snapshots_kept = [
    (ghz_bits, check_bits, bases)
    for (ghz_bits, check_bits, bases) in snapshots_hw
    if all(b == 0 for b in check_bits)
]
snapshots_kept_adapted = [
    (adapt_to_flat_bits(ghz_bits, ghz_qubits, n_total), bases)
    for (ghz_bits, check_bits, bases) in snapshots_kept
]
snapshots_hw_adapted = [
    (adapt_to_flat_bits(ghz_bits, ghz_qubits, n_total), bases)
    for (ghz_bits, check_bits, bases) in snapshots_hw
]

print("Shadow snapshots collected:", len(snapshots_hw))
print("Shadow snapshots kept post error-detection:", len(snapshots_kept))

n_groups = min(5, len(snapshots_kept))  # groups for median-of-means
ZZ_hw = estimate_zz_nn_hw(snapshots_hw_adapted, ghz_qubits, n_total, n_groups)
ZZ_kept = estimate_zz_nn_hw(
    snapshots_kept_adapted, ghz_qubits, n_total, n_groups
)

# Plot <ZiZi+1> before and after error detection
fig, axes = plt.subplots(1, 2, figsize=(13, 4))

axes[0].plot(ZZ_hw, "o-", color="#e05c5c", markersize=4)
axes[0].axhline(1.0, color="gray", ls="--", alpha=0.7, label="Ideal")
axes[0].set_ylim(-0.6, 3.0)
axes[0].set_title(r"$\langle Z_i Z_{i+1} \rangle$ (without error detection)")
axes[0].set_xlabel("GHZ qubit pair")
axes[0].legend()
axes[0].grid(alpha=0.3)

axes[1].plot(ZZ_kept, "o-", color="#e05c5c", markersize=4)
axes[1].axhline(1.0, color="gray", ls="--", alpha=0.7, label="Ideal")
axes[1].set_ylim(-0.6, 3.0)
axes[1].set_title(r"$\langle Z_i Z_{i+1} \rangle$ (with error detection)")
axes[1].set_xlabel("GHZ qubit pair")
axes[1].legend()
axes[1].grid(alpha=0.3)

plt.tight_layout()
plt.show()

print("Before detection: <ZiZi+1>= ", float(np.average(ZZ_hw)))
print("After detection: <ZiZi+1>= ", float(np.average(ZZ_kept)))
GHZ qubits: [57, 47, 67, 46, 66, 48, 45, 65, 49, 44, 64, 38, 43, 77, 29, 42, 85, 28, 56, 41, 84, 30, 27, 36, 86, 31, 21, 87, 32, 20, 88, 33, 22, 97, 89, 34, 23, 107, 78, 39, 35, 16, 106, 90, 69, 53, 19, 24, 3, 108, 105, 91, 70, 52, 15, 25, 2, 109, 104, 92, 71, 54, 51, 14, 4, 1, 110, 103, 98, 93, 58, 55, 13, 5, 0, 118, 96, 72, 59, 12, 6, 129, 102, 73, 11, 7, 128, 101, 74, 10, 8, 127, 100, 9, 126, 116, 125, 121, 124, 120] (100)
Check qubits: [68, 37, 50, 63, 83, 17, 26, 18, 117, 111, 75] (11)
Covered fraction (no idle):  0.5454545454545454
Shadow snapshots collected: 8000
Shadow snapshots kept post error-detection: 566
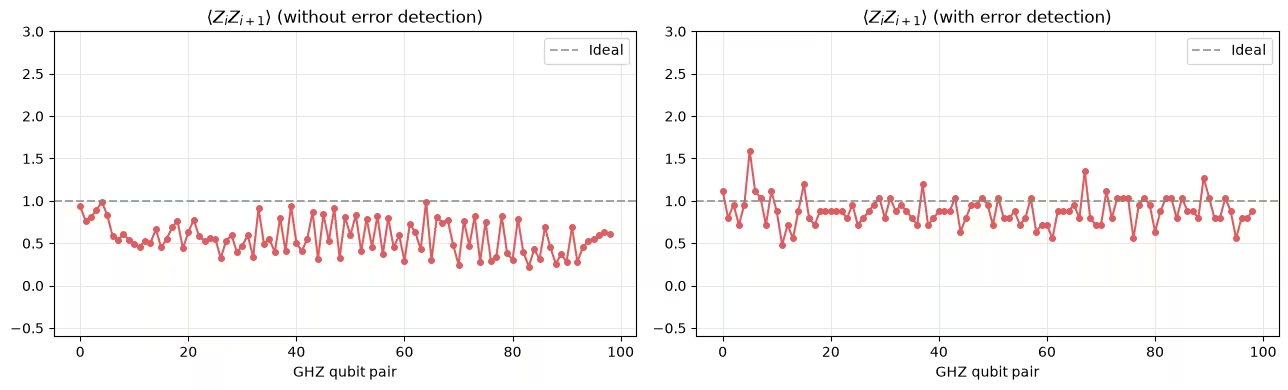
Before detection: <ZiZi+1>=  0.573749999999951
After detection: <ZiZi+1>=  0.8817377312951776
결과 해석
두 그래프는 100큐비트 GHZ 체인의 이웃한 각 큐비트 쌍에 대해, 패리티 검사로 사후 선택하기 전과 후에 섀도 단층 촬영으로 추정한 를 보여줍니다.
이상적인 GHZ 상태에서는 모든 최근접 이웃 상관자가 과 같습니다. 하드웨어에서는 잡음이 원시 추정값을 낮추고 큐비트 간 산포를 만듭니다. 오류 검출 후에는 검출 가능한 오류가 하나 이상 발생한 스냅샷이 제거되고, 남은 추정값은 분산이 줄어든 채 에 더 가까워지며, 이는 더 깨끗한 유효 상태와 일치합니다.
오류 검출 후의 개선은 검사가 실제 오류를 검출하고 있음과 일치합니다.
다음 단계
다음 자료를 살펴보며 더 알아보세요.
참고 문헌
-
[1] Huang, H. Y., Kueng, R., & Preskill, J. (2020). Predicting many properties of a quantum system from very few measurements. Nature Physics, 16, 1050–1057.
-
[2] Zhao, A., Rubin, N. C., & Miyake, A. (2021). Fermionic partial tomography via classical shadows. Phys. Rev. Lett., 127, 110504.
-
[3] Low, G. H. (2022). Classical shadows of fermions with particle number symmetry. arXiv:2208.08964.
-
[4] Bertoni, C., Haferkamp, J., Hinsche, M. et al. (2024). Shallow Shadows: Expectation Estimation Using Low-Depth Random Clifford Circuits. Phys. Rev. Lett., 133, 020602.
-
[5] Hu, H.-Y., Gu, A., Majumder, S. et al. (2025). Demonstration of robust and efficient quantum property learning with shallow shadows. Nature Communications, 16, 2943.
-
[6] Martiel, S. & Javadi-Abhari, A. (2025). Low-overhead error detection with spacetime codes. arXiv:2504.15725. © IBM Corp. 2026